In den ersten vier Teilen dieser Artikelserie haben wir das Lesen und Schreiben von Dateien behandelt, die Konstruktion von Verzeichnis- und Dateipfaden, sowie Verzeichnis- und Dateioperationen.
Gelesen und geschrieben haben wir bisher ausschließlich Byte-Arrays und Strings. In diesem fünften Teil erfährst du, wie du mit DataOutputStream und DataInputStream strukturierte Daten schreiben und lesen kannst. Im Einzelnen werden folgende Fragen beantwortet:
- Wie speichert man primitive Datentypen (int, long, char usw.) in Binärdateien und wie liest man sie wieder?
- Welche verschiedenen Arten gibt es, Strings in Binärdateien zu schreiben und sie daraus zu lesen?
Die Code-Beispiele aus diesem Artikel findest du in meinem GitHub-Repository.
Strukturierte Daten in Binärdateien schreiben und aus diesen lesen
Mit DataOutputStream und DataInputStream ist es möglich, primitive Datentypen (byte, short, int, long, float, double, boolean, char) sowie Strings in eine Binärdatei zu schreiben und diese wieder auszulesen. DataOutputStream und DataInputStream werden dabei unter Anwendung des Decorator-Patterns um einen OutputStream (z. B. FileOutputStream) bzw. um einen InputStream (z. B. FileInputStream) gewrappt.
Strukturierte Daten schreiben mit DataOutputStream
Das folgende Beispiel schreibt Variablen aller primitiven Datentypen in die Datei test1.bin:
public class TestDataOutputStream1 {
  public static void main(String[] args) throws IOException {
    try (var out = new DataOutputStream(new BufferedOutputStream(
          new FileOutputStream("test1.bin")))) {
      out.writeByte((byte) 123);
      out.writeShort((short) 1_234);
      out.writeInt(1_234_567);
      out.writeLong(1_234_567_890_123_456L);
      out.writeFloat((float) Math.E);
      out.writeDouble(Math.PI);
      out.writeBoolean(true);
      out.writeChar('€');
    }
  }
}
Die Datei test1.bin enthält nun folgende Bytes:
7b 04 d2 00 12 d6 87 00 04 62 d5 3c 8a ba c0 40 2d f8 54 40 09 21 fb 54 44 2d 18 01 20 acDie Werte wurden also im Big-Endian-Format sequenziell in die Datei geschrieben:
7b= 12304 d2= 1.23400 12 d6 87= 1.234.56700 04 62 d5 3c 8a ba c0= 1.234.567.890.123.45640 2d f8 54= 2,718281740 09 21 fb 54 44 2d 18= 3,14159265358979301= true20 ac= „€“ (Unicode U+20AC)
Strukturierte Daten lesen mit DataInputStream
Genauso einfach wie wir die Daten geschrieben haben, können wir sie auch wieder lesen:
public class TestDataInputStream1 {
  public static void main(String[] args) throws IOException {
    try (var in = new DataInputStream(new BufferedInputStream(
          new FileInputStream("test1.bin")))) {
      System.out.println(in.readByte());
      System.out.println(in.readShort());
      System.out.println(in.readInt());
      System.out.println(in.readLong());
      System.out.println(in.readFloat());
      System.out.println(in.readDouble());
      System.out.println(in.readBoolean());
      System.out.println(in.readChar());
    }
  }
}
Das Programm gibt Folgendes aus:
123
1234
1234567
1234567890123456
2.7182817
3.141592653589793
true
€
Das sind exakt die Daten, die wir geschrieben haben.
Abweichende Datentypen bei writeByte() und writeShort()
Wenn du dir die write-Methoden von DataOutputStream näher anschaust, fällt auf, dass writeByte(), writeShort() und auch writeChar() jeweils ein int als Parameter erwarten und nicht den jeweiligen Datentyp. Die Signaturen stammen aus dem Interface DataOutput; einen Grund nennt dessen Javadoc nicht, wohl aber die Konsequenz: writeByte() ignoriert die oberen 24 Bits des übergebenen Werts, writeShort() und writeChar() die oberen 16. Das ist fehleranfällig, und man sollte wissen, was passiert, wenn die übergebenen Werte nicht in den genannten Datentyp passen.
Was passiert in dem Fall? Testen wir es für writeByte() mit folgendem Code. Ich habe hier die resultierenden Bytes direkt als Kommentare in den Code eingefügt, um die Zuordnung zu erleichtern.
public class TestDataOutputStream2 {
  public static void main(String[] args) throws IOException {
    try (var out = new DataOutputStream(new BufferedOutputStream(
          new FileOutputStream("test2.bin")))) {
      out.writeByte(1000);  // --> e8
      out.writeByte(128);   // --> 80
      out.writeByte(127);   // --> 7f (Byte.MAX_VALUE)
      out.writeByte(0);     // --> 00
      out.writeByte(-128);  // --> 80 (Byte.MIN_VALUE)
      out.writeByte(-129);  // --> 7f
      out.writeByte(-1000); // --> 18
    }
  }
}
Overflows werden also nicht durch eine Fehlermeldung quittiert. Was wir stattdessen sehen, ist das letzte Byte der jeweiligen int-Darstellung der Zahl, was wir mit folgendem Code zeigen können:
public class TestDataOutputStream3 {
  public static void main(String[] args) throws IOException {
    try (var out = new DataOutputStream(new BufferedOutputStream(
          new FileOutputStream("test2.bin")))) {
      out.writeInt(1000);  // --> 00 00 03 e8
      out.writeInt(128);   // --> 00 00 00 80
      out.writeInt(127);   // --> 00 00 00 7f
      out.writeInt(0);     // --> 00 00 00 00
      out.writeInt(-128);  // --> ff ff ff 80
      out.writeInt(-129);  // --> ff ff ff 7f
      out.writeInt(-1000); // --> ff ff fc 18
    }
  }
}
Für writeShort() gilt das analog. Hier habe ich die int-Darstellung direkt mit in den Kommentar aufgenommen.
public class TestDataOutputStream4 {
  public static void main(String[] args) throws IOException {
    try (var out = new DataOutputStream(new BufferedOutputStream(
          new FileOutputStream("test2.bin")))) {
      out.writeShort(1000000);  // --> 42 40 (int: 00 0f 42 40)
      out.writeShort(32768);    // --> 80 00 (int: 00 00 80 00)
      out.writeShort(32767);    // --> 7f ff (int: 00 00 7f ff)
      out.writeShort(0);        // --> 00 00 (int: 00 00 00 00)
      out.writeShort(-32768);   // --> 80 00 (int: ff ff 80 00)
      out.writeShort(-32769);   // --> 7f ff (int: ff ff 7f ff)
      out.writeShort(-1000000); // --> bd c0 (int: ff f0 bd c0)
    }
  }
}
Beim Lesen gibt es dafür eine Entsprechung: DataInputStream bietet neben readByte() und readShort() auch readUnsignedByte() und readUnsignedShort(). Das Byte 80, das writeByte(128) geschrieben hat, liefert readByte() als -128 zurück, readUnsignedByte() dagegen als 128 – als int, denn in ein byte passt dieser Wert nicht.
Abweichender Datentyp bei writeChar()
Ein char wird in Java durch zwei Bytes repräsentiert und kann – ohne Type Casting – einem int zugewiesen werden. Folgendes ist also vollkommen in Ordnung:
int a    = 'a'; // Unicode U+0061
int euro = '€'; // Unicode U+20AC
int word = '字'; // Unicode U+5B57
Von daher ist es syntaktisch korrekt, dass writeChar() ein int entgegennimmt. Doch was passiert hier, wenn wir Werte übergeben, die größer als zwei Byte oder negativ sind? Probieren wir es aus. In den Kommentaren in folgendem Code-Beispiel siehst du die resultierenden Bytes und – bei den großen und negativen Zahlen – auch die jeweilige int-Darstellung. Auch hier sehen wir wieder, dass jeweils die letzten zwei Bytes der int-Darstellung übernommen werden.
public class TestDataOutputStream5 {
  public static void main(String[] args) throws IOException {
    try (var out = new DataOutputStream(new BufferedOutputStream(
          new FileOutputStream("test5.bin")))) {
      out.writeChar('a');  // --> 00 61
      out.writeChar('€');  // --> 20 ac
      out.writeChar('字'); // --> 5b 57

      out.writeChar(723_790_628); // --> 2b 24 (int: 2b 24 2b 24)
      out.writeChar(-100);        // --> ff 9c (int: ff ff ff 9c)
      out.writeChar(-16_776_261); // --> 03 bb (int: ff 00 03 bb)
    }
  }
}
Lesen wir die erstellte Datei mit sechs readChar()-Aufrufen wieder ein (den Code dafür findest du als TestDataInputStream5 im GitHub-Repository), bekommen wir folgende Ausgabe:
a
€
字
⬤
ワ
λ
Aus der 723.790.628 ist nun beispielsweise über die hexadezimale Darstellung 0x2b242b24 – davon die letzten zwei Bytes 0x2b24 – das Unicode-Zeichen U+2B24 (Schwarzer großer Kreis) geworden. -100 wurde über 0xffffff9c zu U+FF9C (Halbbreiter Katakana-Buchstabe Wa) und -16.776.261 wurde über 0xff0003bb zu U+03BB (Griechischer Kleinbuchstabe Lamda).
Strings schreiben mit DataOutputStream
DataOutputStream verwirrt mit drei unterschiedlichen Methoden, um Strings zu schreiben:
writeBytes(String s)writeChars(String s)writeUTF(String s)
DataInputStream hingegen bietet neben einer als deprecated markierten readLine()-Methode, die wir hier nicht weiter betrachten wollen, nur die readUTF()-Methode, um einen String zu lesen.
Wie unterscheiden sich die drei write-Methoden? Testen wir es mit einem String, der die unterschiedlichsten Arten von Zeichen enthält, die Unicode zu bieten hat:
public class TestDataOutputStream6 {
  static final String STRING = "Hello World äöü ß α € ↖ 🔥";

  public static void main(String[] args) throws IOException {
    try (var out = new DataOutputStream(new BufferedOutputStream(
          new FileOutputStream("test6.bin")))) {
      out.writeBytes(STRING);
      out.writeChars(STRING);
      out.writeUTF(STRING);
    }
  }
}
Was steht nun in der so erstellten Datei? Lesen wir ihre Bytes mit new String(bytes, charset) wieder als Text ein – einmal mit ISO_8859_1, einmal mit UTF_16BE und einmal mit UTF_8 als charset –, sieht der Inhalt wie folgt aus. Die drei Zeilen je Block entsprechen den drei write-Aufrufen; Steuerzeichen sind als Kontrollbilder dargestellt, etwa ␀ für das Nullbyte, ␃ für 0x03 und ␡ für die nicht druckbaren Zeichen 0x7F bis 0x9F.
Als ISO-8859-1 dekodiert:
Hello World äöü ß ± ¬ ␡ =%
␀H␀e␀l␀l␀o␀ ␀W␀o␀r␀l␀d␀ ␀ä␀ö␀ü␀ ␀ß␀ ␃±␀ ¬␀ !␡␀ Ø=Ý%
␀'Hello World äöü Ã␡ α â␡¬ â␡␡ í ½í´¥Als UTF-16 Big-Endian dekodiert:
䡥汬漠坯牬搠ﰠ�넠갠阠㴥
Hello World äöü ß α € ↖ 🔥
'䡥汬漠坯牬搠쎤쎶쎼鼠캱⃢芬⃢蚖⃭ꂽ�Als UTF-8 dekodiert:
Hello World ��� � � � � =%
␀H␀e␀l␀l␀o␀ ␀W␀o␀r␀l␀d␀ ␀�␀�␀�␀ ␀�␀ ␃�␀  �␀ !�␀ �=�%
␀'Hello World äöü ß α € ↖ ��
Wie die Ausgaben vermuten lassen, unterscheiden sich die Methoden durch die Zeichenkodierung, die zur Ausgabe in die Datei verwendet wird:
writeBytes()schreibt den String im ISO-8859-1-Format, auch bekannt als Latin-1. Hierbei können alle Sonderzeichen nach dem „ß“ nicht mehr dargestellt werden.writeChars()schreibt den String im UTF-16-Format. Hier werden alle Zeichen korrekt dargestellt.writeUTF()schreibt den String in einem modifizierten UTF-8-Format. Dabei werden „supplementary characters“, d. h. alle Zeichen mit einem Code größer als U+FFFF (das Sonderzeichen „🔥“ hat den Code U+1F525) anders als in UTF-8 dargestellt, weshalb der UTF-8-Dekoder hier anstatt des Feuer-Symbols zwei Ersatzzeichen „�“ liefert.
Was die drei Methoden für die vier Zeichen „ß“, „α“, „€“ und „🔥“ in die Datei schreiben, zeigt folgende Grafik – ein Kästchen pro Byte:
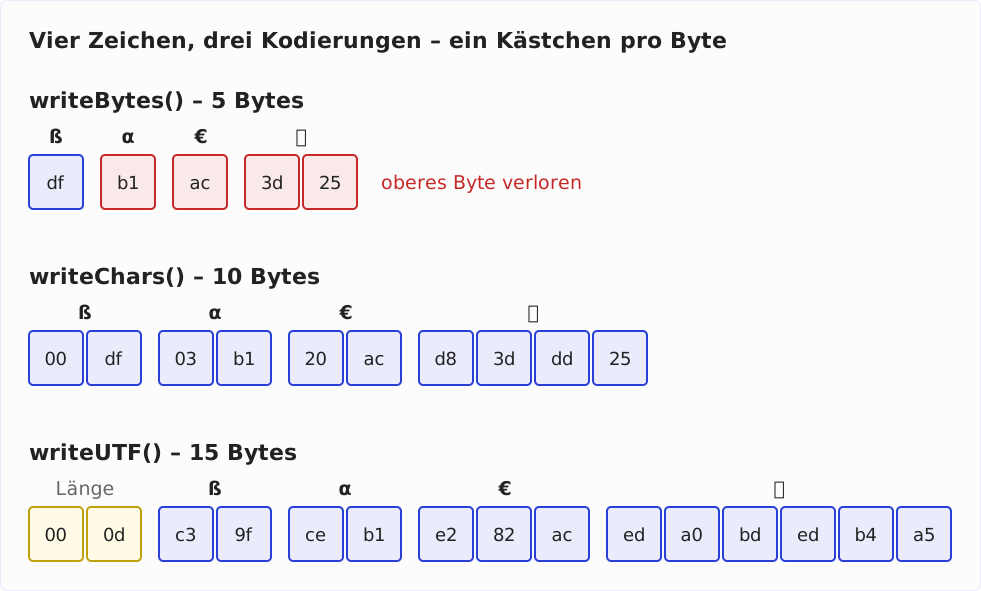
Der Inhalt der Datei wird in den folgenden Unterabschnitten erklärt.
Strings schreiben mit DataOutputStream.writeBytes()
writeBytes() hat die folgenden Bytes in die Datei geschrieben (in der ersten Zeile siehst du die hexadezimale Kodierung der Bytes, in der zweiten Zeile das jeweils geschriebene Zeichen):
48 65 6c 6c 6f 20 57 6f 72 6c 64 20 e4 f6 fc 20 df 20 b1 20 ac 20 96 20 3d 25
H  e  l  l  o     W  o  r  l  d     ä  ö  ü     ß     α     €     ↖     🔥
writeBytes() hat für jedes Zeichen ein Byte geschrieben. Jetzt sehen wir auch, was mit den Sonderzeichen passiert ist: Das α-Zeichen beispielsweise hat den Code U+03B1, davon wurde lediglich das untere Byte 0xB1 in die Datei geschrieben. In ISO-8859-1 steht 0xB1 für das Zeichen „±“, das wir oben auch sehen. Das €-Zeichen hat den Code U+20AC, davon erscheint nur 0xAC in der Datei, was in ISO-8859-1 für „¬“ steht. Der Pfeil hat den Code U+2196, dessen unteres Byte 0x96 in ISO-8859-1 ein nicht druckbares Steuerzeichen ist – oben als ␡ dargestellt.
Die Methode writeBytes() sollte also nicht verwendet werden. Es sei denn, du bist dir hundertprozentig sicher, dass dein Text ausschließlich Zeichen enthält, die durch ISO-8859-1 kodiert werden können.
Interessant ist noch das Feuer-Symbol: Dieses wird als 0x3D 0x25 in die Datei geschrieben – zwei Bytes also. Wie kann das sein, wenn writeBytes() doch für jedes Zeichen nur ein Byte schreibt?
Die Antwort lautet: Das Feuer-Symbol ist in Java nicht ein Zeichen, sondern zwei! Folgendes ist nicht erlaubt:
char c = '🔥';IntelliJ meldet dazu „Too many characters in character literal“, javac seit Java 25 „character literal contains more than one UTF-16 code unit“.
Mit folgendem Code untersuchen wir das:
public class TestDataOutputStream7 {
  public static void main(String[] args) throws IOException {
    String fire = "🔥";
    System.out.println("fire = " + fire);
    System.out.println("fire.length() = " + fire.length());

    char c0 = fire.charAt(0);
    char c1 = fire.charAt(1);
    System.out.println("fire.charAt(0) = " + c0 +
          " (hex: " + Integer.toHexString(c0) + ")");
    System.out.println("fire.charAt(1) = " + c1 +
          " (hex: " + Integer.toHexString(c1) + ")");
  }
}
Folgendes bekommen wir ausgegeben:
fire = 🔥
fire.length() = 2
fire.charAt(0) = ? (hex: d83d)
fire.charAt(1) = ? (hex: dd25)
Das Feuer-Symbol besteht also aus zwei char-Werten mit den Codes U+D83D und U+DD25. Bei diesen Codes handelt es sich nicht um eigenständige Zeichen, sondern um sogenannte Surrogates („Stellvertreter“), die verwendet werden, um Unicode-Symbole mit einem Code größer als U+FFFF darzustellen, also solche, die mit zwei Bytes nicht repräsentiert werden können.
Strings schreiben mit DataOutputStream.writeChars()
Die Methode writeChars() hat folgende Bytes in die Datei geschrieben:
00 48 00 65 00 6c 00 6c 00 6f 00 20 00 57 00 6f 00 72 00 6c 00 64 00 20
H     e     l     l     o           W     o     r     l     d

00 e4 00 f6 00 fc 00 20 00 df 00 20 03 b1 00 20 20 ac 00 20 21 96 00 20 d8 3d dd 25
ä     ö     ü           ß           α           €           ↖           🔥
Hier sehen wir für jedes Zeichen zwei Bytes – die jeweilige UTF-16-Big-Endian-Kodierung. Das Feuer-Symbol wird – wie im vorangegangenen Abschnitt erläutert – als zweimal zwei Bytes geschrieben.
Strings schreiben mit DataOutputStream.writeUTF()
Durch writeUTF() wurden folgende Bytes in die Datei geschrieben:
00 27 48 65 6c 6c 6f 20 57 6f 72 6c 64 20
      H  e  l  l  o     W  o  r  l  d

c3 a4 c3 b6 c3 bc 20 c3 9f 20 ce b1 20 e2 82 ac 20 e2 86 96 20 ed a0 bd ed b4 a5
ä     ö     ü        ß        α        €           ↖           🔥
Hier fällt zuerst auf, dass dem Text zwei Bytes 0x00 0x27 vorangehen. Das ist die Länge der kodierten Daten als vorzeichenloser 16-Bit-Wert: 0x27 ist dezimal 39 – so viele Bytes folgen auf die ersten zwei. Daraus folgt eine Grenze: Ein String, der kodiert mehr als 65.535 Bytes belegt, lässt sich mit writeUTF() nicht schreiben – die Methode wirft dann eine UTFDataFormatException.
Beim Feuer-Symbol sehen wir die oben schon erwähnte modifizierte UTF-8-Kodierung. Laut der Unicode-Tabelle von compart.com wäre die eigentliche UTF-8-Kodierung 0xF0 0x9F 0x94 0xA5. Java kocht an dieser Stelle sein eigenes Süppchen.
Strings lesen mit DataInputStream
Wie können wir nun unsere Strings wieder einlesen? Für die mit writeBytes() und writeChars() geschriebenen Strings gibt es keine entsprechenden read-Methoden. Ohnehin müssten wir, wenn wir diese Methoden verwenden wollen, zuvor die Länge des Strings in die Datei schreiben – andernfalls wüssten wir gar nicht, wo dieser endet. Hier der dafür entsprechend angepasste Code:
public class TestDataOutputStream8 {
  static final String STRING = "Hello World äöü ß α € ↖ 🔥";

  public static void main(String[] args) throws IOException {
    try (var out = new DataOutputStream(new BufferedOutputStream(
          new FileOutputStream("test8.bin")))) {
      out.writeInt(STRING.length());
      out.writeBytes(STRING);

      out.writeInt(STRING.length());
      out.writeChars(STRING);

      out.writeUTF(STRING);
    }
  }
}
Die Länge müssten wir dann wieder auslesen, danach die passende Anzahl an Bytes mit readFully() lesen und daraus – unter Angabe der korrekten Zeichenkodierung – wieder einen String konstruieren. readFully() statt read(), weil read() laut Vertrag auch weniger Bytes liefern darf als angefordert; readFully() liest, bis das Array voll ist:
public class TestDataInputStream8 {
  public static void main(String[] args) throws IOException {
    try (var in = new DataInputStream(new BufferedInputStream(
          new FileInputStream("test8.bin")))) {
      // read String written by writeBytes()
      int len = in.readInt();
      byte[] bytes = new byte[len];
      in.readFully(bytes);
      String s = new String(bytes, StandardCharsets.ISO_8859_1);
      System.out.println(s);

      // read String written by writeChars()
      len = in.readInt();
      bytes = new byte[len * 2];
      in.readFully(bytes);
      s = new String(bytes, StandardCharsets.UTF_16BE);
      System.out.println(s);

      // read String written by writeUTF()
      s = in.readUTF();
      System.out.println(s);
    }
  }
}
Hier die Ausgabe:
Hello World äöü ß ± ¬ =%
Hello World äöü ß α € ↖ 🔥
Hello World äöü ß α € ↖ 🔥Das Lesen der mit writeBytes() und writeChars() geschriebenen Strings ist recht aufwändig. writeBytes() kann darüber hinaus – wie zuvor schon festgestellt – nicht alle Zeichen kodieren, und writeChars() belegt für die meisten Texte, mit denen wir hierzulande arbeiten, knapp doppelt so viel Platz wie writeUTF().
Von daher lautet meine klare Empfehlung, für Strings ausschließlich writeUTF() und readUTF() zu verwenden.
Java-Objekte in Dateien schreiben und aus Dateien lesen
Ganze Java-Objekte schreibst du nicht mit DataOutputStream, sondern mit ObjectOutputStream, und liest sie mit ObjectInputStream wieder ein. ObjectOutputStream implementiert übrigens ebenfalls das Interface DataOutput; du kannst also auch die Methoden aus diesem Artikel darauf aufrufen.
Der nächste Teil dieser Serie, Serialisierung in Java, zeigt, wie die Serialisierung funktioniert und welche Fallstricke sie hat – von transienten Feldern, die nach dem Lesen null sind, über die serialVersionUID bis zu Deserialisierungs-Angriffen.
Zusammenfassung und Ausblick
In diesem Artikel hast du gesehen, wie du mit DataOutputStream und DataInputStream primitive Datentypen und Strings in Dateien schreiben und aus ihnen lesen kannst.
Im nächsten Teil, Serialisierung in Java, schreibst und liest du ganze Java-Objekte mit ObjectOutputStream und ObjectInputStream.
Danach stelle ich dir die in Java 1.4 eingeführten FileChannel und ByteBuffer vor. Diese beschleunigen (bei Verwendung von direkten Buffern) insbesondere das Arbeiten mit sehr großen Dateien, erlauben das Sperren von Dateibereichen („File locks“) und das Mappen von Dateien in den Speicher („memory-mapped files“), um auf diese so einfach wie auf Byte-Arrays zuzugreifen.
Hat dir dieser Artikel Zeit gespart? Dann freue ich mich, wenn du eine Minute davon in eine Bewertung auf meinem ProvenExpert-Profil investierst. Dein Feedback zeigt mir, dass sich die Arbeit an diesen Artikeln lohnt.