Die Serialisierung wandelt ein Java-Objekt in eine Folge von Bytes um, die du in eine Datei schreiben, über das Netzwerk schicken oder in einem Cache ablegen kannst. Die Deserialisierung macht aus diesen Bytes wieder ein Objekt – mit denselben Feldwerten und mit allen Objekten, auf die es verweist.
Java bringt dafür seit Java 1.1 einen eigenen Mechanismus mit: das Interface Serializable und die Klassen ObjectOutputStream und ObjectInputStream. Die Bytes, die ObjectOutputStream schreibt und ObjectInputStream liest, nenne ich in diesem Artikel Objekt-Stream – zur Unterscheidung von den Streams der Stream-API, mit denen sie nichts zu tun haben.
So schreibst du eine Bestellung in eine Datei und liest sie wieder ein:
Customer customer = new Customer("Ada Lovelace", "ada@example.com");
Order order = new Order(1001, customer);
order.addItem(new OrderItem("Notebook", 2, new BigDecimal("4.99")));
order.addItem(new OrderItem("Fountain pen", 1, new BigDecimal("39.90")));

Path file = Path.of("order.ser");

try (var out = new ObjectOutputStream(
    new BufferedOutputStream(Files.newOutputStream(file)))) {
  out.writeObject(order);
}

try (var fileIn = new BufferedInputStream(Files.newInputStream(file));
    var in = new ObjectInputStream(fileIn)) {
  Order copy = (Order) in.readObject();
  System.out.println(copy);
  System.out.println("Equal: " + copy.equals(order));
  System.out.println("Same object: " + (copy == order));
}
Order[id=1001, customer=Customer[name=Ada Lovelace, email=ada@example.com],
items=[OrderItem[product=Notebook, quantity=2, price=4.99],
OrderItem[product=Fountain pen, quantity=1, price=39.90]]]
Equal: true
Same object: falseDie Kopie ist gleich, aber nicht identisch: equals() liefert true, == liefert false. readObject() hat ein neues Objekt angelegt, mit denselben Feldwerten, demselben Kunden und beiden Bestellpositionen.
Damit das funktioniert, müssen Order, Customer und OrderItem nur das Interface Serializable implementieren. Es hat keine einzige Methode. Den Rest erledigt die JVM: Sie liest die Felder des Objekts aus, schreibt sie zusammen mit dem Klassennamen in den Objekt-Stream und setzt beim Lesen daraus ein neues Objekt zusammen.
So einfach der Einstieg ist, so viele Fallstricke hat der Mechanismus: Felder, die nach dem Lesen null sind, Objekt-Streams, die nach einer harmlosen Klassenänderung nicht mehr lesbar sind, und Objekt-Streams, die beim Lesen fremden, potentiell schadhaften Code ausführen.
In diesem Artikel erfährst du,
- wie du Objekte mit
ObjectOutputStreamschreibst und mitObjectInputStreamliest, - welche Objekte im Objekt-Stream landen und warum ein zweimal geschriebenes Objekt veraltet ankommt,
- wofür das Schlüsselwort
transientda ist und warum ein transientes Feld nach dem Lesennullist, - was die
serialVersionUIDist und welche Klassenänderungen alte Objekt-Streams unlesbar machen, - was bei einer nicht serialisierbaren Oberklasse passiert,
- wie du die Serialisierung mit
readObject(),writeObject(),readResolve()undwriteReplace()anpasst, - wie sich Records, Enums, Lambdas, innere Klassen und Collections verhalten,
- wie ein Deserialisierungs-Angriff funktioniert und wie du dich mit Filtern dagegen schützt,
- wann du statt der Java-Serialisierung ein anderes Format wählen solltest.
Wofür wird Serialisierung verwendet?
Überall, wo ein Objekt die JVM verlassen und später – oder in einer anderen JVM – wieder als Objekt auftauchen soll, kommt die Java-Serialisierung infrage. Beispiele dafür sind:
- Remote Method Invocation (RMI): Argumente und Rückgabewerte eines entfernten Methodenaufrufs werden serialisiert übertragen.
- Messaging: Eine
ObjectMessageaus dem Jakarta-Messaging-API (früher JMS) transportiert ein serialisiertes Objekt. - HTTP-Sessions: Servlet-Container speichern die Attribute einer Session serialisiert, wenn sie Sessions auf die Platte auslagern oder zwischen den Knoten eines Clusters kopieren.
- Caches, die Objekte auf die Platte schreiben oder an andere Knoten verteilen.
- Dateien, in denen eine Anwendung ihren Zustand ablegt.
Formate wie JSON oder Protocol Buffers leisten dasselbe, sind sprachunabhängig und schreiben keine Java-Klassennamen in ihre Daten. Warum das ein Vorteil ist, zeigen die Abschnitte Deserialisierungs-Angriffe und Filter und Wann du Java-Serialisierung nicht verwenden solltest.
Wer mit RMI, Sessions oder einem Framework arbeitet, das Java-Serialisierung voraussetzt, kommt an ihr aber nicht vorbei.
Die Beispiele in diesem Artikel
Die Beispiele verwenden ein kleines Bestellmodell: einen Kunden, eine Bestellposition und eine Bestellung mit beliebig vielen Positionen.
Der Kunde ist eine Klasse, deren Konstruktor die E-Mail-Adresse prüft:
public class Customer implements Serializable {

  @Serial private static final long serialVersionUID = 1L;

  private final String name;
  private final String email;

  public Customer(String name, String email) {
    if (!email.contains("@")) {
      throw new IllegalArgumentException("Invalid email: " + email);
    }
    this.name = name;
    this.email = email;
  }

  public String name() { return name; }
  public String email() { return email; }

  @Override
  public boolean equals(Object o) {
    return o instanceof Customer other
        && name.equals(other.name)
        && email.equals(other.email);
  }

  @Override
  public int hashCode() {
    return Objects.hash(name, email);
  }

  @Override
  public String toString() {
    return "Customer[name=" + name + ", email=" + email + "]";
  }
}
Die Bestellposition ist ein Record:
public record OrderItem(String product, int quantity, BigDecimal price)
    implements Serializable {}
Und die Bestellung ist wieder eine Klasse, denn sie ist veränderlich – zu ihr kommen nach und nach Bestellpositionen hinzu:
public class Order implements Serializable {

  @Serial private static final long serialVersionUID = 1L;

  private final long id;
  private final Customer customer;
  private final List<OrderItem> items = new ArrayList<>();

  public Order(long id, Customer customer) {
    this.id = id;
    this.customer = customer;
  }

  public void addItem(OrderItem item) { items.add(item); }

  public long id() { return id; }
  public Customer customer() { return customer; }
  public List<OrderItem> items() { return List.copyOf(items); }

  @Override
  public boolean equals(Object o) {
    return o instanceof Order other
        && id == other.id
        && customer.equals(other.customer)
        && items.equals(other.items);
  }

  @Override
  public int hashCode() {
    return Objects.hash(id, customer, items);
  }

  @Override
  public String toString() {
    return "Order[id=" + id + ", customer=" + customer + ", items=" + items + "]";
  }
}
Beide Klassen vergleichen in equals() alle Felder; der Record OrderItem tut das von sich aus. So lässt sich an einer Kopie prüfen, ob sie dieselben Daten trägt wie das Original.
Was die Zeile mit serialVersionUID bedeutet und warum sie in jede serialisierbare Klasse gehört, erkläre ich im Abschnitt serialVersionUID: Klassen ändern, ohne alte Objekt-Streams zu verlieren. Warum sich der Record OrderItem beim Deserialisieren anders verhält als die beiden Klassen, steht im Abschnitt Records.
Den vollständigen Code findest du im GitHub-Repository java-serialization, im Package eu.happycoders.serialization. Jeder Abschnitt hat dort eine eigene Klasse mit main()-Methode, die die gezeigten Ausgaben erzeugt. Abschnitte, die eine abgewandelte Version einer Klasse brauchen – nicht serialisierbar, ohne serialVersionUID, mit Validierung –, legen sie in einem eigenen Package ab. Lange Ausgaben gibt das Programm in einer Zeile aus; hier im Artikel sind sie für bessere Lesbarkeit umbrochen.
Objekte schreiben mit ObjectOutputStream
ObjectOutputStream ist ein OutputStream, der Objekte in Bytes übersetzt und an einen anderen OutputStream weitergibt – an einen Datei-Stream, einen Netzwerk-Socket oder, wie im folgenden Beispiel, an einen ByteArrayOutputStream.
Das folgende Programm serialisiert die Bestellung aus der Einleitung in ein Byte-Array und gibt dessen Größe und die ersten 96 Bytes als Hexdump aus:
ByteArrayOutputStream bytes = new ByteArrayOutputStream();
try (var out = new ObjectOutputStream(bytes)) {
  out.writeObject(order);
}
byte[] data = bytes.toByteArray();
System.out.println(data.length + " bytes");
HexDump.print(data, 96);
822 bytes
0000 ac ed 00 05 73 72 00 22 65 75 2e 68 61 70 70 79 ....sr."eu.happy
0010 63 6f 64 65 72 73 2e 73 65 72 69 61 6c 69 7a 61 coders.serializa
0020 74 69 6f 6e 2e 4f 72 64 65 72 00 00 00 00 00 00 tion.Order......
0030 00 01 02 00 03 4a 00 02 69 64 4c 00 08 63 75 73 .....J..idL..cus
0040 74 6f 6d 65 72 74 00 27 4c 65 75 2f 68 61 70 70 tomert.'Leu/happ
0050 79 63 6f 64 65 72 73 2f 73 65 72 69 61 6c 69 7a ycoders/serializHexDump.print() ist eine kleine Hilfsmethode aus dem Repository; sie gibt links die Bytes als Hexzahlen und rechts als Zeichen aus.
writeObject() schreibt nicht nur das Objekt selbst, sondern alles, was von ihm aus erreichbar ist: den Kunden, die Liste der Bestellpositionen, jede Bestellposition, jeden BigDecimal darin. Man spricht vom Objektgraphen.
Was im Objekt-Stream steht
Der Hexdump oben lässt sich Byte für Byte lesen:
ac edist die Kennung eines Objekt-Streams, die sogenannte Magic Number.00 05ist die Version des Formats.73leitet ein neues Objekt ein,72die Beschreibung seiner Klasse.- Danach folgen die Länge des Klassennamens (
00 22, also 34) und der Name selbst:eu.happycoders.serialization.Order. - Die nächsten acht Bytes sind die
serialVersionUIDder Klasse – hier1. - Es folgen ein Byte mit Eigenschaften der Klasse (
02für „serialisierbar“), die Anzahl der Felder (00 03) und schließlich die Felder mit Typ und Namen:Jfür daslong-FeldidundLfür das Objektfeldcustomer, dessen Typ als Zeichenkette folgt.
Ein Objekt-Stream beschreibt sich also selbst: Er enthält für jede Klasse ihren Namen, ihre Versionsnummer und die Namen und Typen ihrer Felder. Deshalb belegt die Bestellung 822 Bytes, obwohl ihre Daten – ein Name, eine E-Mail-Adresse, zwei Produkte und fünf Zahlen – in 88 Bytes passen. Diesen Vergleich und was er für die Wahl des Formats bedeutet, zeigt der Abschnitt Wann du Java-Serialisierung nicht verwenden solltest.
ObjectOutputStream implementiert übrigens auch das Interface DataOutput. Du kannst also mit writeInt(), writeUTF() usw. auch primitive Werte und Strings in denselben Objekt-Stream schreiben – so, wie es der Artikel über DataOutputStream und DataInputStream zeigt.
Puffern beim Schreiben
In der Einleitung steht zwischen dem Datei-Stream und dem ObjectOutputStream ein BufferedOutputStream. Ist das nötig?
ObjectOutputStream hat einen eigenen Puffer von 1.024 Bytes. Den leert es aber nicht nur, wenn er voll ist, sondern auch jedes Mal, wenn es zwischen Objektdaten und sogenannten Blockdaten wechselt – die schreibt z. B. die writeObject()-Methode einer ArrayList oder eines BigDecimal. Wie oft dabei der darunterliegende OutputStream aufgerufen wird, zeigt ein zählender OutputStream aus dem Repository:
var counting = new CountingOutputStream(OutputStream.nullOutputStream());
try (var out = new ObjectOutputStream(counting)) {
  out.writeObject(order);
}
System.out.println("Unbuffered: " + counting.calls() + " calls");

counting = new CountingOutputStream(OutputStream.nullOutputStream());
try (var out = new ObjectOutputStream(new BufferedOutputStream(counting))) {
  out.writeObject(order);
}
System.out.println("Buffered: " + counting.calls() + " calls");
Unbuffered: 34 calls
Buffered: 1 callsOhne Puffer kommen die 822 Bytes in 34 Aufrufen beim darunterliegenden OutputStream an. Bei einem Datei-Stream ist jeder davon ein Systemaufruf. Mit BufferedOutputStream ist es einer.
Ich empfehle deshalb, zwischen einen Datei- oder Socket-Stream und den ObjectOutputStream immer einen BufferedOutputStream zu setzen.
Objekte lesen mit ObjectInputStream
ObjectInputStream.readObject() liest das nächste Objekt aus dem Objekt-Stream und gibt es als Object zurück. Den Typ kennt der Compiler nicht – du castest ihn wie in der Einleitung, oder du prüfst ihn mit Pattern Matching:
try (var fileIn = new BufferedInputStream(Files.newInputStream(file));
    var in = new ObjectInputStream(fileIn)) {
  if (in.readObject() instanceof Order order) {
    System.out.println("Order " + order.id() + " of " + order.customer().name());
  }
}
Order 1001 of Ada LovelacereadObject() wirft zwei Checked Exceptions: eine IOException, wenn der Objekt-Stream nicht gelesen werden kann oder nicht zur Klasse passt, und eine ClassNotFoundException, wenn eine Klasse aus dem Objekt-Stream nicht auf dem Classpath liegt – z. B. weil die lesende Anwendung eine andere Version einer Bibliothek verwendet als die schreibende.
Eine Sache tut readObject() nicht: einen Konstruktor von Order oder Customer aufrufen. Die JVM legt stattdessen ein leeres Objekt an und setzt dessen Felder direkt auf die Werte aus dem Objekt-Stream – auch die finalen. Die Prüfung der E-Mail-Adresse im Konstruktor von Customer läuft beim Deserialisieren also nicht. Welche Folgen das hat und was du dagegen tun kannst, zeigen die Abschnitte Vererbung und Daten prüfen mit readObject().
Mehrere Objekte lesen
Wenn du mehrere Objekte nacheinander in einen Objekt-Stream schreibst, musst du sie in derselben Reihenfolge wieder auslesen. Wie viele es sind, steht nicht im Objekt-Stream. Am Ende wirft readObject() eine EOFException:
try (var fileIn = new BufferedInputStream(Files.newInputStream(ordersFile));
    var in = new ObjectInputStream(fileIn)) {
  while (true) {
    Order order = (Order) in.readObject();
    System.out.println("Read order " + order.id());
  }
} catch (EOFException e) {
  System.out.println("End of file");
}
Read order 1
Read order 2
Read order 3
End of fileDas funktioniert, setzt aber eine Exception als Abbruchbedingung ein. Ich empfehle, mehrere Objekte stattdessen als eine Liste zu schreiben – dann liest ein einziger readObject()-Aufruf alle:
try (var out = new ObjectOutputStream(
    new BufferedOutputStream(Files.newOutputStream(listFile)))) {
  out.writeObject(orders);
}

try (var fileIn = new BufferedInputStream(Files.newInputStream(listFile));
    var in = new ObjectInputStream(fileIn)) {
  @SuppressWarnings("unchecked")
  List<Order> copy = (List<Order>) in.readObject();
  System.out.println("Read " + copy.size() + " orders");
}
Read 2 ordersPuffern beim Lesen
Beim Lesen ist der Puffer noch wichtiger als beim Schreiben. ObjectInputStream liest außerhalb von Blockdaten jedes Byte einzeln vom darunterliegenden InputStream. Derselbe zählende Ansatz wie oben, diesmal mit einem CountingInputStream, liefert für die Bestellung:
Unbuffered: 190 calls
Buffered: 1 calls
Für 822 Bytes ruft ObjectInputStream den darunterliegenden InputStream ohne Puffer 190-mal auf, mit BufferedInputStream einmal.
Eine Datei, die kein Objekt-Stream ist
Vielleicht ist dir in den Beispielen aufgefallen, dass ich den Datei-Stream beim Lesen einer eigenen Variablen zuweise, statt ihn wie beim Schreiben direkt in den Konstruktor zu schachteln. Das hat einen Grund: Der Konstruktor von ObjectInputStream liest sofort die ersten vier Bytes und prüft, ob dort ac ed 00 05 steht.
Das folgende Beispiel öffnet eine Textdatei mit dem Inhalt „Hello, World!“:
try (var fileIn = new BufferedInputStream(Files.newInputStream(textFile));
    var in = new ObjectInputStream(fileIn)) {
  System.out.println(in.readObject());
} catch (StreamCorruptedException e) {
  System.out.println(e);
}
java.io.StreamCorruptedException: invalid stream header: 48656C6C48656C6C sind die Bytes von „Hell“ (die ersten vier Buchstaben von „Hello, World!“). Der Konstruktor wirft eine StreamCorruptedException, und es gibt keinen ObjectInputStream, den try-with-resources schließen könnte. Geschachtelt in einem Ausdruck – new ObjectInputStream(new BufferedInputStream(Files.newInputStream(file))) – bliebe auch der Datei-Stream offen, denn try-with-resources schließt nur die Ressourcen, die einer Variablen zugewiesen sind. Mit zwei Variablen schließt es den Datei-Stream auch dann, wenn der Konstruktor von ObjectInputStream scheitert.
Beim Schreiben ist die Verschachtelung unkritisch. Der Konstruktor von ObjectOutputStream schreibt zwar ebenfalls sofort die vier Bytes ac ed 00 05, aber in den BufferedOutputStream, und dort kann er nicht scheitern.
Was serialisiert wird – und was nicht
writeObject() schreibt alle Felder eines Objekts, die weder static noch transient sind – die der Klasse selbst und die aller serialisierbaren Oberklassen. Statische Felder gehören zur Klasse, nicht zum Objekt, und landen nicht im Objekt-Stream. Was transient bedeutet, zeigt der Abschnitt Felder ausschließen mit transient.
Ist ein Feld ein Objekt, serialisiert writeObject() auch dieses Objekt, und dessen Felder, und so weiter – den ganzen Objektgraphen.
Nicht serialisierbare Felder: NotSerializableException
Jedes Objekt im Objektgraphen muss serialisierbar sein. Im folgenden Beispiel hat ein Kunde eine Adresse, und die Klasse Address implementiert Serializable nicht:
public class Address {
  private final String city;
  // Konstruktor, toString()
}

public class Customer implements Serializable {
  @Serial private static final long serialVersionUID = 1L;

  private final String name;
  private final Address address;
  // Konstruktor, toString()
}
Das Serialisieren eines solchen Kunden bricht ab:
var customer = new Customer("Ada Lovelace", new Address("London"));
try (var out = new ObjectOutputStream(new ByteArrayOutputStream())) {
  out.writeObject(customer);
} catch (NotSerializableException e) {
  System.out.println(e);
}
java.io.NotSerializableException: eu.happycoders.serialization.graph.AddressDie Exception nennt die Klasse, die Serializable nicht implementiert. Es gibt zwei Auswege: Du machst Address serialisierbar, oder du schließt das Feld address mit transient aus.
Die Prüfung findet erst zur Laufzeit statt. Der Compiler weist dich nicht darauf hin, dass ein Feld einer serialisierbaren Klasse einen nicht serialisierbaren Typ hat – es sei denn, du kompilierst mit -Xlint:serial; mehr dazu im Abschnitt Fehldeklarationen finden.
Geteilte Referenzen
Was passiert, wenn zwei Bestellungen denselben Kunden haben? Das folgende Beispiel schreibt eine Liste mit zwei Bestellungen von Ada Lovelace und prüft nach dem Lesen, ob beide Bestellungen auf dasselbe Customer-Objekt verweisen:
Customer ada = new Customer("Ada Lovelace", "ada@example.com");
List<Order> orders = List.of(new Order(1, ada), new Order(2, ada));

ByteArrayOutputStream bytes = new ByteArrayOutputStream();
try (var out = new ObjectOutputStream(bytes)) {
  out.writeObject(orders);
}

try (var in = new ObjectInputStream(new ByteArrayInputStream(bytes.toByteArray()))) {
  List<Order> copy = (List<Order>) in.readObject();
  System.out.println("Same customer: "
      + (copy.get(0).customer() == copy.get(1).customer()));
}
Same customer: trueDas Customer-Objekt wird nur einmal geschrieben, und nach dem Lesen teilen sich beide Bestellungen wieder ein Objekt. Das liegt an einer Tabelle, die ObjectOutputStream führt: Jedes geschriebene Objekt bekommt dort eine Nummer, ein sogenanntes Handle. Trifft writeObject() auf ein Objekt, das schon in der Tabelle steht, schreibt es statt des Objekts nur einen Rückverweis auf dessen Handle. ObjectInputStream führt die gleiche Tabelle und löst den Rückverweis wieder auf das schon gelesene Objekt auf.
Die folgende Grafik zeigt den Ablauf für die beiden Bestellungen. Links stehen die Objekte vor dem Schreiben, in der Mitte die Einträge im Objekt-Stream in der Reihenfolge, in der writeObject() sie schreibt, und rechts die Objekte nach dem Lesen. Die Strings und die Listen mit den Bestellpositionen lässt die Grafik weg. Das Customer-Objekt steht im Objekt-Stream nur einmal, für die zweite Bestellung folgt ein Rückverweis darauf:
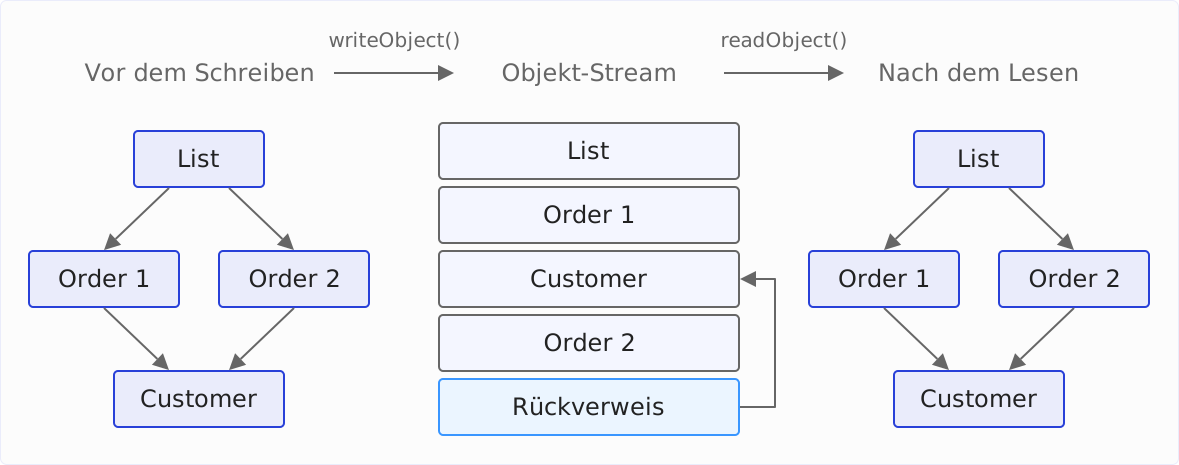
Die Tabelle gilt für den ganzen Objekt-Stream, nicht nur für einen writeObject()-Aufruf. Schreibst du die beiden Bestellungen mit zwei Aufrufen von writeObject() in denselben Objekt-Stream, kommt ebenfalls „Same customer: true“ heraus.
Dasselbe Objekt zweimal schreiben: reset() und writeUnshared()
Die Handle-Tabelle hat eine Kehrseite. Das folgende Beispiel schreibt eine Bestellung, fügt ihr eine zweite Bestellposition hinzu und schreibt sie erneut in denselben Objekt-Stream:
Order order = new Order(1001, ada);
order.addItem(new OrderItem("Notebook", 2, new BigDecimal("4.99")));

ByteArrayOutputStream bytes = new ByteArrayOutputStream();
try (var out = new ObjectOutputStream(bytes)) {
  out.writeObject(order);
  order.addItem(new OrderItem("Fountain pen", 1, new BigDecimal("39.90")));
  out.writeObject(order);
}
Das Programm liest anschließend beide Objekte und gibt die Zahl ihrer Bestellpositionen aus:
First:  1 items
Second: 1 items
Same object: true
Die zweite Bestellposition fehlt. Der zweite writeObject()-Aufruf hat die Bestellung in der Tabelle gefunden und nur einen Rückverweis geschrieben – mit dem Stand vom ersten Aufruf. Eine Exception gibt es nicht. Dieser Fehler fällt erst auf, wenn jemand die Daten vergleicht.
Gefährdet ist jedes Programm, das einen Objekt-Stream lange offen hält und dieselben Objekte mehrfach schreibt – etwa, um über einen Socket immer wieder den aktuellen Stand eines Objekts zu schicken.
ObjectOutputStream.reset() leert die Tabelle. Danach schreibt writeObject() jedes Objekt wieder vollständig:
try (var out = new ObjectOutputStream(bytes)) {
  out.writeObject(order);
  order.addItem(new OrderItem("Fountain pen", 1, new BigDecimal("39.90")));
  out.reset();
  out.writeObject(order);
}
First: 1 items
Second: 2 items
Same object: falseDie zweite Kopie hat jetzt beide Bestellpositionen.
Naheliegend wäre auch writeUnshared() statt reset(). Laut Javadoc schreibt diese Methode ein Objekt als neues Objekt, auch wenn es schon im Objekt-Stream steht. Das Ergebnis:
First:  1 items
Second: 1 items
Same object: false
Die Bestellung selbst kommt zwar als neues Objekt an, hat aber wieder nur eine Bestellposition. writeUnshared() gilt nur für das Objekt selbst, nicht für die Objekte, auf die es verweist – und die Liste der Bestellpositionen ist ein Rückverweis auf die Liste vom ersten Aufruf.
Die folgende Grafik stellt die drei Varianten nebeneinander. Jede Spalte zeigt die Einträge im Objekt-Stream, über jeder Gruppe den Aufruf, der sie geschrieben hat; ein Rückverweis zeigt mit einem Pfeil auf den Eintrag, auf den er verweist. Die Bestellpositionen selbst lässt die Grafik weg, die Liste trägt nur ihre Anzahl. Unten steht, was beim Lesen als zweites Objekt herauskommt – „dasselbe“ und „dieselbe“ heißen dort: dasselbe Objekt wie beim ersten gelesenen.
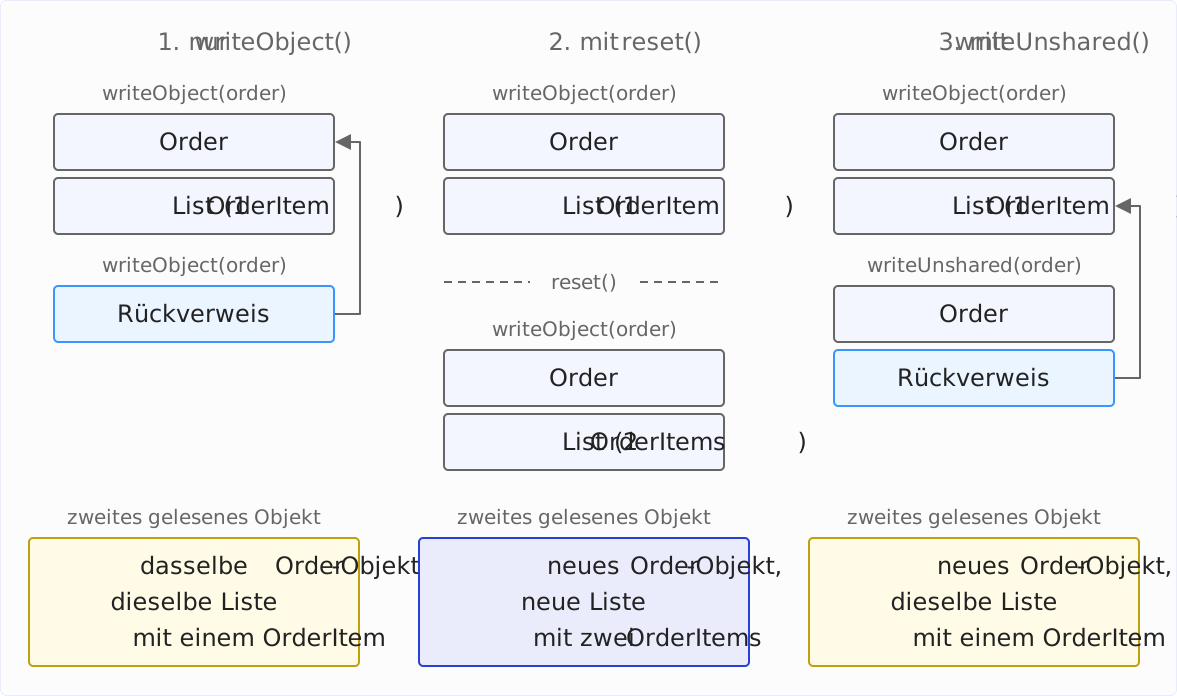
Ich empfehle deshalb reset(). Bei langlebigen Objekt-Streams hat es einen zweiten Nutzen: Die Handle-Tabelle hält Referenzen auf alle geschriebenen Objekte, und solange ein Objekt in der Tabelle steht, kann der Garbage Collector es nicht entfernen. Ein Objekt-Stream, der stundenlang Objekte schreibt, ohne reset() aufzurufen, hält sie alle im Speicher.
Felder ausschließen mit transient
Ein Feld mit dem Modifier transient wird von writeObject() nicht in den Objekt-Stream geschrieben. Typische Fälle dafür sind:
- Der Wert lässt sich aus anderen Feldern berechnen, z. B. ein zwischengespeicherter Gesamtbetrag.
- Der Wert ist nicht serialisierbar, z. B. ein Listener, eine Datenbankverbindung oder ein
Thread. - Der Wert soll die JVM nicht verlassen, z. B. ein Passwort.
Die folgende Variante der Bestellung hat zwei transiente Felder: einen zwischengespeicherten Gesamtbetrag (total) und eine Liste von Listenern (listeners), die bei jeder neuen Bestellposition benachrichtigt werden. Die Listener sind Lambdas, und die sind nicht serialisierbar – ohne transient bräche writeObject() daher mit einer NotSerializableException ab.
public class Order implements Serializable {

  @Serial private static final long serialVersionUID = 1L;

  private final long id;
  private final List<OrderItem> items = new ArrayList<>();

  private transient BigDecimal total;
  private transient List<Consumer<Order>> listeners = new ArrayList<>();

  public Order(long id) {
    this.id = id;
  }

  public void addItem(OrderItem item) {
    items.add(item);
    total = null;
    for (Consumer<Order> listener : listeners) {
      listener.accept(this);
    }
  }

  public void onChange(Consumer<Order> listener) {
    listeners.add(listener);
  }

  public BigDecimal total() {
    if (total == null) {
      total = items.stream()
          .map(item -> item.price().multiply(BigDecimal.valueOf(item.quantity())))
          .reduce(BigDecimal.ZERO, BigDecimal::add);
    }
    return total;
  }

  public long id() { return id; }
}
Das folgende Programm registriert einen Listener, fügt eine Bestellposition hinzu, kopiert die Bestellung per Serialisierung und fügt der Kopie eine weitere Bestellposition hinzu. copy() ist eine Hilfsmethode aus dem Repository, die ein Objekt serialisiert und sofort wieder deserialisiert.
Order order = new Order(1001);
order.onChange(o -> System.out.println("Order " + o.id() + " changed"));
order.addItem(new OrderItem("Notebook", 2, new BigDecimal("4.99")));
System.out.println("Total: " + order.total());

Order copy = copy(order);
System.out.println("Total: " + copy.total());
copy.addItem(new OrderItem("Fountain pen", 1, new BigDecimal("39.90")));
Order 1001 changed
Total: 9.98
Total: 9.98
java.lang.NullPointerException: Cannot invoke "java.util.List.iterator()" because "this.listeners" is nullDer Gesamtbetrag ist nach dem Lesen null, und total() berechnet ihn neu. Für ein Feld, das sich bei Bedarf selbst berechnet, ist transient also unproblematisch.
Die Liste der Listener ist nach dem Lesen ebenfalls null – obwohl das Feld mit new ArrayList<>() initialisiert wird. Ein Feld-Initializer läuft im Konstruktor, und die Deserialisierung ruft den Konstruktor von Order nicht auf. Ein transientes Feld hat nach dem Lesen deshalb immer seinen Default-Wert: null, 0 oder false.
Für Felder, die einen Startwert brauchen, schreibst du eine readObject()-Methode. Die JVM ruft sie beim Deserialisieren statt des Standardablaufs auf:
@Serial
private void readObject(ObjectInputStream in)
    throws IOException, ClassNotFoundException {
  in.defaultReadObject();
  listeners = new ArrayList<>();
}
in.defaultReadObject() liest die Felder wie bisher aus dem Objekt-Stream. Danach setzt die Methode die Liste der Listener auf eine leere Liste. Dafür darf das Feld nicht final sein, denn ein finales Feld lässt sich nur im Konstruktor zuweisen.
Mit der zusätzlichen readObject()-Methode läuft das Beispiel durch. Das folgende Programm geht wie das erste vor, registriert nach dem Kopieren aber zusätzlich einen eigenen Listener an der Kopie:
Order order = new Order(1001);
order.onChange(o -> System.out.println("Order " + o.id() + " changed"));
order.addItem(new OrderItem("Notebook", 2, new BigDecimal("4.99")));

Order copy = copy(order);
copy.onChange(o -> System.out.println("Copy " + o.id() + " changed"));
copy.addItem(new OrderItem("Fountain pen", 1, new BigDecimal("39.90")));
System.out.println("Total: " + copy.total());
Order 1001 changed
Copy 1001 changed
Total: 49.88Bei der ersten Bestellposition meldet sich der Listener des Originals, bei der zweiten nur der Listener der Kopie. Der Listener des Originals ist auf der Kopie nicht registriert, denn die Liste listeners ist transient und nach dem Lesen durch readObject() eine neue leere Liste. Wer auf Änderungen der Kopie reagieren will, muss seine Listener an der Kopie erneut registrieren.
Was readObject() sonst noch kann, zeigt der Abschnitt Serialisierung anpassen.
serialVersionUID: Klassen ändern, ohne alte Objekt-Streams zu verlieren
Ein Objekt-Stream enthält zu jeder Klasse eine Versionsnummer, die serialVersionUID. Beim Lesen vergleicht ObjectInputStream sie mit der serialVersionUID der Klasse, die gerade auf dem Classpath liegt. Weichen die beiden ab, wirft es eine InvalidClassException.
Die Versionsnummer schützt davor, Daten in eine Klasse zu lesen, die nicht mehr zu ihnen passt. Wie zuverlässig sie das tut, hängt davon ab, wer sie festlegt. Berechnet die JVM sie, wechselt sie auch dann, wenn eine Klassenänderung die Daten gar nicht betrifft. Legst du sie selbst fest, entscheidest du, wann alte Objekt-Streams ungültig werden.
Die berechnete serialVersionUID
Deklariert eine Klasse keine serialVersionUID, berechnet die JVM sie beim ersten Serialisieren. Sie bildet einen Hashwert aus dem Klassennamen, den Interfaces, allen Feldern außer den privaten statischen und privaten transienten, dem statischen Initializer sowie allen nicht-privaten Konstruktoren und Methoden. Jede Änderung an einem dieser Teile ergibt eine andere Versionsnummer.
Das Beispiel-Repository enthält drei Versionen der Klasse Customer ohne serialVersionUID:
- die Ausgangsversion mit den Feldern
nameundemail, - dieselbe Klasse mit einer zusätzlichen Methode
name(), - die Ausgangsversion mit einer zusätzlichen Zeile
assert email.contains("@");im Konstruktor.
ObjectStreamClass.lookup(type).getSerialVersionUID() liefert die berechneten Versionsnummern:
v1: 7580027934406189969
v2: 3508356520794417061
v3: -5861632015059223385
Alle drei sind verschieden – auch die dritte, obwohl die Klasse dort weder ein neues Feld noch eine neue Methode hat. Für ein assert erzeugt javac aber ein verstecktes statisches Feld $assertionsDisabled und einen statischen Initializer, der es setzt, und beide gehen in den Hashwert ein. Davor warnt auch das Javadoc von Serializable: Die berechnete Versionsnummer reagiere empfindlich auf Details, die vom Compiler abhängen.
Schreibst du mit der ersten Version der Customer-Klasse einen Kunden in einen Objekt-Stream und liest ihn mit der zweiten Version der Klasse wieder ein, scheitert das Lesen:
java.io.InvalidClassException: eu.happycoders.serialization.versioning.implicit.v2.Customer;
 local class incompatible: stream classdesc serialVersionUID = 7580027934406189969,
 local class serialVersionUID = 3508356520794417061
Die neue Methode name() ändert nichts an den Daten. Trotzdem ist jeder Objekt-Stream, der mit der alten Version der Klasse geschrieben wurde, mit der neuen Version unlesbar.
Die serialVersionUID selbst festlegen
Ich empfehle, in jeder serialisierbaren Klasse eine serialVersionUID zu deklarieren, so wie in den Beispielklassen:
@Serial private static final long serialVersionUID = 1L;Das Feld muss static, final und vom Typ long sein; zusätzlich empfiehlt das Javadoc private. Die Annotation @Serial gibt es seit Java 14. Sie kennzeichnet das Feld als Teil der Serialisierung, damit niemand es für ungenutzt hält und löscht.
Der Wert selbst ist beliebig. Für die erste Version der Klasse ist 1L ein guter Startwert. Erhöhe ihn nur, wenn sich die Klasse so ändert, dass alte Objekt-Streams nicht mehr gelesen werden sollen.
Ist eine Klasse ohne serialVersionUID schon im Einsatz und gibt es Objekt-Streams von ihr, übernimmst du die berechnete Versionsnummer. Das JDK-Werkzeug serialver gibt sie aus:
$ serialver -classpath target/classes eu.happycoders.serialization.versioning.implicit.v1.Customer
eu.happycoders.serialization.versioning.implicit.v1.Customer:
    private static final long serialVersionUID = 7580027934406189969L;
Mit dieser Zeile in der Klasse bleiben die alten Objekt-Streams lesbar, und für weitere Änderungen gelten die Regeln aus dem nächsten Abschnitt.
Kompatible und inkompatible Klassenänderungen
Mit einer festen serialVersionUID vergleicht ObjectInputStream die Felder im Objekt-Stream mit denen der Klasse, und zwar über ihre Namen.
Die folgende Grafik zeigt das für einen Objekt-Stream der ersten Version von Customer mit den Feldern name und email, gelesen mit einer Version, in der email in emailAddress umbenannt ist, die Versionsnummer aber nicht verändert wurde. Links stehen die Angaben im Objekt-Stream, in der Mitte die der aktuellen Klasse und rechts das Ergebnis beim Lesen. Ein gestrichelter Rahmen steht für ein Feld, das auf einer Seite fehlt:
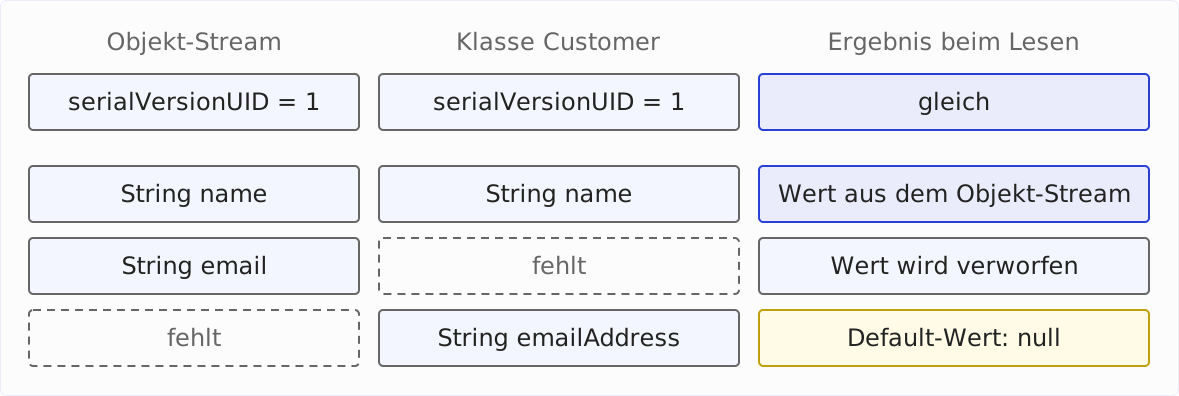
Die Versionsnummern stimmen überein, also gleicht ObjectInputStream die Felder ab. name steht auf beiden Seiten und bekommt seinen Wert aus dem Objekt-Stream. Für email gibt es in der aktuellen Klasse kein Feld, der Wert wird verworfen. Und emailAddress steht nicht im Objekt-Stream, das Feld bekommt seinen Default-Wert null.
Die folgende Tabelle zeigt, was bei verschiedenen Änderungen an der Klasse beim Lesen eines alten Objekt-Streams passiert. Jede Zeile stammt aus einem Lauf des Programms aus dem Beispiel-Repository: Es schreibt mit einer Version von Customer und liest mit einer anderen Version.
| Änderung an der Klasse | Ergebnis beim Lesen eines alten Objekt-Streams |
|---|---|
| Feld hinzugefügt | Das neue Feld hat seinen Default-Wert |
| Feld entfernt | Der Wert im Objekt-Stream wird verworfen |
| Feld umbenannt | Das umbenannte Feld ist null, der alte Wert wird verworfen – ohne Fehlermeldung |
| Typ eines Objektfelds geändert | ClassCastException, sobald im Objekt-Stream ein Wert steht |
| Typ eines primitiven Felds geändert | InvalidClassException |
| Methode hinzugefügt oder geändert | keine Auswirkung |
Zwei Zeilen brauchen eine Erklärung.
Ein umbenanntes Feld ist für die Serialisierung ein entferntes und ein neues Feld, wie die Grafik oben zeigt. Der Wert geht verloren, ohne dass eine Exception fliegt. Die Ausgabe nach dem Umbenennen von email in emailAddress:
Customer[name=Ada Lovelace, emailAddress=null]Ändert sich der Typ eines Objektfelds, prüft ObjectInputStream den Typ erst beim Zuweisen des Werts. In der folgenden Version von Customer ist aus String email ein Record EmailAddress email geworden:
public record EmailAddress(String value) implements Serializable {}

public class Customer implements Serializable {
  @Serial private static final long serialVersionUID = 1L;

  private final String name;
  private final EmailAddress email;  // vorher: String email
  // Konstruktor, toString()
}
Ein Objekt-Stream der ersten Version lässt sich damit nicht mehr lesen:
java.lang.ClassCastException: cannot assign instance of java.lang.String to field
 eu.happycoders.serialization.versioning.explicit.v4.Customer.email
 of type eu.happycoders.serialization.versioning.explicit.v4.EmailAddress
 in instance of eu.happycoders.serialization.versioning.explicit.v4.Customer
Steht im Objekt-Stream für dieses Feld null, gibt es keine Exception. Ob ein alter Objekt-Stream lesbar ist, hängt damit von seinen Daten ab.
Meine Empfehlung: Felder hinzufügen ist unproblematisch, alles andere prüfst du am besten mit einem alten Objekt-Stream, bevor die neue Version live geht. Und wenn eine Änderung alte Objekt-Streams unbrauchbar macht, erhöhst du die serialVersionUID – eine InvalidClassException ist besser als stillschweigend falsche Daten.
Sollen alte Objekt-Streams trotz der Änderung lesbar bleiben, lässt du die serialVersionUID dagegen gleich und fängst die Änderung in readObject() ab. Wie das für ein umbenanntes Feld geht, zeigt der Abschnitt Umbenannte Felder übernehmen mit readFields(). Beides zusammen geht nicht: ObjectInputStream vergleicht die Versionsnummern, bevor es readObject() aufruft.
Fehldeklarationen finden: -Xlint:serial, JFR und @Serial
Die Felder und Methoden, mit denen eine Klasse ihre Serialisierung steuert – die serialVersionUID und Methoden wie readObject() aus dem Abschnitt Serialisierung anpassen –, findet die JVM über deren Namen und Signaturen. Ein Tippfehler oder ein falscher Typ führt nicht zu einem Fehler, sondern dazu, dass die JVM die Deklaration ignoriert.
Die folgende Klasse deklariert ihre serialVersionUID als int:
public class Customer implements Serializable {
  private static final int serialVersionUID = 1;
  // ...
}
Die JVM sucht ein Feld vom Typ long, findet keins und berechnet die Versionsnummer selbst – mit allen Folgen aus dem Abschnitt Die berechnete serialVersionUID.
Es gibt zwei Werkzeuge, die solche Fehler melden. Das erste ist der Compiler mit der Option -Xlint:serial:
$ javac -Xlint:serial Customer.java
Customer.java:8: warning: [serial] serialVersionUID must be of type long in class Customer
  private static final int serialVersionUID = 1;
                           ^
Seit Java 18 prüft -Xlint:serial mehr als vorher, darunter falsch deklarierte Serialisierungsmethoden und Felder mit nicht serialisierbarem Typ (JDK-8202056, JDK-8160675). Fehlt eine serialVersionUID, warnt es ebenfalls.
Das zweite Werkzeug ist der JDK Flight Recorder. Seit Java 23 meldet er falsch deklarierte Serialisierungsfelder und -methoden zur Laufzeit als Event jdk.SerializationMisdeclaration – einmal pro Klasse, wenn sie zum ersten Mal serialisiert wird. Das Event ist in der Einstellung profile aktiviert, in der Standardeinstellung default nicht:
$ java -XX:StartFlightRecording:settings=profile,filename=misdeclaration.jfr ...
$ jfr print --events jdk.SerializationMisdeclaration misdeclaration.jfr
jdk.SerializationMisdeclaration {
  startTime = 09:29:12.931 (2026-10-14)
  misdeclaredClass = eu.happycoders.serialization.versioning.misdeclared.Customer (classLoader = app)
  message = "serialVersionUID must be of type long"
}
Das hilft bei Klassen aus Bibliotheken, deren Quellcode du nicht kompilierst.
Und @Serial? Laut Javadoc soll die Annotation es Compilern ermöglichen, falsch deklarierte Serialisierungsmember zu finden – so wie @Override falsch überschriebene Methoden findet. javac nutzt das bis einschließlich Java 27 nicht: Eine mit @Serial annotierte, falsch geschriebene Methode readObjekt() (mit k statt mit c) kompiliert auch mit -Xlint:serial ohne Warnung. Die Annotation dokumentiert also vor allem; die Prüfung übernimmt -Xlint:serial, mit oder ohne @Serial.
Vererbung: nicht serialisierbare Oberklassen
Implementiert eine Klasse Serializable, sind auch alle ihre Unterklassen serialisierbar, und writeObject() schreibt die Felder der ganzen Hierarchie.
Anders sieht es aus, wenn die Oberklasse nicht serialisierbar ist. Im folgenden Beispiel erbt der Kunde seine ID von einer Klasse Entity, die Serializable nicht implementiert. Beide Konstruktoren geben aus, wann sie laufen:
public class Entity {

  private long id;

  public Entity() {
    System.out.println("Entity() called");
  }

  public Entity(long id) {
    this.id = id;
  }

  public long id() { return id; }
}

public class Customer extends Entity implements Serializable {

  @Serial private static final long serialVersionUID = 1L;

  private final String name;

  public Customer(long id, String name) {
    super(id);
    this.name = name;
    System.out.println("Customer(id, name) called");
  }

  @Override
  public String toString() {
    return "Customer[id=" + id() + ", name=" + name + "]";
  }
}
Das folgende Programm legt einen Kunden mit der ID 42 an, serialisiert ihn und liest ihn wieder ein:
Customer customer = new Customer(42, "Ada Lovelace");
System.out.println("Before: " + customer);
byte[] data = serialize(customer);
System.out.println("-- reading");
Object copy = deserialize(data);
System.out.println("After:  " + copy);
serialize() und deserialize() sind zwei Hilfsmethoden aus dem Repository: Die erste schreibt ein Objekt mit ObjectOutputStream in ein Byte-Array, die zweite liest es mit ObjectInputStream wieder daraus. Die Ausgabe:
Customer(id, name) called
Before: Customer[id=42, name=Ada Lovelace]
-- reading
Entity() called
After:  Customer[id=0, name=Ada Lovelace]
Die ID ist verloren. writeObject() schreibt nur die Felder der serialisierbaren Klassen, also name, aber nicht id.
Beim Lesen ruft ObjectInputStream den parameterlosen Konstruktor der ersten nicht serialisierbaren Oberklasse auf – hier Entity(). Er initialisiert die Felder dieser Oberklasse, die Felder der serialisierbaren Klassen darunter setzt ObjectInputStream danach aus dem Objekt-Stream. Bei einer Klasse, die direkt von Object erbt, ist dieser Konstruktor Object(). Beim Deserialisieren von Order und Customer aus den vorherigen Beispielen läuft deshalb nur der Konstruktor von Object, keiner der eigenen.
Der parameterlose Konstruktor muss erreichbar sein: public oder protected, oder ohne Modifier, wenn die Oberklasse im selben Package liegt. Hat die Oberklasse keinen solchen Konstruktor, kannst du ein Objekt zwar schreiben, aber nicht mehr lesen. In der folgenden Variante hat Entity nur den Konstruktor mit der ID:
public class Entity {

  private final long id;

  public Entity(long id) {
    this.id = id;
  }

  public long id() { return id; }
}
Customer bleibt wie oben, nur ohne die Ausgabe im Konstruktor. Das folgende Programm schreibt einen Kunden und versucht, ihn wieder zu lesen:
Customer customer = new Customer(42, "Ada Lovelace");
byte[] data = serialize(customer);
System.out.println(data.length + " bytes written");
try {
  deserialize(data);
} catch (InvalidClassException e) {
  System.out.println(e);
}
Das Schreiben gelingt, das Lesen scheitert:
123 bytes written
java.io.InvalidClassException: eu.happycoders.serialization.inheritance.nodefault.Customer;
 no valid constructor
Wenn die Oberklasse dir gehört, machst du sie serialisierbar. Wenn nicht, hängt der Ausweg von ihrem Konstruktor ab:
- Hat sie einen erreichbaren parameterlosen Konstruktor, schreibst du ihren Zustand mit
writeObject()selbst in den Objekt-Stream und liest ihn mitreadObject()wieder aus – wie das geht, zeigt der Abschnitt Zusätzliche Daten schreiben mitwriteObject(). - Hat sie keinen, helfen
writeObject()undreadObject()nicht: Beim Lesen brichtObjectInputStreamab, bevor es diereadObject()-Methode der Klasse aufrufen kann. Dann schreibst du statt des Kunden einen Stellvertreter (Proxy), der ihn beim Lesen über seinen normalen Konstruktor wieder aufbaut – das zeigt der Abschnitt Das Serialization-Proxy-Muster mitwriteReplace().
Serialisierung anpassen: readObject(), writeObject(), readResolve(), writeReplace()
Eine serialisierbare Klasse kann den Standardablauf mit fünf Methoden anpassen. Die JVM findet sie über Name und Signatur:
| Methode | Aufgerufen | Zweck |
|---|---|---|
private voidwriteObject(ObjectOutputStream) | beim Schreiben, statt des Standardablaufs | zusätzliche oder andere Daten schreiben |
private voidreadObject(ObjectInputStream) | beim Lesen, statt des Standardablaufs | Daten prüfen, transiente Felder setzen, alte Felder übernehmen |
private voidreadObjectNoData() | beim Lesen eines Objekt-Streams, der noch ohne diese Oberklasse geschrieben wurde | Felder der Oberklasse vorbelegen |
Object writeReplace() | vor dem Schreiben | ein anderes Objekt schreiben |
Object readResolve() | nach dem Lesen | das gelesene Objekt ersetzen |
writeReplace() und readResolve() dürfen jeden Zugriffsmodifier haben, die drei anderen müssen private sein.
Ein Beispiel für readObjectNoData(): Erbt Customer von einer Oberklasse Entity, die in einer früheren Version noch nicht existierte oder noch nicht serialisierbar war, enthält ein Objekt-Stream dieser früheren Version keine Daten für Entity. Beim Lesen ruft ObjectInputStream dann statt der readObject()-Methode von Entity deren readObjectNoData() auf – sofern Entity eine hat; sonst behalten die Felder von Entity ihre Default-Werte.
Daten prüfen mit readObject()
Der Konstruktor von Customer aus den Beispielen lehnt eine E-Mail-Adresse ohne „@“ ab. Weil die Deserialisierung den Konstruktor nicht aufruft, greift diese Prüfung dabei nicht. Liest ein Programm einen Objekt-Stream, in dem ein Kunde mit der E-Mail-Adresse „no email“ steht, gibt es den Kunden so aus:
Customer[name=Ada, email=no email]Geschrieben wurde der Objekt-Stream mit einer gleichnamigen Klasse ohne Prüfung im Konstruktor, nach dem Verfahren aus der Hinweisbox im Abschnitt Die berechnete serialVersionUID. Ein Angreifer kann einen solchen Objekt-Stream ebenso gut von Hand bauen.
Eine readObject()-Methode prüft die gelesenen Daten wie der Konstruktor:
public Customer(String name, String email) {
  if (!isValidEmail(email)) {
    throw new IllegalArgumentException("Invalid email: " + email);
  }
  this.name = name;
  this.email = email;
}

@Serial
private void readObject(ObjectInputStream in)
    throws IOException, ClassNotFoundException {
  in.defaultReadObject();
  if (!isValidEmail(email)) {
    throw new InvalidObjectException("Invalid email: " + email);
  }
}

private static boolean isValidEmail(String email) {
  return email != null && email.contains("@");
}
in.defaultReadObject() setzt die Felder aus dem Objekt-Stream, danach prüft die Methode sie. Die InvalidObjectException ist laut Javadoc für deserialisierte Objekte gedacht, die eine Prüfung nicht bestehen; sie ist eine IOException. Der Versuch, den ungültigen Objekt-Stream einzulesen, liefert jetzt:
java.io.InvalidObjectException: Invalid email: no emailDie Prüfung steht in einer gemeinsamen Methode, damit Konstruktor und readObject() dieselbe Regel anwenden. Prüft der Konstruktor mehrere Felder oder kopiert er veränderliche Argumente, muss readObject() das ebenso tun.
Zusätzliche Daten schreiben mit writeObject()
Im Abschnitt Vererbung ging die ID der nicht serialisierbaren Oberklasse Entity verloren. Mit einem Paar aus writeObject() und readObject() schreibt das Customer-Objekt sie selbst in den Objekt-Stream und liest sie daraus wieder aus. Dafür braucht Entity eine Methode, die die ID setzt – hier protected void setId(long id):
@Serial
private void writeObject(ObjectOutputStream out) throws IOException {
  out.defaultWriteObject();
  out.writeLong(id());
}

@Serial
private void readObject(ObjectInputStream in)
    throws IOException, ClassNotFoundException {
  in.defaultReadObject();
  setId(in.readLong());
}
out.defaultWriteObject() schreibt die Felder von Customer wie bisher, danach hängt writeLong() die ID an. readObject() liest beides in derselben Reihenfolge wieder ein. Die ID bleibt jetzt erhalten:
Customer[id=42, name=Ada Lovelace]Die Spezifikation verlangt, dass readObject() genau einmal defaultReadObject() oder das im nächsten Abschnitt gezeigte readFields() aufruft, bevor es zusätzliche Daten liest – auch dann, wenn es gar keine liest. Rufe deshalb in beiden Methoden zuerst defaultWriteObject() bzw. defaultReadObject() auf, auch wenn die Klasse selbst keine Felder hat.
Umbenannte Felder übernehmen mit readFields()
Im Abschnitt Kompatible und inkompatible Klassenänderungen ging beim Umbenennen von email in emailAddress die E-Mail-Adresse verloren. Mit einer readObject()-Methode übernimmt die neue Version der Klasse den alten Wert, und zwar bei unveränderter serialVersionUID:
public class Customer implements Serializable {

  @Serial private static final long serialVersionUID = 1L;

  private String name;
  private String emailAddress;

  // Konstruktor, toString()

  @Serial
  private void readObject(ObjectInputStream in)
      throws IOException, ClassNotFoundException {
    ObjectInputStream.GetField fields = in.readFields();
    name = (String) fields.get("name", null);
    if (fields.defaulted("emailAddress")) {
      emailAddress = (String) fields.get("email", null);  // aus der alten Version
    } else {
      emailAddress = (String) fields.get("emailAddress", null);
    }
  }
}
in.readFields() liest die Felder aus dem Objekt-Stream, setzt sie aber nicht, sondern liefert sie als Objekt vom Typ GetField. Dessen Methode get() gibt den Wert eines Felds zurück, auch eines Felds, das es in der aktuellen Klasse nicht mehr gibt – hier email. Der zweite Parameter ist der Wert, den get() liefert, wenn das Feld nicht im Objekt-Stream steht. defaulted() prüft, ob ein Feld der aktuellen Klasse im Objekt-Stream fehlt; bei einem Objekt-Stream der alten Version trifft das auf emailAddress zu.
Ein Objekt-Stream der ersten Version und ein Objekt-Stream der neuen Version liefern damit beide die E-Mail-Adresse:
== Renamed field, old stream
Customer[name=Ada Lovelace, emailAddress=ada@example.com]
== Renamed field, new stream
Customer[name=Ada Lovelace, emailAddress=ada@example.com]
Der Preis: readFields() ersetzt defaultReadObject(), die Spezifikation erlaubt genau einen der beiden Aufrufe. Die Methode muss deshalb jedes Feld selbst setzen, und weil das außerhalb des Konstruktors geschieht, darf keins dieser Felder final sein.
Eine zweite Möglichkeit ist, eine eigene Formatversion in den Objekt-Stream zu schreiben: writeObject() schreibt nach defaultWriteObject() eine Zahl, z. B. mit out.writeInt(2), und readObject() verzweigt nach dieser Zahl. Das funktioniert allerdings nur für Objekt-Streams, die diese Zahl schon enthalten – die Klasse muss sie also von ihrer ersten Version an schreiben.
Instanzen kontrollieren mit readResolve()
Manche Klassen haben eine feste Menge von Instanzen und vergleichen sie mit ==. Die folgende Klasse bildet zwei Status einer Bestellung als Konstanten ab:
public final class Status implements Serializable {

  @Serial private static final long serialVersionUID = 1L;

  public static final Status OPEN = new Status("OPEN");
  public static final Status SHIPPED = new Status("SHIPPED");

  private final String name;

  private Status(String name) {
    this.name = name;
  }

  @Override
  public String toString() { return name; }
}
Der private Konstruktor verhindert weitere Instanzen – aber nicht beim Deserialisieren:
Status status = copy(Status.OPEN);
System.out.println(status + " == Status.OPEN: " + (status == Status.OPEN));
OPEN == Status.OPEN: falseDie Kopie ist ein drittes Status-Objekt, und jeder Vergleich mit == liefert false.
readResolve() ersetzt das gelesene Objekt durch ein anderes. Die JVM ruft die Methode nach dem Lesen auf und gibt ihren Rückgabewert anstelle des gelesenen Objekts zurück:
@Serial
private Object readResolve() throws ObjectStreamException {
  return switch (name) {
    case "OPEN" -> OPEN;
    case "SHIPPED" -> SHIPPED;
    default -> throw new InvalidObjectException("Unknown status: " + name);
  };
}
OPEN == ResolvingStatus.OPEN: trueEinfacher geht es mit einem Enum. Für Enums garantiert die Serialisierung von sich aus, dass nach dem Lesen dieselbe Konstante herauskommt – wie, zeigt der Abschnitt Enums.
Das Serialization-Proxy-Muster mit writeReplace()
writeReplace() ist das Gegenstück zu readResolve(): Die JVM ruft es vor dem Schreiben auf und schreibt dessen Rückgabewert anstelle des Objekts.
Damit lässt sich das sogenannte Serialization-Proxy-Muster umsetzen, das Joshua Bloch in Effective Java (Item 90) beschreibt. Die Idee: Die Klasse schreibt nicht sich selbst, sondern ein einfaches Stellvertreter-Objekt, einen Proxy, mit ihren Daten. Beim Lesen baut der Proxy in readResolve() das eigentliche Objekt über den Konstruktor wieder auf – mit allen Prüfungen.
Das folgende Beispiel zeigt eine Bestellposition als Klasse, deren Konstruktor eine Menge kleiner oder gleich null ablehnt. Der Stellvertreter ist ein privater Record:
public final class OrderItem implements Serializable {

  @Serial private static final long serialVersionUID = 1L;

  private final String product;
  private final int quantity;
  private final BigDecimal price;

  public OrderItem(String product, int quantity, BigDecimal price) {
    if (quantity <= 0) {
      throw new IllegalArgumentException("Quantity must be positive: " + quantity);
    }
    this.product = product;
    this.quantity = quantity;
    this.price = price;
  }

  @Serial
  private Object writeReplace() {
    return new SerializedForm(product, quantity, price);
  }

  @Serial
  private void readObject(ObjectInputStream in) throws InvalidObjectException {
    throw new InvalidObjectException("Serialization proxy required");
  }

  private record SerializedForm(String product, int quantity, BigDecimal price)
      implements Serializable {

    @Serial
    private Object readResolve() {
      return new OrderItem(product, quantity, price);
    }
  }

  // toString()
}
Drei Teile arbeiten hier zusammen:
writeReplace()ersetzt dasOrderItembeim Schreiben durch seinen Stellvertreter, einOrderItem.SerializedForm-Objekt. Im Objekt-Stream steht deshalb nurOrderItem$SerializedForm, keine Felder vonOrderItem.readResolve()dieses Stellvertreters ruft beim Lesen den Konstruktor vonOrderItemauf, und der prüft die Menge.readObject()vonOrderItemlehnt schließlich jeden Objekt-Stream ab, der einOrderItem-Objekt direkt enthält. Einen solchen Objekt-Stream schreibt die Klasse selbst nie; er wurde mit einer älteren Version der Klasse ohne Proxy geschrieben oder von jemandem gebaut, der die Prüfung umgehen will.
Nach einer Kopie per Serialisierung ist das Objekt wieder ein OrderItem:
Stream contains OrderItem$SerializedForm: true
OrderItem: OrderItem[product=Notebook, quantity=2, price=4.99]
Das JDK nutzt dieses Muster selbst, z. B. für die Listen aus List.of() – mehr dazu im Abschnitt Collections serialisieren.
Externalizable
Das Interface Externalizable erweitert Serializable um zwei Methoden: writeExternal() und readExternal(). Eine Klasse, die es implementiert, schreibt und liest ihren ganzen Zustand selbst, einschließlich der Felder ihrer Oberklassen. Beim Lesen erzeugt die JVM das Objekt über den öffentlichen parameterlosen Konstruktor und ruft dann readExternal() auf.
Die Klasse bestimmt das Format damit vollständig selbst. Dafür musst du jede Klassenänderung von Hand in writeExternal() und readExternal() nachziehen, und die Klasse braucht einen öffentlichen parameterlosen Konstruktor, also können ihre Felder nicht final sein. Ich empfehle stattdessen writeObject() und readObject() oder einen Serialization Proxy.
Records, Enums, Lambdas und innere Klassen
Für vier Arten von Klassen gelten eigene Regeln.
Records
Records serialisiert die JVM über ihre Komponenten, und beim Lesen ruft sie den kanonischen Konstruktor auf. Eine Prüfung im Konstruktor läuft also auch beim Deserialisieren – genau das, was bei Klassen eine eigene readObject()-Methode erfordert.
Das folgende Beispiel liest einen Objekt-Stream, in dem ein OrderItem mit der Menge 0 steht, in einen Record, dessen kompakter Konstruktor das ablehnt:
public record OrderItem(String product, int quantity, BigDecimal price)
    implements Serializable {

  public OrderItem {
    if (quantity <= 0) {
      throw new IllegalArgumentException("Quantity must be positive: " + quantity);
    }
  }
}
java.io.InvalidObjectException: Quantity must be positive: 0
Cause: java.lang.IllegalArgumentException: Quantity must be positive: 0ObjectInputStream verpackt die IllegalArgumentException des Konstruktors in eine InvalidObjectException. Ein ausführliches Beispiel mit einer Klasse und einem Record im Vergleich zeigt der Artikel über Records im Abschnitt Records deserialisieren.
Weitere Unterschiede zu Klassen legt die Serialisierungs-Spezifikation fest:
- Die Methoden
writeObject(),readObject()undreadObjectNoData()ignoriert die JVM bei Records;writeReplace()undreadResolve()wirken weiterhin. - Die
serialVersionUIDeines Records ist0, wenn er keine deklariert, und beim Lesen vergleichtObjectInputStreamsie nicht. Ein Record braucht deshalb keineserialVersionUID. - Fügst du einem Record eine Komponente hinzu oder entfernst eine, bleiben alte Objekt-Streams lesbar; eine neue Komponente bekommt ihren Default-Wert.
Vor den ignorierten Methoden warnt javac -Xlint:serial, z. B. bei einer writeObject()-Methode im Record Point:
Point.java:5: warning: [serial] serialization-related method writeObject is not effective in a record classFür Daten, die du serialisieren willst, empfehle ich deshalb Records. Sie brauchen weder serialVersionUID noch readObject(), und ihre Prüfungen gelten auch für deserialisierte Objekte.
Enums
Von einer Enum-Konstante schreibt die JVM nur den Namen in den Objekt-Stream. Beim Lesen holt sie die Konstante mit Enum.valueOf() – nach dem Lesen steht also dieselbe Konstante da wie vorher:
OrderStatus status = copy(OrderStatus.OPEN);
System.out.println(status + " == OrderStatus.OPEN: " + (status == OrderStatus.OPEN));
OPEN == OrderStatus.OPEN: trueDie Felder einer Enum-Konstante landen nicht im Objekt-Stream, die fünf Methoden aus dem Abschnitt Serialisierung anpassen ignoriert die JVM, und die serialVersionUID jedes Enums ist 0.
Weil der Name im Objekt-Stream steht, lassen sich alte Objekt-Streams nach dem Umbenennen einer Konstante nicht mehr lesen. Das folgende Beispiel schreibt OrderStatus.SHIPPED und liest den Objekt-Stream mit einer Version des Enums, in der die Konstante DELIVERED heißt:
java.io.InvalidObjectException: enum constant SHIPPED does not exist in class
 eu.happycoders.serialization.special.renamed.OrderStatus
Die Reihenfolge der Konstanten spielt dagegen keine Rolle, und neue Konstanten stören beim Lesen alter Objekt-Streams nicht.
Lambdas
Ein Lambda ist nur serialisierbar, wenn sein Zieltyp Serializable erweitert und alle Werte, die es einfängt, serialisierbar sind. Comparator erweitert Serializable nicht:
Comparator<Order> byId = (a, b) -> Long.compare(a.id(), b.id());
serialize(byId);
java.io.NotSerializableException: eu.happycoders.serialization.Ch8Special$$Lambda/0x000000ff01047000Die Exception nennt die Klasse, die die JVM für das Lambda erzeugt hat; die Hexzahl am Ende ändert sich von Lauf zu Lauf.
Mit einem sogenannten Intersection Cast gibst du dem Lambda einen Zieltyp, der beide Interfaces kombiniert:
Comparator<Order> byId =
    (Comparator<Order> & Serializable) (a, b) -> Long.compare(a.id(), b.id());
Das Lambda lässt sich jetzt serialisieren, und der Objekt-Stream ist 693 Bytes groß. Er enthält ein Objekt der Klasse java.lang.invoke.SerializedLambda, das u. a. die Klasse nennt, in der das Lambda steht, und den Namen der Methode, in die javac den Lambda-Körper kompiliert hat – hier lambda$main$827f6d87$1. Der Objekt-Stream hängt also an einem Namen, den der Compiler vergibt.
Mit derselben Klasse lässt sich der Objekt-Stream wieder lesen, auch nachdem sie neu kompiliert wurde. Denn javac bildet den Hash im Namen aus vier Teilen: der Signatur der umschließenden Methode, dem funktionalen Interface, dem Namen der Variable, der das Lambda zugewiesen wird, und den Variablen, die das Lambda einfängt. Ändert sich einer dieser Teile, findet die JVM die Methode nicht mehr. Schon das Umbenennen der Variable byId macht alte Objekt-Streams unlesbar:
java.io.InvalidObjectException: ReflectiveOperationException during deserialization
Cause: java.lang.IllegalArgumentException: Invalid lambda deserialization
Diese Ausgabe entsteht in zwei Schritten: Das Programm Ch8LambdaNames aus dem Repository schreibt das Lambda; danach wird die Variable umbenannt, die Klasse neu kompiliert und der Objekt-Stream gelesen. Die Anleitung steht im Kommentar der Klasse.
Häufiger als ein einzelnes Lambda serialisierst du eine Collection, die ein Lambda enthält, z. B. ein TreeSet mit einem Comparator:
TreeSet<Order> orders = new TreeSet<>(Comparator.comparing(Order::id));
orders.add(order);
serialize(orders);
java.io.NotSerializableException: eu.happycoders.serialization.Ch8Special$$Lambda/0x000000ff01047800Das überrascht, denn Comparator.comparing() gibt einen serialisierbaren Comparator zurück – im JDK steht dort ein Intersection Cast auf Comparator<T> & Serializable. Nicht serialisierbar ist allerdings die Methodenreferenz Order::id, die das Lambda in comparing() einfängt. Ein Intersection Cast auf sie löst das Problem:
TreeSet<Order> orders = new TreeSet<>(
    Comparator.comparing((Function<Order, Long> & Serializable) Order::id));
Ich empfehle, in Collections, die serialisiert werden, keine Lambdas als Comparator zu verwenden, sondern eine eigene serialisierbare Comparator-Klasse. Dann hängt der Objekt-Stream an einem Klassennamen, den du festlegst.
Innere Klassen
Eine innere Klasse – eine nicht-statische verschachtelte Klasse, eine lokale oder eine anonyme – hat ein verstecktes Feld, das auf die Instanz der äußeren Klasse verweist. Die Serialisierung schreibt dieses Feld mit.
Im folgenden Beispiel ist Draft eine innere Klasse von OrderService, und OrderService ist nicht serialisierbar:
public class OrderService {

  public Draft newDraft(String customerName) {
    return new Draft(customerName);
  }

  public class Draft implements Serializable {
    @Serial private static final long serialVersionUID = 1L;

    private final String customerName;
    // Konstruktor, toString()
  }
}
Das Serialisieren eines Draft scheitert an der äußeren Klasse:
java.io.NotSerializableException: eu.happycoders.serialization.special.OrderServiceWäre OrderService serialisierbar, landete der ganze Service im Objekt-Stream. Die Spezifikation rät deshalb ausdrücklich davon ab, innere Klassen zu serialisieren; außerdem hängen die Namen der versteckten Felder und anonymer Klassen vom Compiler ab.
Eine static verschachtelte Klasse hat hingegen keinen Verweis auf die äußere Instanz und keines dieser Probleme – für Draft reicht ein static vor class.
Collections serialisieren
Die Collections des JDK sind serialisierbar, solange ihre Elemente es sind. Sie schreiben dabei nicht ihre internen Datenstrukturen, sondern ihren logischen Inhalt. Bei einer ArrayList ist das interne Array transient; ihre writeObject()-Methode schreibt die Größe und die Elemente. Die Kapazität spielt deshalb keine Rolle:
List<String> small = new ArrayList<>();
List<String> large = new ArrayList<>(10_000);
for (String product : List.of("Notebook", "Fountain pen", "Ink")) {
  small.add(product);
  large.add(product);
}
System.out.println("Capacity 10:     " + serialize(small).length + " bytes");
System.out.println("Capacity 10,000: " + serialize(large).length + " bytes");
Capacity 10: 90 bytes
Capacity 10,000: 90 bytesEine HashMap geht genauso vor: Ihre Bucket-Tabelle ist transient, sie schreibt die Schlüssel-Wert-Paare und baut die Tabelle beim Lesen neu auf.
Die unveränderlichen Listen, Sets und Maps aus List.of(), Set.of() und Map.of() nutzen das Serialization-Proxy-Muster: Ihre writeReplace()-Methode liefert ein Objekt der Klasse CollSer, und dessen readResolve() erzeugt beim Lesen wieder eine unveränderliche Collection.
List<String> products = List.of("Notebook", "Fountain pen", "Ink");
List<String> productsCopy = copy(products);
System.out.println(productsCopy.getClass().getName());
productsCopy.add("Eraser");
java.util.ImmutableCollections$ListN
java.lang.UnsupportedOperationExceptionNicht serialisierbar sind die Sichten auf Collections, z. B. keySet() einer HashMap oder subList() einer ArrayList:
java.io.NotSerializableException: java.util.HashMap$KeySet
java.io.NotSerializableException: java.util.ArrayList$SubList
Eine Sicht kopierst du vor dem Serialisieren in eine eigene Collection, z. B. mit new ArrayList<>(stock.keySet()) oder List.copyOf(stock.keySet()).
Deserialisierungs-Angriffe und Filter
Ein Objekt-Stream enthält nicht nur Daten, sondern auch die Namen der Klassen, aus denen readObject() die Objekte erzeugt. Wer den Objekt-Stream schreibt, bestimmt also, welche Klassen die lesende Anwendung lädt und instanziiert – aus allem, was auf ihrem Classpath liegt.
Liest eine Anwendung Objekt-Streams aus einer Quelle, die ein Angreifer kontrolliert – ein Cookie, eine Nachricht, eine hochgeladene Datei –, ist das ein Einfallstor für Angriffe auf diese Anwendung.
Wie ein Deserialisierungs-Angriff funktioniert
Viele Klassen führen beim Deserialisieren Code aus: in ihrer readObject()-Methode, oder indem sie hashCode(), equals() oder compare() der gelesenen Objekte aufrufen.
Ein Beispiel aus dem JDK ist die PriorityQueue. Ihre readObject()-Methode liest die Elemente und stellt danach die Heap-Ordnung her – mit dem Comparator, der ebenfalls im Objekt-Stream steht. Das folgende Beispiel serialisiert eine PriorityQueue mit einem Comparator, der jeden Aufruf ausgibt, und liest sie ohne weitere Vorkehrungen wieder ein. Der Comparator:
public class LoggingComparator implements Comparator<String>, Serializable {

  @Serial private static final long serialVersionUID = 1L;

  @Override
  public int compare(String a, String b) {
    System.out.println("compare(" + a + ", " + b + ") called");
    return a.compareTo(b);
  }
}
Das Programm, das die Queue schreibt und liest:
PriorityQueue<String> queue = new PriorityQueue<>(new LoggingComparator());
queue.add("Notebook");
queue.add("Fountain pen");
queue.add("Ink");
byte[] data = serialize(queue);

Object object = deserialize(data);
System.out.println("Read: " + object.getClass().getSimpleName());
Beim Einfügen ruft die Queue den Comparator ebenfalls auf. Die folgende Ausgabe zeigt nur die Zeilen, die beim Lesen entstehen:
compare(Notebook, Ink) called
compare(Fountain pen, Ink) called
Read: PriorityQueue
compare() läuft, während readObject() noch liest – bevor die Anwendung das Objekt überhaupt sieht und prüfen könnte.
Ein Angreifer verwendet statt des harmlosen Comparators eine Kette von Klassen aus verbreiteten Bibliotheken, deren Methoden sich gegenseitig aufrufen und am Ende z. B. Runtime.exec() erreichen. Eine solche Gadget Chain führt auf dem Server einen Befehl aus, den der Angreifer mitgeschickt hat. Die bekannteste dieser Ketten traf 2015 Anwendungsserver wie WebLogic, WebSphere und JBoss; Details dazu stehen im Artikel über die Neuerungen in Java 9.
Die wichtigste Regel lautet deshalb: Deserialisiere keine Daten aus Quellen, denen du nicht vertraust. Wo das nicht geht, begrenze mit einem Filter, welche Klassen readObject() überhaupt anlegen darf.
Ein Filter für einen Objekt-Stream
Seit Java 9 (JEP 290) kannst du einem ObjectInputStream einen ObjectInputFilter mitgeben. Der Filter wird für jede Klasse aufgerufen, die im Objekt-Stream vorkommt, bevor die JVM ein Objekt dieser Klasse anlegt, und entscheidet, ob die Klasse erlaubt ist.
Am einfachsten erzeugst du einen Filter aus einem Muster:
String pattern = "eu.happycoders.serialization.*;java.util.ArrayList;"
    + "java.math.BigDecimal;java.math.BigInteger;java.lang.Number;"
    + "java.lang.Object;!*";

try (var in = new ObjectInputStream(new ByteArrayInputStream(data))) {
  in.setObjectInputFilter(ObjectInputFilter.Config.createFilter(pattern));
  Object object = in.readObject();
  System.out.println("Read: " + object.getClass().getSimpleName());
} catch (InvalidClassException e) {
  System.out.println(e);
}
Das Muster erlaubt die Klassen, aus denen eine Bestellung besteht, und lehnt mit !* alles andere ab. Eine Bestellung liest das Programm wie bisher, die PriorityQueue lehnt der Filter ab, bevor der Comparator aufgerufen wird:
Read: Order
java.io.InvalidClassException: filter status: REJECTED
Ein Muster besteht aus Einträgen, die durch Semikolons getrennt sind. Der erste Eintrag, der auf eine Klasse passt, entscheidet:
| Eintrag | passt auf |
|---|---|
java.math.BigDecimal | genau diese Klasse |
eu.happycoders.serialization.* | alle Klassen in diesem Package |
eu.happycoders.** | alle Klassen in diesem Package und seinen Unterpackages |
java.util.Array* | alle Klassen, deren Name so beginnt |
java.base/* | alle Klassen im Modul java.base |
! vor einem Eintrag | lehnt ab, was der Eintrag beschreibt |
Welche Klassen eine Bestellung braucht, ist nicht offensichtlich. Der Filter prüft auch:
- serialisierbare Oberklassen, z. B.
java.lang.NumberfürBigDecimal, - Objekte im Inneren anderer Objekte, z. B.
BigIntegerinBigDecimal, - Arrays, die eine Klasse beim Lesen anlegt, über ihren Elementtyp:
ArrayListmeldet beim Lesen dasObject[]für ihre Elemente an den Filter, deshalb braucht das Musterjava.lang.Object.
Zwei Dinge prüft ein Muster dagegen nicht: Strings, für die ObjectInputStream den Filter gar nicht aufruft, und Arrays primitiver Typen wie byte[]. Die lässt ein Muster immer durch, auch mit !*; begrenzen kannst du sie nur mit dem Limit maxarray aus dem nächsten Abschnitt.
Am einfachsten findest du die nötigen Klassen über das Log, das der Abschnitt Ein Filter für die ganze JVM zeigt.
Das !* am Ende ist zwingend erforderlich. Passt kein Eintrag, ist das Ergebnis des Filters „unentschieden“ (UNDECIDED), und eine unentschiedene Klasse lässt ObjectInputStream durch. Ohne !* erlaubt das Muster oben also alles:
compare(Notebook, Ink) called
compare(Fountain pen, Ink) called
Read: PriorityQueue
Limits gegen Denial of Service
Auch ohne Gadget Chain kann ein Objekt-Stream Schaden anrichten: Er kann die Anwendung so lange beschäftigen oder so viel Speicher belegen lassen, dass sie nicht mehr reagiert.
Joshua Bloch zeigt in Effective Java (Item 85) eine sogenannte Deserialization Bomb: 100 Ebenen verschachtelter HashSets, serialisiert in 5.744 Bytes. Beim Lesen berechnet jedes HashSet die Hashcodes seiner Elemente, und der Hashcode eines Sets ist die Summe der Hashcodes seiner Elemente. Weil jedes Set zwei Sets der nächsten Ebene enthält, verdoppelt sich die Zahl der hashCode()-Aufrufe mit jeder Ebene – bei 100 Ebenen endet das Lesen praktisch nie.
Dagegen helfen Limits, die du ins Muster schreibst:
| Limit | begrenzt |
|---|---|
maxdepth | die Tiefe des Objektgraphen |
maxrefs | die Zahl der Objekte und Rückverweise |
maxbytes | die Länge des Objekt-Streams in Bytes |
maxarray | die Länge jedes Arrays |
Mit maxdepth=20 weist der Filter die Bombe sofort ab:
5744 bytes
java.io.InvalidClassException: filter status: REJECTED
Rejected after 0.6 ms
Ein Muster kann Limits und Klassen kombinieren, z. B. maxdepth=20;maxarray=10000;eu.happycoders.serialization.*;!*.
Ein Filter für die ganze JVM
setObjectInputFilter() hilft nur bei Objekt-Streams, die dein eigener Code öffnet. Deserialisiert hingegen eine Bibliothek, kommst du an ihren ObjectInputStream nicht heran.
Dafür gibt es einen JVM-weiten Filter. Du setzt ihn mit der System Property jdk.serialFilter oder mit der gleichnamigen Security Property in der Datei conf/security/java.security des JDK. Das Repository enthält ein Programm, das die PriorityQueue über eine Klasse LegacyCache liest, die selbst keinen Filter setzt:
$ java "-Djdk.serialFilter=eu.happycoders.serialization.*;java.util.ArrayList;java.math.*;java.lang.Number;java.lang.Object;!*" \
    -cp target/classes eu.happycoders.serialization.Ch10GlobalFilter
...
java.io.InvalidClassException: filter status: REJECTED
Welche Klasse der Filter abgelehnt hat, sagt die Exception nicht. Das verrät das Log: ObjectInputStream protokolliert jede Ablehnung über den Logger java.io.serialization auf der Stufe DEBUG, die java.util.logging als FINE ausgibt. Mit einer Konfigurationsdatei wie dieser:
handlers = java.util.logging.ConsoleHandler
java.util.logging.ConsoleHandler.level = FINE
java.io.serialization.level = FINE
und der Option -Djava.util.logging.config.file=serialfilter-logging.properties steht die Klasse im Log:
FINE: ObjectInputFilter REJECTED: class java.util.PriorityQueue, array length: -1, nRefs: 1, depth: 1, bytes: 87, ex: n/aAuf der Stufe FINER (TRACE) protokolliert ObjectInputStream auch jede erlaubte Klasse. So findest du heraus, welche Klassen ein Muster erlauben muss. Seit Java 17 gibt es außerdem das JFR-Event jdk.Deserialization, das du in einer JFR-Konfiguration aktivieren musst.
Filter je nach Kontext: die Filter-Factory
Ein JVM-weiter Filter gilt für jeden Objekt-Stream. Erlaubt er alle Klassen, die irgendein Teil der Anwendung braucht, ist er für jeden einzelnen Teil zu großzügig.
Seit Java 17 (JEP 415) kannst du deshalb eine Filter-Factory registrieren. Sie wird aufgerufen, wenn ein ObjectInputStream entsteht und wenn jemand setObjectInputFilter() aufruft, und bestimmt den Filter für diesen Objekt-Stream. Die Factory bekommt zwei Parameter übergeben: den Filter, den der Objekt-Stream bisher hat, und den Filter, der neu gesetzt werden soll. Beim Erzeugen eines ObjectInputStream sind das null und der JVM-weite Filter, bei einem Aufruf von setObjectInputFilter() der bisherige Filter des Objekt-Streams und der übergebene. Zurück gibt die Factory den Filter, den der Objekt-Stream schließlich anwendet – oder null für keinen Filter.
Die folgende Factory wendet einen Filter an, solange ein ScopedValue gebunden ist. So kannst du einem Aufruf in eine Bibliothek einen Filter mitgeben, ohne die Bibliothek zu ändern:
private static final ScopedValue<ObjectInputFilter> ALLOWED =
    ScopedValue.newInstance();

static void main() throws Exception {
  ObjectInputFilter.Config.setSerialFilterFactory(Ch10FilterFactory::chooseFilter);

  byte[] queueData = PriorityQueues.serializedQueue();

  loadAndPrint(queueData);  // liest die Queue

  ScopedValue.where(ALLOWED, ORDERS_ONLY).call(() -> {
    loadAndPrint(queueData);  // lehnt die Queue ab
    return null;
  });
}

private static ObjectInputFilter chooseFilter(
    ObjectInputFilter current, ObjectInputFilter next) {
  return ALLOWED.isBound() ? ObjectInputFilter.merge(ALLOWED.get(), next) : next;
}
ORDERS_ONLY ist in diesem Beispiel ein Filter mit dem Muster aus dem Abschnitt Ein Filter für einen Objekt-Stream. loadAndPrint() ruft LegacyCache.load() auf, das wie Code aus einer Bibliothek einen eigenen ObjectInputStream öffnet und ohne Filter daraus liest, und gibt das Ergebnis oder die Exception aus.
Außerhalb des Scopes gibt die Filter-Factory-Methode chooseFilter() den angeforderten Filter unverändert zurück – beim Erzeugen des Objekt-Streams den JVM-weiten, hier also keinen. Innerhalb des Scopes kombiniert merge() den Filter aus dem ScopedValue mit dem angeforderten; ist der angeforderte null, gibt merge() den ersten unverändert zurück:
compare(Notebook, Ink) called
compare(Fountain pen, Ink) called
Read: PriorityQueue
java.io.InvalidClassException: filter status: REJECTED
Zum Kombinieren von Filtern hat ObjectInputFilter seit Java 17 vier statische Methoden:
allowFilter(predicate, otherStatus)erlaubt die Klassen, auf die einPredicatezutrifft, und liefert für alle anderenotherStatus.rejectFilter(predicate, otherStatus)lehnt die Klassen ab, auf die dasPredicatezutrifft.merge(filter, anotherFilter)lehnt ab, was einer der beiden ablehnt, und erlaubt, was einer erlaubt.rejectUndecidedClass(filter)lehnt jede Klasse ab, bei der der Filter unentschieden ist – das!*für zusammengesetzte Filter.
Eine Factory kannst du nur einmal setzen, ein zweiter Aufruf von setSerialFilterFactory() wirft eine IllegalStateException. Alternativ setzt du sie mit der System Property jdk.serialFilterFactory.
Wann du Java-Serialisierung nicht verwenden solltest
Die Abschnitte oben zeigen die Kehrseiten der Java-Serialisierung. Zusammengefasst sind es vier:
- Der Objekt-Stream ist groß. Jede Klasse steht mit Namen,
serialVersionUIDund Feldbeschreibungen darin. - Der Objekt-Stream hängt an deinen Klassen. Klassen- und Feldnamen sind Teil des Formats. Benennst du eine Klasse um oder verschiebst sie, sind alte Objekt-Streams unlesbar; benennst du ein Feld um, geht sein Wert ohne Fehlermeldung verloren.
- Fremde Objekt-Streams sind ein Sicherheitsrisiko. Sie bestimmen, welche Klassen die lesende Anwendung anlegt und welcher Code dabei läuft.
- Deserialisierung umgeht die Konstruktoren. Jede Prüfung musst du in
readObject()wiederholen. Brian Goetz schreibt in der Design-Note „Towards Better Serialization“ von 2019, die Serialisierung erzeuge Objekte über „extralinguistic mechanisms, bypassing constructors“.
Wie groß der Unterschied beim ersten Punkt ist, zeigt ein Vergleich mit DataOutputStream. Die folgende Methode schreibt von einer Bestellung nur die Werte – ID, Name, E-Mail-Adresse, Zahl der Bestellpositionen und je Bestellposition Produkt, Menge und Preis:
private static void writeOrder(Order order, DataOutputStream out) throws IOException {
  out.writeLong(order.id());
  out.writeUTF(order.customer().name());
  out.writeUTF(order.customer().email());
  out.writeInt(order.items().size());
  for (OrderItem item : order.items()) {
    out.writeUTF(item.product());
    out.writeInt(item.quantity());
    out.writeUTF(item.price().toString());
  }
}
Das Programm schreibt damit die Bestellung aus der Einleitung und 1.000 Bestellungen von 1.000 verschiedenen Kunden mit je denselben zwei Bestellpositionen, und zum Vergleich beides mit ObjectOutputStream:
== One order
ObjectOutputStream: 822 bytes
DataOutputStream:   88 bytes
== 1,000 orders of 1,000 customers
ObjectOutputStream: 208425 bytes
DataOutputStream:   95790 bytes
Für eine Bestellung belegt die Java-Serialisierung mehr als neunmal so viel Platz. Bei 1.000 Bestellungen schreibt sie jede Klassenbeschreibung nur einmal, und die Produktnamen – String-Literale, also je ein Objekt – ebenfalls nur einmal, danach Rückverweise. Eine Bestellung kostet dann im Schnitt 208 Bytes statt 822; die Differenz sind im Wesentlichen die Klassenbeschreibungen. Trotzdem sind 208.425 Bytes noch 2,2-mal so viel wie die 95.790 Bytes von DataOutputStream.
Joshua Bloch widmet der Serialisierung in Effective Java ein eigenes Kapitel, Items 85 bis 90 – von dort stammen die Deserialization Bomb und das Serialization-Proxy-Muster.
Für neuen Code empfehle ich ein Format, das nicht an deine Klassen gebunden ist:
- JSON für Daten, die Menschen lesen oder andere Sprachen verarbeiten sollen, z. B. mit Jackson.
- Protocol Buffers oder ein ähnliches Schema-Format, wenn Größe und Geschwindigkeit zählen und mehrere Versionen eines Formats nebeneinander leben müssen.
DataOutputStreamfür ein eigenes, kompaktes Binärformat – wie das geht, zeigt der Artikel überDataOutputStreamundDataInputStream.
Die Java-Serialisierung empfehle ich nur dort, wo ein Framework sie voraussetzt: bei RMI, bei HTTP-Sessions oder in einem Cache, der Serializable verlangt. Dann mit Records für die Daten, mit einer expliziten serialVersionUID für die übrigen Klassen und mit einem Filter für jeden Objekt-Stream, der von außen kommt.
Häufige Fehler
Die folgenden Fehler zeigen die Abschnitte oben jeweils mit Code und Ausgabe:
- Ein Feld hat einen nicht serialisierbaren Typ.
writeObject()bricht mit einerNotSerializableExceptionab; die Ursache kann tief im Objektgraphen liegen, z. B. in einer Methodenreferenz in einemTreeSet-Comparator oder in der äußeren Instanz einer inneren Klasse. - Ein transientes Feld ist nach dem Lesen
null. Feld-Initializer und Konstruktor laufen beim Deserialisieren nicht; den Startwert setzt einereadObject()-Methode. - Die explizite
serialVersionUIDfehlt. Eine neue Methode oder einassertmacht alle alten Objekt-Streams unlesbar – mit einerInvalidClassException. - Ein Feld wurde umbenannt. Sein Wert geht beim Lesen alter Objekt-Streams ohne Fehlermeldung verloren – es sei denn,
readObject()übernimmt ihn mitreadFields(). - Dasselbe Objekt wird zweimal in einen Objekt-Stream geschrieben. Der zweite Aufruf schreibt nur einen Rückverweis auf den alten Stand; dagegen hilft
reset(), nichtwriteUnshared(). - Eine Prüfung steht nur im Konstruktor. Deserialisierung umgeht sie; eine Klasse braucht dafür
readObject(), ein Record nicht. - Ein Filter endet nicht mit
!*. Alle Klassen, die er nicht nennt, lässt er durch.
Zusammenfassung
Die Java-Serialisierung schreibt mit ObjectOutputStream.writeObject() ein Objekt und alles, was von ihm aus erreichbar ist, in einen Objekt-Stream, und ObjectInputStream.readObject() baut daraus wieder Objekte – ohne Konstruktoren aufzurufen. Jede Klasse im Objektgraphen muss Serializable implementieren. Felder mit transient landen nicht im Objekt-Stream und haben nach dem Lesen ihren Default-Wert. Geteilte Objekte stehen nur einmal im Objekt-Stream, danach folgen Rückverweise; das spart Platz, liefert aber den alten Stand, wenn du ein verändertes Objekt erneut schreibst.
Die serialVersionUID entscheidet, ob ein alter Objekt-Stream zur aktuellen Klasse passt. Ohne explizite Angabe berechnet die JVM sie aus der Klasse, und schon ein assert ändert sie. Mit einer festen serialVersionUID vergleicht ObjectInputStream die Felder nach ihren Namen; neue Felder sind dann unproblematisch, umbenannte verlieren ihre Werte ohne Fehlermeldung.
Mit readObject() prüfst du gelesene Daten, mit writeObject() schreibst du zusätzliche, mit readResolve() und writeReplace() ersetzt du Objekte beim Lesen und Schreiben. Records serialisiert die JVM über ihren kanonischen Konstruktor, Enums über ihren Namen.
Ein Objekt-Stream bestimmt, welche Klassen die lesende Anwendung instanziiert. Deserialisierungs-Filter begrenzen das – für einen Objekt-Stream, für die ganze JVM oder, mit einer Filter-Factory, je nach Kontext.
Meine Empfehlungen:
- Verwende die Java-Serialisierung nur, wo ein Framework sie voraussetzt; für eigene Formate eignen sich JSON, Protocol Buffers oder
DataOutputStreambesser. - Nimm Records für Daten, die du serialisierst.
- Deklariere in jeder serialisierbaren Klasse eine
serialVersionUIDund kompiliere mit-Xlint:serial. - Prüfe in
readObject()alles, was der Konstruktor prüft. - Setze zwischen Datei- oder Socket-Streams und die Objekt-Streams einen
BufferedOutputStreambzw.BufferedInputStream. - Deserialisiere keine Daten aus fremden Quellen – und wo es sein muss, nur mit einem Filter, der auf
!*endet.
Weitere Artikel zum Lesen und Schreiben von Dateien findest du in der Serie, zu der dieser Artikel gehört, z. B. über das Lesen von Dateien und das Schreiben von Dateien.
Hat dieser Artikel deine Fragen beantwortet? Dann freue ich mich über eine Bewertung auf meinem ProvenExpert-Profil – sie hilft anderen Entwickler:innen, diese Inhalte zu finden.