Collectors.groupingBy() ist ein Collector der Java-Stream-API, der die Elemente eines Streams nach einem Schlüssel gruppiert. Für jedes Element berechnet er mit einer Funktion den Schlüssel, und alle Elemente mit demselben Schlüssel landen in derselben Gruppe.
So gruppierst du eine Liste von Büchern nach Genre:
Map<Genre, List<Book>> booksByGenre = BOOKS.stream()
    .collect(groupingBy(Book::genre));

System.out.println(booksByGenre.get(Genre.GOTHIC));
[Book[title=Frankenstein, author=Mary Shelley, year=1818, genre=GOTHIC],
Book[title=Dracula, author=Bram Stoker, year=1897, genre=GOTHIC]]Wenn du GROUP BY aus SQL kennst, kennst du das Prinzip. Wie dort kannst du die Elemente der Gruppen anschließend zählen, summieren oder auf andere Weise zusammenfassen – das erledigt ein zweiter Collector, den du groupingBy() mitgibst.
groupingBy() gibt es seit Java 8, in drei Varianten. Welche du wann brauchst, welche Collectors du mit groupingBy() kombinieren kannst und wann partitioningBy() das bessere Werkzeug ist, zeige ich dir in diesem Artikel.
In diesem Artikel erfährst du,
- wie
groupingBy()die Elemente auf Gruppen verteilt, - welche drei Varianten von
groupingBy()es gibt und wie du den Typ der Map bestimmst, - wie du die Elemente der Gruppen mit Downstream-Collectors zählst, filterst, umrechnest und zusammenfasst,
- wie du über mehrere Ebenen und nach mehreren Feldern gruppierst,
- was bei einem
null-Schlüssel passiert, - wann
partitioningBy()das bessere Werkzeug ist, - wie du das Ergebnis sortierst,
- wie sich
groupingBy()in parallelen Streams verhält und wanngroupingByConcurrent()passt, - welche Fehler du vermeiden solltest.
Die Beispiele in diesem Artikel
Die Beispiele verwenden das Datenmodell des Artikels über Java Streams – ein Enum Genre, einen Record Book und eine kleine Bibliothek mit elf Klassikern:
public enum Genre {
  NOVEL,
  GOTHIC,
  ADVENTURE,
  FANTASY,
  SCIENCE_FICTION
}

public record Book(String title, String author, int year, Genre genre) {}
public class Library {
public static final List<Book> BOOKS = List.of(
new Book("Pride and Prejudice", "Jane Austen", 1813, NOVEL),
new Book("Frankenstein", "Mary Shelley", 1818, GOTHIC),
new Book("Moby-Dick", "Herman Melville", 1851, ADVENTURE),
new Book("From the Earth to the Moon", "Jules Verne", 1865, SCIENCE_FICTION),
new Book("Alice's Adventures in Wonderland", "Lewis Carroll", 1865, FANTASY),
new Book("Around the World in Eighty Days", "Jules Verne", 1873, ADVENTURE),
new Book("Treasure Island", "Robert Louis Stevenson", 1883, ADVENTURE),
new Book("Kidnapped", "Robert Louis Stevenson", 1886, ADVENTURE),
new Book("The Time Machine", "H. G. Wells", 1895, SCIENCE_FICTION),
new Book("Dracula", "Bram Stoker", 1897, GOTHIC),
new Book("The War of the Worlds", "H. G. Wells", 1898, SCIENCE_FICTION));
}Die elf Bücher verteilen sich ungleich auf die fünf Genres: Zum Genre ADVENTURE gehören vier Bücher, zu NOVEL und FANTASY je eines. Drei der acht Autor:innen haben zwei Bücher in der Bibliothek: Jules Verne, Robert Louis Stevenson und H. G. Wells.
Die Beispiele importieren die Collectors statisch, z. B. mit import static java.util.stream.Collectors.groupingBy;. Den vollständigen Code aller Beispiele findest du im GitHub-Repository java-streams-examples, im Package eu.happycoders.groupingby. Lange Maps gibt das Programm in einer Zeile aus; im Artikel sind sie nach jedem Eintrag umbrochen, damit du nicht zur Seite scrollen musst.
Wie funktioniert groupingBy()?
Hier noch einmal das Beispiel aus der Einleitung:
Map<Genre, List<Book>> booksByGenre = BOOKS.stream()
    .collect(groupingBy(Book::genre));
groupingBy() bekommt in der einfachsten Form eine Funktion, den sogenannten Classifier (Klassifizierer). Dieser berechnet aus einem Element den Schlüssel seiner Gruppe – im Beispiel Book::genre.
collect() ruft den Classifier für jedes Buch auf. Gibt es zu dem Schlüssel noch keine Gruppe, legt groupingBy() eine an. Dann fügt es das Buch der Gruppe seines Schlüssels hinzu. Zurück kommt eine Map von Schlüssel auf Gruppe.
Was aus einer Gruppe wird, bestimmt ein zweiter Collector, der sogenannte Downstream-Collector (nachgelagerter Collector). Ohne Angabe ist das toList(), und jede Gruppe wird eine Liste wie im Beispiel oben.
Die folgende Grafik zeigt den Ablauf für fünf der elf Bücher. Links stehen die Bücher in der Reihenfolge der Bibliothek, mit Titel und Genre. Rechts steht die Map, die groupingBy(Book::genre) daraus baut: Jeder ihrer Einträge zeigt oben den Schlüssel und darunter die Liste mit den Buchtiteln seiner Gruppe. Über den Pfeilen steht der Classifier, und hervorgehoben ist jeweils der Schlüssel, das Genre.
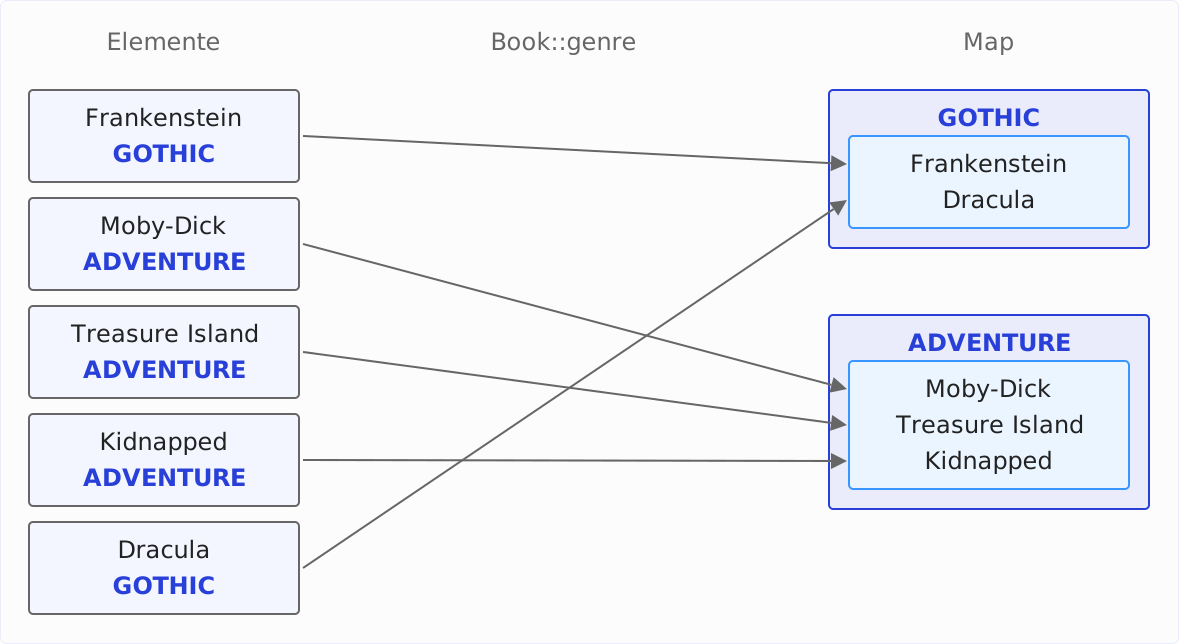
Was du in der Grafik auch gut siehst: Innerhalb einer Gruppe bleibt die Reihenfolge des Streams erhalten.
collect(groupingBy(Book::genre)) entspricht der folgenden Schleife:
Map<Genre, List<Book>> booksByGenre = new HashMap<>();
for (Book book : BOOKS) {
  booksByGenre.computeIfAbsent(book.genre(), genre -> new ArrayList<>()).add(book);
}
computeIfAbsent() liefert die Liste zum Genre des Buchs und legt sie vorher an, wenn es noch keine gibt. So arbeitet auch groupingBy() im JDK: Für jedes Element ruft es computeIfAbsent() auf der Map auf und übergibt das Element dann dem Downstream-Collector der Gruppe.
Wie der keyMapper von toMap() ist der Classifier vom Typ Function. Er kann also jeden beliebigen Schlüssel berechnen, nicht nur ein Feld zurückgeben – Beispiele dafür zeigt der Abschnitt Berechnete Schlüssel.
Die Map ist heute eine HashMap, die Listen sind vom Typ ArrayList. Zugesagt ist das nicht: Laut Javadoc gibt es keine Garantie für Typ, Veränderbarkeit, Serialisierbarkeit oder Threadsicherheit der Map und der Listen.
Eine HashMap hat keine feste Reihenfolge der Schlüssel.
Das folgende Beispiel gibt die Genres der Map aus:
System.out.println(booksByGenre.keySet());[NOVEL, GOTHIC, FANTASY, SCIENCE_FICTION, ADVENTURE]Das ist weder die Reihenfolge, in der die Konstanten deklariert sind, noch die, in der die Genres in der Bibliothek auftauchen. Eine HashMap ordnet ihre Einträge nach dem Hashcode des Schlüssels, und Enum.hashCode() liefert den Identity-Hashcode der Konstanten. Den vergibt die JVM beim ersten Aufruf, aus einem Zahlengenerator, der mit jedem vergebenen Identity-Hashcode weiterzählt.
Dasselbe Programm liefert deshalb bei jedem Start dieselbe Reihenfolge. Ein anderes Programm, das vor dem Gruppieren andere Objekte hasht, liefert eine andere Reihenfolge – in diesem Artikel z. B. die Beispiele der beiden nächsten Abschnitte.
Brauchst du eine feste Reihenfolge, bestimmst du den Typ der Map selbst und wählst eine mit einer deterministischen Reihenfolge. Wie das geht, zeigt der nächste Abschnitt.
Die drei Varianten von groupingBy()
Die Klasse Collectors deklariert groupingBy() in drei Varianten:
<T, K> Collector<T, ?, Map<K, List<T>>> groupingBy(
    Function<? super T, ? extends K> classifier)

<T, K, A, D> Collector<T, ?, Map<K, D>> groupingBy(
    Function<? super T, ? extends K> classifier,
    Collector<? super T, A, D> downstream)

<T, K, D, A, M extends Map<K, D>> Collector<T, ?, M> groupingBy(
    Function<? super T, ? extends K> classifier,
    Supplier<M> mapFactory,
    Collector<? super T, A, D> downstream)
Jede Variante erweitert die vorige um ein Argument. Anders als bei toMap() steht das Argument für den Map-Typ, mapFactory, nicht am Ende, sondern vor dem Downstream-Collector. Was die Wildcards ? super T und ? extends K bedeuten, erklärt der Artikel über funktionale Interfaces; für die Benutzung von groupingBy() brauchst du sie nicht.
groupingBy(classifier) – eine Liste pro Schlüssel
Die erste Variante kennst du aus der Einleitung. Sie sammelt die Elemente jeder Gruppe in eine Liste. Im JDK ist sie als Aufruf der zweiten Variante mit toList() als Downstream-Collector implementiert.
Das folgende Beispiel gruppiert die Bücher nach Autor:in und gibt die Bücher von H. G. Wells aus:
Map<String, List<Book>> booksByAuthor = BOOKS.stream()
    .collect(groupingBy(Book::author));

booksByAuthor.get("H. G. Wells").forEach(System.out::println);
Book[title=The Time Machine, author=H. G. Wells, year=1895, genre=SCIENCE_FICTION]
Book[title=The War of the Worlds, author=H. G. Wells, year=1898, genre=SCIENCE_FICTION]groupingBy(classifier, downstream) – ein Ergebnis pro Gruppe
Das zweite Argument ist der Downstream-Collector. Er bekommt die Elemente einer Gruppe, so als wäre die Gruppe ein eigener Stream, und liefert den Wert, der am Ende in der Map unter ihrem Schlüssel steht.
Das folgende Beispiel zählt mit counting() die Bücher pro Genre:
Map<Genre, Long> bookCountByGenre = BOOKS.stream()
    .collect(groupingBy(Book::genre, counting()));
{ADVENTURE=4,
SCIENCE_FICTION=3,
NOVEL=1,
GOTHIC=2,
FANTASY=1}Statt Listen stehen in der Map jetzt Zahlen vom Typ Long. Als Downstream-Collector eignet sich jeder Collector, den du auch direkt an collect() übergeben könntest – welche du am häufigsten brauchst, zeigt der Abschnitt Downstream-Collectors.
groupingBy(classifier, mapFactory, downstream) – mit eigenem Map-Typ
Das mittlere Argument, mapFactory, ist ein Supplier, der eine neue, leere Map erzeugt. Damit bestimmst du, in welche Map-Implementierung groupingBy() sammelt – und so auch die Reihenfolge der Schlüssel.
Eine Variante mit Map-Typ, aber ohne Downstream-Collector gibt es nicht. Willst du Listen in einer TreeMap, übergibst du toList() als drittes Argument.
Die folgenden Abschnitte zeigen drei Map-Typen mit fester Reihenfolge.
EnumMap: nach der Deklaration der Konstanten
Ist der Schlüssel eine Enum-Konstante, ist eine EnumMap die passende Wahl. Sie gibt die Einträge in der Reihenfolge aus, in der die Konstanten deklariert sind.
EnumMap hat keinen Konstruktor ohne Argumente, denn sie muss den Enum-Typ kennen – deshalb übergibst du ein Lambda, das den Konstruktor mit Genre.class aufruft:
Map<Genre, Long> bookCountByGenre = BOOKS.stream()
    .collect(groupingBy(Book::genre, () -> new EnumMap<>(Genre.class), counting()));
{NOVEL=1,
GOTHIC=2,
ADVENTURE=4,
FANTASY=1,
SCIENCE_FICTION=3}LinkedHashMap: nach dem ersten Vorkommen
Mit LinkedHashMap::new stehen die Schlüssel in der Reihenfolge, in der sie im Stream zum ersten Mal vorkommen. In der Bibliothek kommt das Genre SCIENCE_FICTION mit „From the Earth to the Moon“ vor FANTASY mit „Alice’s Adventures in Wonderland“.
Das folgende Beispiel zählt die Bücher pro Genre in eine LinkedHashMap:
Map<Genre, Long> bookCountByGenre = BOOKS.stream()
    .collect(groupingBy(Book::genre, LinkedHashMap::new, counting()));
{NOVEL=1,
GOTHIC=2,
ADVENTURE=4,
SCIENCE_FICTION=3,
FANTASY=1}TreeMap: nach der natürlichen Ordnung
Eine TreeMap sortiert die Schlüssel nach ihrer natürlichen Ordnung.
Das folgende Beispiel sammelt die Titel aller Autor:innen in eine TreeMap, alphabetisch nach Namen sortiert:
Map<String, List<String>> titlesByAuthor = BOOKS.stream()
    .collect(groupingBy(Book::author, TreeMap::new, mapping(Book::title, toList())));
{Bram Stoker=[Dracula],
H. G. Wells=[The Time Machine, The War of the Worlds],
Herman Melville=[Moby-Dick],
Jane Austen=[Pride and Prejudice],
Jules Verne=[From the Earth to the Moon, Around the World in Eighty Days],
Lewis Carroll=[Alice's Adventures in Wonderland],
Mary Shelley=[Frankenstein],
Robert Louis Stevenson=[Treasure Island, Kidnapped]}Aus jedem Buch macht hier der Downstream-Collector mapping() seinen Titel; wie mapping() funktioniert, erklärt der Abschnitt Werte umrechnen.
Downstream-Collectors
Der Downstream-Collector entscheidet, was in der Map unter einem Schlüssel steht: die Elemente selbst, ein Feld der Elemente, eine Zahl oder ein ganz anderes Objekt.
Die folgende Tabelle zeigt die Collectors der Klasse Collectors, die du am häufigsten als Downstream-Collector einsetzt – mit dem Ergebnis, das sie pro Gruppe liefern, und der Java-Version, seit der es sie gibt. T ist der Typ der Elemente.
mapping(), filtering() und flatMapping() bekommen als zweites Argument selbst einen Collector, im Javadoc downstream genannt. Die Tabelle nennt ihn den inneren Collector:
| Collector | Ergebnis pro Gruppe | Seit |
|---|---|---|
toList() | List<T> | Java 8 |
toSet() | Set<T> | Java 8 |
toCollection() | eine Collection deiner Wahl | Java 8 |
toUnmodifiableList(),toUnmodifiableSet() | unveränderliche List<T> bzw. Set<T> | Java 10 |
mapping(mapper, downstream) | Ergebnis des inneren Collectors downstream über die umgerechneten Elemente | Java 8 |
filtering(predicate, downstream) | Ergebnis des inneren Collectors downstream über die Elemente, die eine Bedingung erfüllen | Java 9 |
flatMapping(mapper, downstream) | Ergebnis des inneren Collectors downstream über die Elemente der Streams, die eine Funktion pro Element liefert | Java 9 |
counting() | Anzahl als Long | Java 8 |
summingInt(),summingLong(),summingDouble() | Summe als Integer, Long bzw. Double | Java 8 |
averagingInt(),averagingLong(),averagingDouble() | Mittelwert als Double | Java 8 |
summarizingInt(),summarizingLong(),summarizingDouble() | Anzahl, Summe, Minimum, Mittelwert und Maximum in einem Objekt | Java 8 |
minBy(), maxBy() | kleinstes bzw. größtes Element als Optional<T> | Java 8 |
joining() | verbundene Strings | Java 8 |
reducing() | Ergebnis einer Reduktion | Java 8 |
collectingAndThen() | Ergebnis eines Collectors, durch eine Funktion nachbearbeitet | Java 8 |
teeing() | Ergebnis zweier Collectors, durch eine Funktion verbunden | Java 12 |
groupingBy(), toMap(),partitioningBy() | eine weitere Map | Java 8 |
Die folgenden Abschnitte gehen die Tabelle durch. toList() kennst du schon aus den bisherigen Beispielen. toUnmodifiableList() und toUnmodifiableSet() arbeiten wie toList() und toSet() – sie liefern seit Java 10 unveränderliche Collections.
Werte umrechnen: mapping()
Mit groupingBy() allein enthalten die Gruppen ganze Book-Objekte. Meist brauchst du aber nur ein Feld, z. B. den Titel.
mapping() ist dafür das Gegenstück zur Stream-Operation map(): Es rechnet jedes Element mit einer Funktion um und reicht das Ergebnis an seinen inneren Collector weiter, den Collector im zweiten Argument.
Das folgende Beispiel sammelt die Titel pro Autor:in in Listen:
Map<String, List<String>> titlesByAuthor = BOOKS.stream()
    .collect(groupingBy(Book::author, mapping(Book::title, toList())));
{Bram Stoker=[Dracula],
Robert Louis Stevenson=[Treasure Island, Kidnapped],
Mary Shelley=[Frankenstein],
Jane Austen=[Pride and Prejudice],
Lewis Carroll=[Alice's Adventures in Wonderland],
Herman Melville=[Moby-Dick],
Jules Verne=[From the Earth to the Moon, Around the World in Eighty Days],
H. G. Wells=[The Time Machine, The War of the Worlds]}mapping() braucht einen inneren Collector, hier toList(). Ein Downstream-Collector kann also seinerseits einen inneren Collector haben – die Collectors lassen sich beliebig tief schachteln.
Strings verbinden: joining()
joining() verbindet Strings zu einem einzigen String.
Das folgende Beispiel verbindet mit joining() als innerem Collector von mapping() die Titel jeder Gruppe, getrennt durch Komma und Leerzeichen:
Map<String, String> titlesByAuthor = BOOKS.stream()
    .collect(groupingBy(Book::author, mapping(Book::title, joining(", "))));

System.out.println(titlesByAuthor.get("Robert Louis Stevenson"));
Treasure Island, Kidnappedjoining() sammelt die Strings jeder Gruppe in einem StringJoiner, und der Aufwand wächst linear mit der Zahl der Titel. Mit toMap() und einer Merge-Funktion, die zwei Strings verbindet, würde er dagegen quadratisch wachsen – das zeigt der Artikel über toMap() im Abschnitt Werte verketten.
Eine Collection wählen: toSet() und toCollection()
Das folgende Beispiel sammelt pro Genre die Namen der Autor:innen und gibt sie für das Genre ADVENTURE aus:
Map<Genre, List<String>> authorsByGenre = BOOKS.stream()
    .collect(groupingBy(Book::genre, mapping(Book::author, toList())));

System.out.println(authorsByGenre.get(Genre.ADVENTURE));
[Herman Melville, Jules Verne, Robert Louis Stevenson, Robert Louis Stevenson]Robert Louis Stevenson steht zweimal in der Liste, denn er hat zwei Abenteuerbücher geschrieben. Mit toSet() statt toList() sammelt mapping() die Namen in ein Set, und jeder Name steht nur einmal darin – in der Reihenfolge des HashSet, also ohne feste Ordnung.
toCollection() sammelt in eine Collection deiner Wahl. Es bekommt einen Supplier, der eine neue, leere Collection erzeugt.
Mit TreeSet::new als Supplier sammelt toCollection() die Namen in ein TreeSet. Ein TreeSet nimmt jeden Wert nur einmal auf und hält seine Elemente sortiert, bei Strings alphabetisch.
Das folgende Beispiel sammelt die Namen der Autor:innen pro Genre in ein TreeSet und gibt sie für das Genre ADVENTURE aus:
Map<Genre, Set<String>> authorsByGenre = BOOKS.stream()
    .collect(groupingBy(
        Book::genre,
        mapping(Book::author, toCollection(TreeSet::new))));

System.out.println(authorsByGenre.get(Genre.ADVENTURE));
[Herman Melville, Jules Verne, Robert Louis Stevenson]Zählen: counting()
counting() zählt die Elemente jeder Gruppe.
Das folgende Beispiel zählt die Bücher pro Autor:in:
Map<String, Long> bookCountByAuthor = BOOKS.stream()
    .collect(groupingBy(Book::author, counting()));
{Bram Stoker=1,
Robert Louis Stevenson=2,
Mary Shelley=1,
Jane Austen=1,
Lewis Carroll=1,
Herman Melville=1,
Jules Verne=2,
H. G. Wells=2}Die Anzahl ist immer vom Typ Long, denn counting() ist im JDK als summingLong(e -> 1L) implementiert: Es addiert für jedes Element eine 1L.
Brauchst du die Anzahl als Integer, zählst du mit summingInt() und einer Funktion, die für jedes Element 1 liefert:
Map<String, Integer> bookCountByAuthor = BOOKS.stream()
    .collect(groupingBy(Book::author, summingInt(book -> 1)));

System.out.println(bookCountByAuthor.get("Jules Verne"));2summingInt() addiert die Werte, die eine ToIntFunction aus den Elementen berechnet – mit book -> 1 ist die Summe die Anzahl. Ich empfehle dir trotzdem counting(), solange du nicht ausdrücklich ein Integer brauchst, denn es sagt mit seinem Namen, was es tut.
Mittelwert und Statistik: averagingInt() und summarizingInt()
averagingInt() berechnet den Mittelwert der Werte, die eine Funktion aus den Elementen liefert.
Das folgende Beispiel berechnet das mittlere Erscheinungsjahr pro Genre:
Map<Genre, Double> averageYearByGenre = BOOKS.stream()
    .collect(groupingBy(Book::genre, averagingInt(Book::year)));
{GOTHIC=1857.5,
SCIENCE_FICTION=1886.0,
NOVEL=1813.0,
ADVENTURE=1873.25,
FANTASY=1865.0}Der Mittelwert ist immer ein Double, auch wenn die Werte int sind.
Brauchst du mehrere Kennzahlen derselben Gruppe, liefert summarizingInt() sie in einem Objekt vom Typ IntSummaryStatistics: Anzahl, Summe, Minimum, Mittelwert und Maximum.
Das folgende Beispiel gibt diese Statistik für das Genre SCIENCE_FICTION aus:
Map<Genre, IntSummaryStatistics> yearStatsByGenre = BOOKS.stream()
    .collect(groupingBy(Book::genre, summarizingInt(Book::year)));

IntSummaryStatistics stats = yearStatsByGenre.get(Genre.SCIENCE_FICTION);
System.out.println(stats);
IntSummaryStatistics{count=3, sum=5658, min=1865, average=1886,000000, max=1898}Das Komma im Mittelwert kommt aus der Standard-Locale: toString() formatiert den Wert mit String.format(), und das schreibt auf einem deutsch eingestellten System ein Komma.
Die einzelnen Werte liefern die Methoden getCount(), getSum(), getMin(), getAverage() und getMax():
System.out.println(stats.getMin() + "–" + stats.getMax());1865–1898summarizingInt() geht jede Gruppe nur einmal durch. Mit einzelnen Collectors bräuchtest du für Minimum, Maximum und Mittelwert drei Gruppierungen oder verschachtelte teeing()-Aufrufe, die der Abschnitt Zwei Collectors kombinieren vorstellt.
Minimum und Maximum: minBy() und maxBy()
minBy() liefert das kleinste Element jeder Gruppe nach einem Comparator, maxBy() das größte.
Das folgende Beispiel sucht das älteste Buch pro Genre und gibt es für das Genre ADVENTURE aus:
Map<Genre, Optional<Book>> oldestBookByGenre = BOOKS.stream()
    .collect(groupingBy(Book::genre, minBy(Comparator.comparingInt(Book::year))));

System.out.println(oldestBookByGenre.get(Genre.ADVENTURE));
Optional[Book[title=Moby-Dick, author=Herman Melville, year=1851, genre=ADVENTURE]]Das Ergebnis ist ein Optional, denn minBy() kann auch auf einen leeren Stream treffen, wenn du es direkt an collect() übergibst. Als Downstream-Collector von groupingBy() bleibt das Optional dagegen nie leer: groupingBy() legt eine Gruppe erst an, wenn ein Element für sie kommt, also hat jede Gruppe mindestens ein Element.
Im JDK ist minBy() als reducing(BinaryOperator.minBy(comparator)) implementiert. Dasselbe Beispiel mit reducing() zeigt der Artikel über reduce() im Abschnitt Collectors.reducing().
Ergebnis nachbearbeiten: collectingAndThen()
minBy() und maxBy() liefern als Downstream-Collector ein Optional, das du in der Map meist nicht haben willst. collectingAndThen() wendet eine Funktion auf das Ergebnis eines anderen Collectors an.
Das folgende Beispiel sucht mit minBy() das älteste Buch pro Genre, packt das Optional aus und behält nur den Titel:
Map<Genre, String> oldestTitleByGenre = BOOKS.stream()
    .collect(groupingBy(
        Book::genre,
        collectingAndThen(
            minBy(Comparator.comparingInt(Book::year)),
            oldest -> oldest.orElseThrow().title())));
{GOTHIC=Frankenstein,
SCIENCE_FICTION=From the Earth to the Moon,
NOVEL=Pride and Prejudice,
ADVENTURE=Moby-Dick,
FANTASY=Alice's Adventures in Wonderland}orElseThrow() wirft hier nie eine Exception, denn jede Gruppe hat mindestens ein Element. Ohne Optional kommt auch toMap() mit BinaryOperator.minBy() als Merge-Funktion aus – das zeigt der Artikel über toMap() im Abschnitt Das älteste Buch pro Autor:in.
Filtern: filtering()
Seit Java 9 gibt es filtering(). Es reicht nur die Elemente an seinen inneren Collector weiter, die eine Bedingung erfüllen.
Das folgende Beispiel sammelt pro Genre die Titel der Bücher, die nach 1880 erschienen sind:
Map<Genre, List<String>> titlesAfter1880ByGenre = BOOKS.stream()
    .collect(groupingBy(
        Book::genre,
        filtering(book -> book.year() > 1880, mapping(Book::title, toList()))));
{GOTHIC=[Dracula],
SCIENCE_FICTION=[The Time Machine, The War of the Worlds],
NOVEL=[],
ADVENTURE=[Treasure Island, Kidnapped],
FANTASY=[]}Die Genres NOVEL und FANTASY stehen mit leeren Listen in der Map, denn ihre Bücher sind vor 1880 erschienen.
Mit filter() vor dem groupingBy() fehlen sie dagegen ganz:
Map<Genre, List<String>> titlesAfter1880ByGenre = BOOKS.stream()
    .filter(book -> book.year() > 1880)
    .collect(groupingBy(Book::genre, mapping(Book::title, toList())));
{GOTHIC=[Dracula],
SCIENCE_FICTION=[The Time Machine, The War of the Worlds],
ADVENTURE=[Treasure Island, Kidnapped]}filter() entfernt die Bücher, bevor groupingBy() sie sieht. filtering() lässt groupingBy() dagegen jedes Buch sehen und die Gruppe anlegen und filtert erst innerhalb der Gruppe.
Ich empfehle dir filter(), wenn dich nur die Gruppen mit Treffern interessieren, und filtering(), wenn die Map jeden Schlüssel enthalten soll, der in den Daten vorkommt – etwa für einen Bericht, der auch leere Gruppen zeigt. Ein Genre ohne ein einziges Buch in der Bibliothek steht allerdings auch mit filtering() nicht in der Map.
Elemente aufklappen: flatMapping()
Seit Java 9 gibt es flatMapping(), das Gegenstück zur Stream-Operation flatMap(). Es macht aus jedem Element einen Stream und reicht dessen Elemente an seinen inneren Collector weiter.
Für ein Beispiel brauchen wir einen zweiten Record aus dem Artikel über Java Streams.
Ein Author hat einen Namen und eine Liste von Büchern, und die Liste Library.AUTHORS enthält die acht Autor:innen der Bibliothek mit ihren Büchern:
public record Author(String name, List<Book> books) {}Das folgende Beispiel gruppiert die Autor:innen nach der Zahl ihrer Bücher und sammelt die Titel dieser Bücher in einer Liste:
Map<Integer, List<String>> titlesByBookCount = AUTHORS.stream()
    .collect(groupingBy(
        author -> author.books().size(),
        flatMapping(author -> author.books().stream().map(Book::title), toList())));
{1=[Pride and Prejudice, Frankenstein, Moby-Dick, Alice's Adventures in Wonderland, Dracula],
2=[From the Earth to the Moon, Around the World in Eighty Days, Treasure Island, Kidnapped,
The Time Machine, The War of the Worlds]}Mit mapping(Author::books, toList()) bekämst du pro Schlüssel eine Liste von Listen (pro Autor:in eine separate Liste mit Büchern). flatMapping() hängt die Elemente der Streams dagegen in einer einzigen Liste aneinander.
Zwei Collectors kombinieren: teeing()
Seit Java 12 gibt es teeing(). Es reicht jedes Element an zwei Collectors weiter und verbindet deren Ergebnisse am Ende mit einer Funktion.
Das folgende Beispiel sucht pro Genre das älteste und das jüngste Buch und legt beide Titel in einem Record ab:
record OldestAndNewest(String oldest, String newest) {}

Map<Genre, OldestAndNewest> oldestAndNewestByGenre = BOOKS.stream()
    .collect(groupingBy(
        Book::genre,
        teeing(
            minBy(Comparator.comparingInt(Book::year)),
            maxBy(Comparator.comparingInt(Book::year)),
            (oldest, newest) -> new OldestAndNewest(
                oldest.orElseThrow().title(), newest.orElseThrow().title()))));

System.out.println(oldestAndNewestByGenre.get(Genre.SCIENCE_FICTION));
OldestAndNewest[oldest=From the Earth to the Moon, newest=The War of the Worlds]Die beiden Collectors minBy() und maxBy() sehen jedes Buch der Gruppe, und die Funktion im dritten Argument bekommt ihre beiden Ergebnisse. Ohne teeing() müsstest du dafür zwei Streams erzeugen und zweimal gruppieren.
Reduzieren: reducing()
reducing() fasst die Elemente einer Gruppe mit einer Funktion zusammen, die zwei Werte zu einem verbindet – so wie die Stream-Operation reduce(). Für die häufigen Fälle gibt es fertige Collectors wie counting(), summingInt() und minBy(), die mit ihrem Namen sagen, was sie tun. Wann du reducing() trotzdem brauchst und welche drei Varianten es gibt, zeigt der Artikel über reduce() im Abschnitt Collectors.reducing().
Eine weitere Map: groupingBy(), toMap() und partitioningBy()
Ist der Downstream-Collector selbst ein Collector, der eine Map baut, wird der Wert jeder Gruppe zu einer Map.
- Mit
groupingBy()auch als Downstream-Collector gruppierst du über mehrere Ebenen – das zeigt der nächste Abschnitt. - Ein Beispiel mit
toMap()als Downstream-Collector zeigt der Artikel übertoMap()im Abschnitt Verschachtelte Maps. partitioningBy()hat einen eigenen Abschnitt in diesem Artikel.
Über mehrere Ebenen gruppieren
Mit groupingBy() auch als Downstream-Collector teilst du jede Gruppe in weitere Gruppen auf.
Das folgende Beispiel gruppiert die Bücher nach Genre in eine EnumMap und innerhalb jedes Genres nach Autor:in in eine TreeMap:
Map<Genre, Map<String, List<String>>> titlesByAuthorByGenre = BOOKS.stream()
    .collect(groupingBy(
        Book::genre,
        () -> new EnumMap<>(Genre.class),
        groupingBy(Book::author, TreeMap::new, mapping(Book::title, toList()))));

titlesByAuthorByGenre.forEach((genre, titlesByAuthor) ->
    System.out.println(genre + ": " + titlesByAuthor));
NOVEL: {Jane Austen=[Pride and Prejudice]}
GOTHIC: {Bram Stoker=[Dracula],
Mary Shelley=[Frankenstein]}
ADVENTURE: {Herman Melville=[Moby-Dick],
Jules Verne=[Around the World in Eighty Days],
Robert Louis Stevenson=[Treasure Island, Kidnapped]}
FANTASY: {Lewis Carroll=[Alice's Adventures in Wonderland]}
SCIENCE_FICTION: {H. G. Wells=[The Time Machine, The War of the Worlds],
Jules Verne=[From the Earth to the Moon]}Jules Verne steht in zwei Genres, mit je einem Buch.
Sein Abenteuerbuch holst du über beide Ebenen aus der Map:
System.out.println(titlesByAuthorByGenre.get(Genre.ADVENTURE).get("Jules Verne"));[Around the World in Eighty Days]Mit jeder Ebene wird der Typ der Map länger, und jedes get() liefert null, wenn der Schlüssel auf seiner Ebene fehlt.
Ich empfehle dir die verschachtelte Map deshalb, wenn du das Ergebnis Ebene für Ebene durchgehst – etwa für einen Bericht mit einer Überschrift pro Genre. Brauchst du dagegen den Wert zu einer Kombination von Schlüsseln, ist ein zusammengesetzter Schlüssel einfacher. Den zeigt der Abschnitt Nach mehreren Feldern gruppieren.
Den Schlüssel wählen
Berechnete Schlüssel
Der Classifier muss nicht zwingend ein Feld zurückgeben. Er kann den Schlüssel auch aus dem Element berechnen.
Das folgende Beispiel gruppiert die Bücher nach dem Jahrzehnt, in dem sie erschienen sind, und sortiert danach die Jahrzehnte mit einer TreeMap:
Map<Integer, List<String>> titlesByDecade = BOOKS.stream()
    .collect(groupingBy(
        book -> book.year() / 10 * 10,
        TreeMap::new,
        mapping(Book::title, toList())));
{1810=[Pride and Prejudice, Frankenstein],
1850=[Moby-Dick],
1860=[From the Earth to the Moon, Alice's Adventures in Wonderland],
1870=[Around the World in Eighty Days],
1880=[Treasure Island, Kidnapped],
1890=[The Time Machine, Dracula, The War of the Worlds]}Die Ganzzahldivision book.year() / 10 schneidet die letzte Ziffer ab, und * 10 macht daraus wieder eine Jahreszahl: aus 1897 wird 189 und daraus 1890. Jahrzehnte ohne Buch, wie die 1820er, stehen nicht in der Map.
Nach mehreren Feldern gruppieren
Willst du nach zwei Feldern zugleich gruppieren, brauchst du einen Schlüssel, der beide enthält. Ein Record ist dafür die passende Wahl: Er erzeugt equals() und hashCode() aus seinen Komponenten, und zwei Records mit denselben Werten sind derselbe Schlüssel.
Das folgende Beispiel zählt die Bücher pro Kombination aus Autor:in und Genre:
record AuthorAndGenre(String author, Genre genre) {}

Map<AuthorAndGenre, Long> bookCountByAuthorAndGenre = BOOKS.stream()
    .collect(groupingBy(
        book -> new AuthorAndGenre(book.author(), book.genre()),
        LinkedHashMap::new,
        counting()));

bookCountByAuthorAndGenre.forEach((key, count) ->
    System.out.println(key + "=" + count));
AuthorAndGenre[author=Jane Austen, genre=NOVEL]=1
AuthorAndGenre[author=Mary Shelley, genre=GOTHIC]=1
AuthorAndGenre[author=Herman Melville, genre=ADVENTURE]=1
AuthorAndGenre[author=Jules Verne, genre=SCIENCE_FICTION]=1
AuthorAndGenre[author=Lewis Carroll, genre=FANTASY]=1
AuthorAndGenre[author=Jules Verne, genre=ADVENTURE]=1
AuthorAndGenre[author=Robert Louis Stevenson, genre=ADVENTURE]=2
AuthorAndGenre[author=H. G. Wells, genre=SCIENCE_FICTION]=2
AuthorAndGenre[author=Bram Stoker, genre=GOTHIC]=1Die LinkedHashMap gibt die Autor-Genre-Kombinationen in derjenigen Reihenfolge aus, in der sie in der Bibliothek zum ersten Mal vorkommen.
Den Wert zu einer Kombination holst du mit einem neuen Record derselben Werte:
AuthorAndGenre key = new AuthorAndGenre("Jules Verne", Genre.ADVENTURE);
System.out.println(bookCountByAuthorAndGenre.get(key));1Naheliegend wäre auch, die beiden Felder zu einem String zu verbinden, z. B. mit book -> book.author() + "-" + book.genre(). Das funktioniert, verliert aber die Typen: Aus dem Schlüssel Jules Verne-ADVENTURE bekommst du das Genre nur zurück, indem du den String wieder zerlegst, und ein Name, der selbst einen Bindestrich enthält, macht das Zerlegen mehrdeutig. Ich empfehle dir deshalb einen Record als Schlüssel.
null-Schlüssel
Liefert der Classifier für ein Element null, wirft groupingBy() eine NullPointerException.
Das folgende Beispiel hängt „The Invisible Man“ von H. G. Wells als zwölftes Buch an die Bibliothek an, ohne Genre:
List<Book> books = new ArrayList<>(BOOKS);
books.add(new Book("The Invisible Man", "H. G. Wells", 1897, null));

Map<Genre, List<Book>> booksByGenre = books.stream()
    .collect(groupingBy(Book::genre));
java.lang.NullPointerException: element cannot be mapped to a null key
at java.base/java.util.Objects.requireNonNull(Objects.java:246)
at java.base/java.util.stream.Collectors.lambda$groupingBy$0(Collectors.java:1113)Die beiden Zeilen des Stack-Traces zeigen, woher die Exception kommt: groupingBy() prüft jeden Schlüssel mit Objects.requireNonNull(), bevor es ihn in die Map einfügt – auch dann, wenn die Map wie eine HashMap einen null-Schlüssel annehmen würde. Darin unterscheidet es sich von toMap(), das einen null-Schlüssel annimmt, sofern die Map ihn erlaubt. Die Meldung nennt das Element nicht, für das der Schlüssel fehlt.
Wie du damit umgehst, hängt davon ab, ob die Elemente ohne Schlüssel in das Ergebnis gehören.
Gehören sie nicht hinein, filterst du sie vorher heraus:
Map<Genre, Long> bookCountByGenre = books.stream()
    .filter(book -> book.genre() != null)
    .collect(groupingBy(Book::genre, counting()));
{SCIENCE_FICTION=3,
NOVEL=1,
FANTASY=1,
ADVENTURE=4,
GOTHIC=2}Sollen sie eine eigene Gruppe bilden, verpackst du den Schlüssel in ein Optional. Die Bücher ohne Genre stehen dann unter dem Schlüssel Optional.empty().
Das folgende Beispiel sammelt die Titel pro Genre und gibt die Gruppe ohne Genre aus:
Map<Optional<Genre>, List<String>> titlesByGenre = books.stream()
    .collect(groupingBy(
        book -> Optional.ofNullable(book.genre()),
        mapping(Book::title, toList())));

System.out.println(titlesByGenre.get(Optional.empty()));
[The Invisible Man]Gehört das Enum zu deinem eigenen Code, ist eine eigene Konstante wie UNKNOWN für den fehlenden Wert die klarere Lösung, denn dann muss niemand mit Optional-Schlüsseln arbeiten.
partitioningBy()
Collectors.partitioningBy() teilt die Elemente nach einer Ja-Nein-Frage in genau zwei Gruppen auf. Statt eines Classifiers bekommt es ein Predicate, und die Schlüssel der Map sind true und false.
Das folgende Beispiel teilt die Bücher in die, die vor 1850 erschienen sind, und die übrigen:
Map<Boolean, List<Book>> booksBefore1850 = BOOKS.stream()
    .collect(partitioningBy(book -> book.year() < 1850));

System.out.println(booksBefore1850.get(true));
[Book[title=Pride and Prejudice, author=Jane Austen, year=1813, genre=NOVEL],
Book[title=Frankenstein, author=Mary Shelley, year=1818, genre=GOTHIC]]Wie groupingBy() nimmt partitioningBy() als zweites Argument einen Downstream-Collector:
Map<Boolean, List<String>> titlesBefore1850 = BOOKS.stream()
    .collect(partitioningBy(
        book -> book.year() < 1850,
        mapping(Book::title, toList())));
{false=[Moby-Dick, From the Earth to the Moon, Alice's Adventures in Wonderland,
Around the World in Eighty Days, Treasure Island, Kidnapped, The Time Machine,
Dracula, The War of the Worlds],
true=[Pride and Prejudice, Frankenstein]}Eine dritte Variante mit Map-Typ gibt es nicht.
Dieselben Gruppen bekämst du auch mit groupingBy(book -> book.year() < 1850). Der Unterschied zeigt sich, wenn eine der beiden Gruppen leer ist.
Das folgende Beispiel zählt die Bücher, die vor 1800 erschienen sind – zuerst mit partitioningBy(), dann mit groupingBy():
Map<Boolean, Long> countBefore1800 = BOOKS.stream()
    .collect(partitioningBy(book -> book.year() < 1800, counting()));

Map<Boolean, Long> countBefore1800Grouped = BOOKS.stream()
    .collect(groupingBy(book -> book.year() < 1800, counting()));
{false=11, true=0}
{false=11}Laut Javadoc enthält die Map von partitioningBy() immer beide Schlüssel. Im JDK ist sie ein Objekt der privaten Klasse Collectors.Partition mit genau zwei Feldern, forTrue und forFalse. Für beide legt partitioningBy() schon zu Beginn ein leeres Zwischenergebnis des Downstream-Collectors an. Bei groupingBy() fehlt dagegen der Schlüssel true, denn kein Buch hat ihn geliefert, und get(true) liefert null.
Ich empfehle dir partitioningBy() für jede Aufteilung nach einer Ja-Nein-Frage: Der Name sagt, was passiert, und get(true) und get(false) liefern nie null.
Das Ergebnis sortieren
Nach dem Schlüssel
Nach dem Schlüssel sortierst du, indem du explizit eine sortierte Map wählst: eine TreeMap für die natürliche Ordnung, eine EnumMap für die Reihenfolge der Enum-Konstanten. Beispiele dafür zeigt der Abschnitt über die Variante mit eigenem Map-Typ.
Nach dem Wert
TreeMap und EnumMap sortieren nur nach dem Schlüssel. Für eine Sortierung nach dem Wert streamst du deshalb die Einträge der fertigen Map, sortierst sie nach Wert und sammelst sie dann in eine LinkedHashMap, die die neue Reihenfolge behält.
Das folgende Beispiel sortiert die Autor:innen absteigend nach der Zahl ihrer Bücher und bei gleicher Zahl alphabetisch:
Map<String, Long> bookCountByAuthor = BOOKS.stream()
    .collect(groupingBy(Book::author, counting()));

Map<String, Long> sortedByCount = bookCountByAuthor.entrySet().stream()
    .sorted(Map.Entry.<String, Long>comparingByValue()
        .reversed()
        .thenComparing(Map.Entry.comparingByKey()))
    .collect(toMap(
        Map.Entry::getKey,
        Map.Entry::getValue,
        (first, second) -> first,
        LinkedHashMap::new));
{H. G. Wells=2,
Jules Verne=2,
Robert Louis Stevenson=2,
Bram Stoker=1,
Herman Melville=1,
Jane Austen=1,
Lewis Carroll=1,
Mary Shelley=1}Die Typangabe <String, Long> vor comparingByValue() braucht der Compiler: Ohne sie leitet er den Typ der Einträge nicht ab, sobald reversed() folgt, und meldet incompatible types. Wie reversed() und thenComparing() funktionieren, erklärt der Artikel über Comparator und Comparable.
Die Merge-Funktion (first, second) -> first wird nie aufgerufen, denn die Schlüssel sind eindeutig – sie steht nur da, weil die toMap()-Variante mit Map-Typ eine verlangt.
Brauchst du nur die ersten Einträge, z. B. die drei Autor:innen mit den meisten Büchern, begrenzt limit() den Stream der Einträge:
List<String> topAuthors = bookCountByAuthor.entrySet().stream()
    .sorted(Map.Entry.<String, Long>comparingByValue()
        .reversed()
        .thenComparing(Map.Entry.comparingByKey()))
    .limit(3)
    .map(Map.Entry::getKey)
    .toList();
[H. G. Wells, Jules Verne, Robert Louis Stevenson]Innerhalb der Gruppen
Die Elemente einer Gruppe stehen in der Reihenfolge des Streams. Sortierst du den Stream vor dem groupingBy(), sind deshalb auch die Elemente jeder Gruppe sortiert.
Das folgende Beispiel sortiert die Titel jedes Genres alphabetisch:
Map<Genre, List<String>> titlesByGenre = BOOKS.stream()
    .sorted(Comparator.comparing(Book::title))
    .collect(groupingBy(
        Book::genre,
        () -> new EnumMap<>(Genre.class),
        mapping(Book::title, toList())));

titlesByGenre.forEach((genre, titles) -> System.out.println(genre + "=" + titles));
NOVEL=[Pride and Prejudice]
GOTHIC=[Dracula, Frankenstein]
ADVENTURE=[Around the World in Eighty Days, Kidnapped, Moby-Dick, Treasure Island]
FANTASY=[Alice's Adventures in Wonderland]
SCIENCE_FICTION=[From the Earth to the Moon, The Time Machine, The War of the Worlds]groupingBy() vs. toMap()
Sowohl groupingBy() als auch toMap() bauen eine Map. toMap() speichert pro Schlüssel genau einen Wert und wirft bei einem zweiten eine IllegalStateException, solange du keine Merge-Funktion angibst. groupingBy() rechnet dagegen von vornherein mit mehreren Elementen pro Schlüssel.
Ich empfehle dir groupingBy(), sobald ein Schlüssel mehrere Werte haben kann, und toMap(), wenn er genau einen hat. Wie beide Collectors dieselbe Aufgabe lösen und wo welcher besser passt, zeigt der Artikel über toMap() im Abschnitt toMap() vs. groupingBy().
groupingBy() in parallelen Streams und groupingByConcurrent()
In einem parallelen Stream sammelt groupingBy() jedes Teilstück in eine eigene Map und führt die Maps danach paarweise zusammen: Es fügt jeden Eintrag der einen Map mit merge() in die andere ein, und bei einem Schlüssel, den beide Maps haben, verbindet der Downstream-Collector die beiden Gruppen. Das Javadoc warnt, dass dieses Zusammenführen teuer sein kann.
Die Reihenfolge bleibt dabei erhalten: Der Downstream-Collector toList() hängt die Gruppe des hinteren Teilstücks an die des vorderen, sodass auch parallel jede Liste in der Reihenfolge des Streams steht.
Collectors.groupingByConcurrent() geht einen anderen Weg. Es hat dieselben drei Varianten wie groupingBy(), und alle Threads sammeln in eine gemeinsame ConcurrentMap – ohne Angabe eines Map-Typs in eine ConcurrentHashMap. Das Javadoc stellt dafür eine bessere Performance in parallelen Streams in Aussicht.
Voraussetzung für groupingByConcurrent() ist, dass die Reihenfolge innerhalb der Gruppen keine Rolle spielt. Denn die Threads fügen ihre Elemente gleichzeitig in die Gruppen ein, und in welcher Reihenfolge die Elemente in einer Liste landen, ist Zufall.
Das folgende Beispiel ordnet die Zahlen von 0 bis 99.999 nach ihrem Rest bei der Division durch drei und gibt die ersten fünf Zahlen der Gruppe mit dem Rest 0 (also die ohne Rest durch drei teilbaren Zahlen) aus – zuerst mit groupingBy(), dann mit groupingByConcurrent():
Map<Integer, List<Integer>> byRemainder = IntStream.range(0, 100_000)
    .boxed()
    .parallel()
    .collect(groupingBy(i -> i % 3));

Map<Integer, List<Integer>> byRemainderConcurrent = IntStream.range(0, 100_000)
    .boxed()
    .parallel()
    .collect(groupingByConcurrent(i -> i % 3));

System.out.println(byRemainder.get(0).subList(0, 5));
System.out.println(byRemainderConcurrent.get(0).subList(0, 5));
In fünf Läufen liefert groupingBy() fünfmal dieselben Zahlen, die kleinsten der Gruppe:
[0, 3, 6, 9, 12]
[0, 3, 6, 9, 12]
[0, 3, 6, 9, 12]
[0, 3, 6, 9, 12]
[0, 3, 6, 9, 12]
groupingByConcurrent() liefert in fünf Läufen fünf verschiedene:
[66408, 66411, 66414, 66417, 66420]
[66408, 16407, 66411, 16410, 66414]
[91407, 91410, 91413, 91416, 91419]
[57813, 57816, 57819, 57822, 57825]
[34377, 34380, 34383, 34386, 34389]Schneller ist groupingByConcurrent() auch nicht automatisch. Hat der Downstream-Collector nicht die Eigenschaft CONCURRENT – und toList() hat sie nicht –, fügt groupingByConcurrent() jedes Element in einem synchronized-Block in seine Gruppe ein. Bei nur wenigen Schlüsseln in der Map warten die Threads dann aufeinander. In der Messung im Artikel über parallele Streams war groupingByConcurrent() deshalb langsamer als groupingBy() – die Zahlen stehen im Abschnitt Die Kosten des Zusammenfügens bei Collectors.
Ich empfehle dir groupingByConcurrent() deshalb nur für parallele Streams, bei denen die Reihenfolge innerhalb der Gruppen keine Rolle spielt und eine Messung zeigt, dass es schneller ist als groupingBy().
Häufige Fehler
get() liefert null für eine fehlende Gruppe
Eine Gruppe gibt es nur für Schlüssel, die mindestens ein Element geliefert haben. Für jeden anderen Schlüssel liefert get() den Wert null.
Das folgende Beispiel gruppiert die Bücher, die nach 1880 erschienen sind, und fragt nach der Zahl der Romane:
Map<Genre, List<Book>> booksAfter1880ByGenre = BOOKS.stream()
    .filter(book -> book.year() > 1880)
    .collect(groupingBy(Book::genre));

int novelCount = booksAfter1880ByGenre.get(Genre.NOVEL).size();
java.lang.NullPointerException: Cannot invoke "java.util.List.size()" because the return value of "java.util.Map.get(Object)" is nullNach 1880 ist kein Roman erschienen, also gibt es die Gruppe NOVEL nicht.
getOrDefault() liefert für einen fehlenden Schlüssel den Wert, den du als zweites Argument übergibst:
int novelCount = booksAfter1880ByGenre.getOrDefault(Genre.NOVEL, List.of()).size();0Soll die Gruppe in der Map stehen, auch wenn sie leer ist, filterst du mit filtering() statt mit filter(), wie im Abschnitt Filtern gezeigt.
counting() liefert Long, nicht Integer
Das folgende Beispiel versucht, die Anzahl der Bücher pro Autor:in in eine Map<String, Integer> zu sammeln:
Map<String, Integer> bookCountByAuthor = BOOKS.stream()
    .collect(groupingBy(Book::author, counting()));
Der Compiler weist den Code ab:
error: incompatible types: inference variable D has incompatible equality constraints Integer,LongD ist der Typparameter für das Ergebnis des Downstream-Collectors, und counting() liefert Long. Deklariere die Map als Map<String, Long> – oder zähle mit summingInt(book -> 1), wenn du Integer brauchst, wie im Abschnitt Zählen gezeigt.
Map-Typ ohne Downstream-Collector
Das folgende Beispiel versucht, die Bücher in Listen in einer TreeMap zu gruppieren, und übergibt dafür nur Classifier und Map-Typ:
Map<Genre, List<Book>> booksByGenre = BOOKS.stream()
    .collect(groupingBy(Book::genre, TreeMap::new));
Der Compiler findet keine passende Variante:
error: no suitable method found for groupingBy(Book::genre,TreeMap::new)Die Variante mit Map-Typ hat drei Parameter, und der Downstream-Collector steht hinter dem Map-Typ.
Mit toList() als drittem Argument kompiliert das Beispiel:
Map<Genre, List<Book>> booksByGenre = BOOKS.stream()
    .collect(groupingBy(Book::genre, TreeMap::new, toList()));
Zusammenfassung
groupingBy() gruppiert die Elemente eines Streams nach einem Schlüssel, den der Classifier für jedes Element berechnet. Ohne weiteres Argument wird jede Gruppe eine Liste. Mit einem Downstream-Collector als zweitem Argument bestimmst du, was aus jeder Gruppe wird – z. B. eine Anzahl mit counting(), eine Liste von Titeln mit mapping() oder das älteste Buch mit minBy(). Die dritte Variante bestimmt mit einem Argument zwischen Classifier und Downstream-Collector den Typ der Map und damit die Reihenfolge der Schlüssel.
groupingBy() lehnt null-Schlüssel mit einer NullPointerException ab, und einen Schlüssel ohne Element gibt es in der Map nicht. partitioningBy() teilt die Elemente nach einer Ja-Nein-Frage auf, und seine Map enthält immer beide Schlüssel.
Fünf Empfehlungen für den Alltag:
- Nimm
groupingBy(), sobald ein Schlüssel mehrere Elemente haben kann, undtoMap(), wenn er genau einen hat. - Fasse die Elemente jeder Gruppe mit einem Downstream-Collector zusammen, statt die Listen nach dem Gruppieren erneut zu durchlaufen.
- Verlass dich nicht auf die Reihenfolge der Map; übergib
TreeMap::new,LinkedHashMap::newoder für Enum-Schlüssel eineEnumMap, wenn du eine bestimmte Reihenfolge brauchst. - Gruppiere nach mehreren Feldern mit einem Record als Schlüssel.
- Nimm
partitioningBy()für eine Aufteilung nach einer Ja-Nein-Frage.
Wie collect() in eine Stream-Pipeline passt und welche Collectors es außerdem gibt, zeigt der Artikel über Java Streams.
Wenn dir der Artikel weitergeholfen hat, würde ich mich sehr über eine positive Bewertung auf meinem ProvenExpert-Profil freuen. Dein Feedback hilft mir, meine Inhalte weiter zu verbessern und motiviert mich, neue informative Artikel zu schreiben.