Virtuelle Threads („virtual threads“) sind eine der wichtigsten Neuerungen in Java seit Langem. Sie wurden in Project Loom entwickelt und sind seit Java 19 als Preview-Feature im JDK enthalten und seit Java 21 in ihrer finalen Version (JEP 444).
In diesem Artikel erfährst du:
- Warum brauchen wir virtuelle Threads?
- Was sind virtuelle Threads, und wie funktionieren sie?
- Wie setzt man virtuelle Threads ein?
- Wie erzeugt man virtuelle Threads, und wie viele virtuelle Threads lassen sich starten?
- Wie verwendet man virtuelle Threads in Jakarta EE, Quarkus und Spring?
- Was sind die Vorteile von virtuellen Threads?
- Was sind virtuelle Threads nicht, und welche Einschränkungen weisen sie auf?
Beginnen wir bei der Herausforderung, die zur Entwicklung virtueller Threads geführt hat.
Warum brauchen wir virtuelle Threads?
Wer jemals eine Backend-Anwendung unter hoher Last betreut hat, weiß: Threads sind oft das Bottleneck. Denn für jeden eingehenden Request wird ein Thread benötigt, der den Request abarbeitet. Ein Java-Thread entspricht einem Betriebssystem-Thread, und diese sind ressourcenhungrig:
- Ein Betriebssystem-Thread reserviert 1 MB für den Stack im Voraus und committet 32 oder 64 KB davon, je nach Betriebssystem.
- Es dauert etwa 1 ms, um einen Betriebssystem-Thread zu starten.
- Context-Switches finden im Kernel-Space statt und sind recht CPU-intensiv.
Mehr als ein paar Tausend sollte man also nicht starten, sonst riskiert man die Stabilität des gesamten Systems.
Ein paar Tausend reichen jedoch nicht immer – insbesondere dann nicht, wenn die Bearbeitung eines Requests länger dauert, weil auf blockierende Datenstrukturen, wie z. B. Queues, Locks oder externe Dienste wie Datenbanken, Microservices oder Cloud-APIs gewartet werden muss.
Wenn ein Request beispielsweise zwei Sekunden dauert und wir den Thread-Pool auf 1.000 Threads limitieren, dann könnten maximal 500 Anfragen pro Sekunde beantwortet werden. Die CPU wäre aber bei weitem nicht ausgelastet, da sie die meiste Zeit auf die Antworten der externen Dienste warten würde, selbst wenn pro CPU-Core mehrere Threads bedient werden.
Bislang konnten wir dieses Problem nur mit asynchroner Programmierung bewältigen – z. B. mit CompletableFuture oder reaktiven Frameworks wie RxJava und Project Reactor.
Wer allerdings schon einmal Code wie den folgenden warten musste, weiß, dass asynchroner Code um ein Vielfaches komplexer ist als sequentieller Code – und absolut keinen Spaß macht.
public CompletionStage<Response> getProduct(String productId) {
  return productService
      .getProductAsync(productId)
      .thenCompose(
        product -> {
          if (product.isEmpty()) {
            return CompletableFuture.completedFuture(
                Response.status(Status.NOT_FOUND).build());
          }

          return warehouseService
              .isAvailableAsync(productId)
              .thenCompose(
                  available ->
                      available
                          ? CompletableFuture.completedFuture(0)
                          : supplierService.getDeliveryTimeAsync(
                              product.get().supplier(), productId))
              .thenApply(
                  daysUntilShippable ->
                      Response.ok(
                          new ProductPageResponse(
                              product.get(), daysUntilShippable))
                          .build());
          });
}
Nicht nur, dass dieser Code kaum lesbar ist, er ist auch extrem schwer zu debuggen. Beispielsweise würde es hier keinen Sinn ergeben, einen Breakpoint zu setzen, denn der Code definiert nur den asynchronen Flow, führt ihn aber nicht aus. Ausgeführt wird der eigentliche Business-Code erst zu einem späteren Zeitpunkt in einem dafür vorgesehenen Thread-Pool.
Darüber hinaus müssen die eingesetzten Datenbanktreiber und Treiber für andere externe Dienste das asynchrone, nicht-blockierende Modell ebenso unterstützen.
Was sind virtuelle Threads?
Virtuelle Threads lösen das Problem auf eine Art und Weise, die es uns wieder erlaubt, leicht lesbaren und wartbaren Code zu schreiben. Virtuelle Threads fühlen sich aus Sicht des Java-Codes wie ganz normale Threads an, werden aber nicht 1:1 auf Betriebssystem-Threads gemappt.
Stattdessen gibt es einen Pool sogenannter Carrier-Threads („Träger-Threads“), auf die ein virtueller Thread vorübergehend gemappt wird (englisch: „mounted“). Sobald der virtuelle Thread auf eine blockierende Operation stößt, wird der virtuelle Thread vom Carrier-Thread genommen (englisch: „unmounted“), und der Carrier-Thread kann einen anderen virtuellen Thread (einen neuen oder einen zuvor blockierten) ausführen.
Die folgende Grafik stellt diese M:N-Zuordnung von virtuellen Threads zu Carrier-Threads und damit zu Betriebssystem-Threads dar:
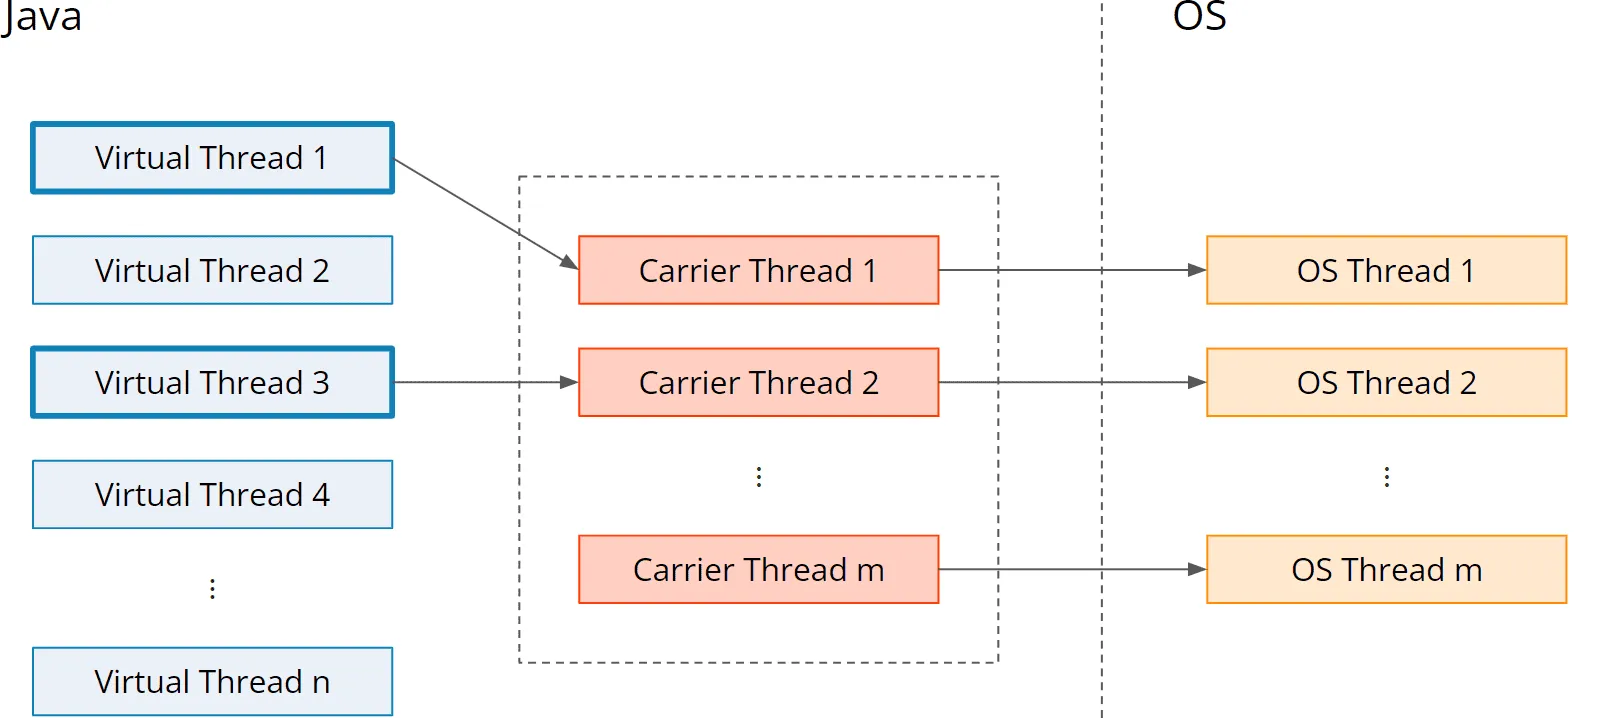
Beim Carrier-Thread-Pool handelt es sich um einen ForkJoinPool – also einen Pool, bei dem jeder Thread seine eigene Queue hat und Tasks von den Queues anderer Threads „stiehlt“, sollte seine eigene Queue leer sein. Seine Größe wird standardmäßig auf Runtime.getRuntime().availableProcessors() gesetzt und kann mit der VM-Option jdk.virtualThreadScheduler.parallelism angepasst werden. Seit Java 24 kannst du den Scheduler außerdem über das jdk.management.VirtualThreadSchedulerMXBean beobachten – etwa wie viele virtuelle Threads gerade gemountet sind oder auf einen Carrier-Thread warten – und seine Parallelität zur Laufzeit ändern.
Im zeitlichen Verlauf könnte beispielsweise die CPU-Aktivität von drei Tasks, die jeweils viermal Code ausführen und dazwischen dreimal verhältnismäßig lange blockieren, wie folgt auf einen einzigen Carrier-Thread gemappt werden:
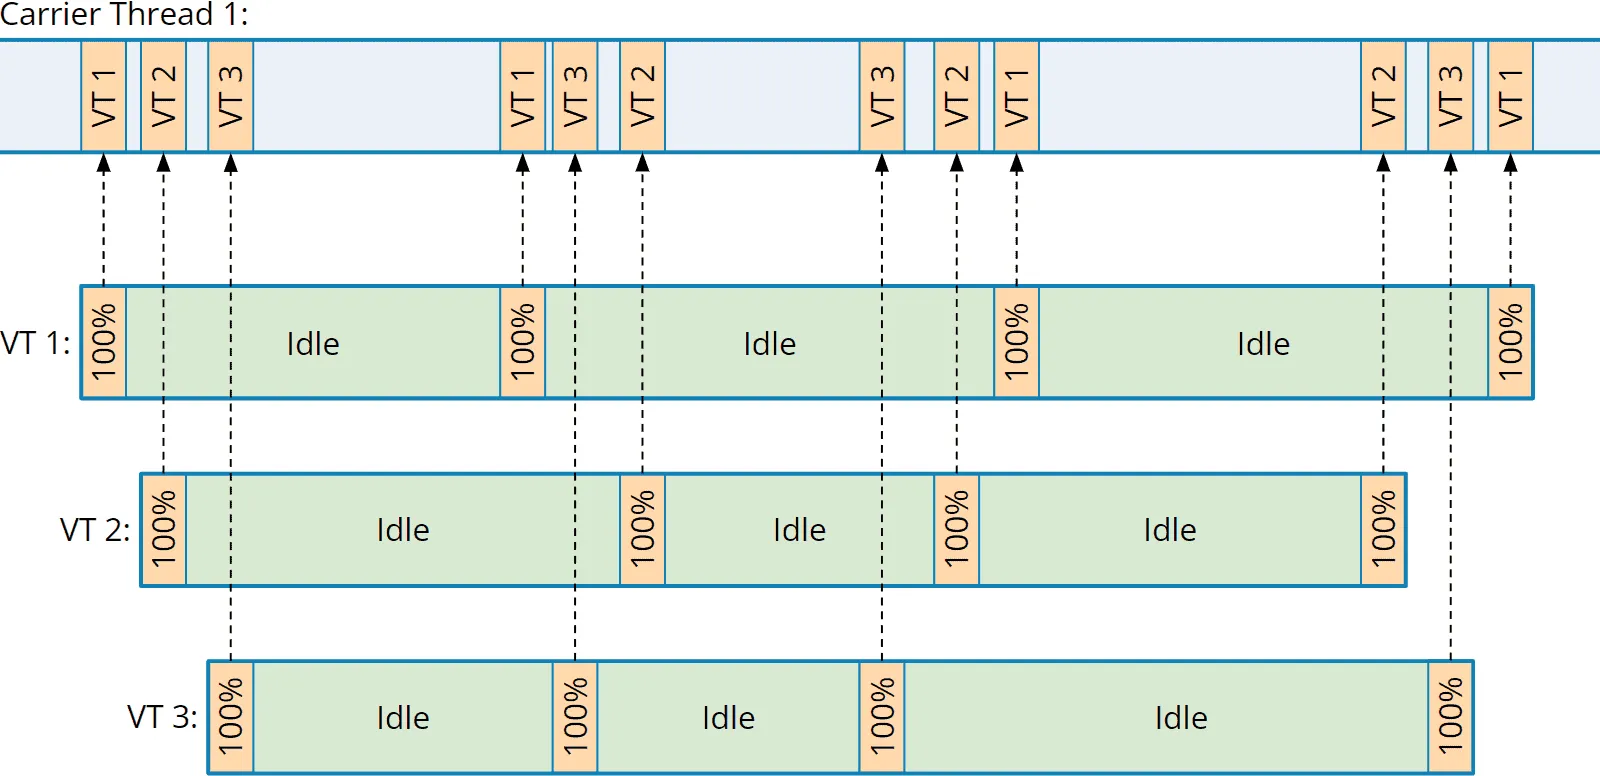
Blockierende Operationen blockieren somit den ausführenden Carrier-Thread nicht, und wir können mit einem kleinen Pool von Carrier-Threads eine Vielzahl von Requests parallel bearbeiten.
Den Beispiel-Use-Case von oben könnte man dann ganz einfach mit sequentiellem, blockierendem Code wie folgt implementieren:
public ProductPageResponse getProduct(String productId) {
  Product product = productService.getProduct(productId)
      .orElseThrow(NotFoundException::new);

  boolean available = warehouseService.isAvailable(productId);

  int shipsInDays =
    available ? 0 : supplierService.getDeliveryTime(product.supplier(), productId);

  return new ProductPageResponse(product, shipsInDays);
}
Dieser Code ist nicht nur einfacher zu schreiben und zu lesen, sondern auch – wie jeder sequentielle Code – mit herkömmlichen Mitteln zu debuggen.
Falls dein Code bereits so aussieht – du also nie auf asynchrone Programmierung umgestellt hast –, dann habe ich gute Nachrichten: Du kannst deinen Code unverändert mit virtuellen Threads weiterverwenden.
Virtuelle Threads – Beispiel
Die Mächtigkeit virtueller Threads können wir auch ohne Backend-Framework demonstrieren. Dazu simulieren wir ein Szenario, das dem oben beschriebenen ähnelt: Wir starten 1.000 Tasks, die jeweils eine Sekunde warten (um den Zugriff auf eine externe API zu simulieren) und dann ein Ergebnis (im Beispiel eine Zufallszahl) zurückliefern.
Als Erstes implementieren wir den Task:
public class Task implements Callable<Integer> {

  private final int number;

  public Task(int number) {
    this.number = number;
  }

  @Override
  public Integer call() {
    System.out.printf("Thread %s - Task %d waiting...%n",
        Thread.currentThread().getName(), number);

    try {
      Thread.sleep(1000);
    } catch (InterruptedException e) {
      System.out.printf("Thread %s - Task %d canceled.%n",
          Thread.currentThread().getName(), number);
      return -1;
    }

    System.out.printf("Thread %s - Task %d finished.%n",
        Thread.currentThread().getName(), number);
    return ThreadLocalRandom.current().nextInt(100);
  }
}
Nun messen wir, wie lange es mit einem Pool von 100 Plattform-Threads (so heißen die herkömmlichen, nicht virtuellen Threads) dauert, alle 1.000 Tasks abzuarbeiten:
try (ExecutorService executor = Executors.newFixedThreadPool(100)) {
  List<Task> tasks = new ArrayList<>();
  for (int i = 0; i < 1_000; i++) {
    tasks.add(new Task(i));
  }

  long time = System.currentTimeMillis();

  List<Future<Integer>> futures = executor.invokeAll(tasks);

  long sum = 0;
  for (Future<Integer> future : futures) {
    sum += future.get();
  }

  time = System.currentTimeMillis() - time;

  System.out.println("sum = " + sum + "; time = " + time + " ms");
}Das Programm läuft etwas über 10 Sekunden. Das war zu erwarten:
1.000 Tasks geteilt durch 100 Threads = 10 Tasks pro Thread
Jeder Plattform-Thread musste 10 Tasks, die jeweils etwa 1 Sekunde dauerten, sequentiell abarbeiten.
Als Nächstes testen wir das Ganze mit virtuellen Threads. Dazu müssen wir lediglich den Ausdruck
Executors.newFixedThreadPool(100)ersetzen durch:
Executors.newVirtualThreadPerTaskExecutor()Dieser Executor verwendet keinen Thread-Pool, sondern legt für jeden Task einen neuen virtuellen Thread an.
Danach benötigt das Programm keine 10 Sekunden mehr, sondern nur noch knapp über eine Sekunde. Schneller geht es auch kaum, da ja jeder Task eine Sekunde wartet.
Beeindruckend: Selbst 10.000 Tasks kann unser kleines Programm in etwas über einer Sekunde abarbeiten.
Erst bei 100.000 Tasks lässt der Durchsatz spürbar nach: Hierfür benötigt mein Laptop etwa vier Sekunden – was aber immer noch rasend schnell ist im Vergleich zum Thread-Pool, der dafür knapp 17 Minuten brauchen würde.
Wie erzeugt man virtuelle Threads?
Eine Möglichkeit zur Erzeugung virtueller Threads haben wir bereits kennengelernt: Ein ExecutorService, den wir mit Executors.newVirtualThreadPerTaskExecutor() erzeugen, erstellt pro Task einen neuen virtuellen Thread.
Mittels Thread.startVirtualThread() oder Thread.ofVirtual().start() können wir virtuelle Threads auch explizit starten:
Thread.startVirtualThread(() -> {
  // code to run in thread
});

Thread.ofVirtual().start(() -> {
  // code to run in thread
});
Bei der zweiten Variante liefert Thread.ofVirtual() einen Thread.Builder.OfVirtual zurück, dessen start()-Methode einen virtuellen Thread startet. Die alternative Methode Thread.ofPlatform() liefert einen Thread.Builder.OfPlatform zurück, über den ein Plattform-Thread gestartet werden kann.
Beide sind Subinterfaces von Thread.Builder. Das ermöglicht uns, flexiblen Code zu schreiben, bei dem erst zur Laufzeit entschieden wird, ob dieser in einem virtuellen oder in einem Plattform-Thread laufen soll:
Thread.Builder threadBuilder = createThreadBuilder();
threadBuilder.start(() -> {
  // code to run in thread
});
Ob Code in einem virtuellen Thread läuft, findest du übrigens mit Thread.currentThread().isVirtual() heraus.
Wie viele virtuelle Threads können gestartet werden?
In diesem GitHub-Repository findest du zahlreiche Demo-Programme, die die Fähigkeiten von virtuellen Threads demonstrieren.
Mit der Klasse HowManyVirtualThreadsDoingSomething kannst du testen, wie viele virtuelle Threads du auf deinem System laufen lassen kannst. Die Anwendung startet mehr und mehr Threads und führt in diesen Threads Thread.sleep()-Operationen in einer Endlosschleife durch, um das Warten auf die Antwort von einer Datenbank oder einer externen API zu simulieren. Versuche, dem Programm mit der VM-Option -Xmx so viel Heap-Speicher wie möglich zur Verfügung zu stellen.
Auf meinem 64-GB-Rechner ließen sich problemlos 20.000.000 virtuelle Threads starten – und mit etwas Geduld auch 30.000.000. Ab dann versuchte der Garbage Collector pausenlos Full GCs durchzuführen – denn der Stack von virtuellen Threads wird auf dem Heap, in sogenannten StackChunk-Objekten „geparkt“, sobald ein virtueller Thread blockiert. Kurz darauf beendete sich die Anwendung mit einem OutOfMemoryError.
Mit der Klasse HowManyPlatformThreadsDoingSomething kannst du außerdem testen, wie viele Plattform-Threads dein System unterstützt. Doch sei gewarnt: Meistens endet das Programm irgendwann mit einem OutOfMemoryError (bei mir zwischen 80.000 und 90.000 Threads) – es kann aber auch deinen Rechner zum Absturz bringen.
Wie verwendet man virtuelle Threads mit Jakarta EE?
In einer Jakarta-EE-Anwendung erzeugst du Threads nicht selbst – das überlässt du dem Container. Seit Jakarta EE 11 (Jakarta Concurrency 3.1) kannst du anfordern, dass ein managed Executor oder eine managed Thread-Factory virtuelle Threads verwendet. Dazu setzt du das Attribut virtual = true, z. B. an einer @ManagedExecutorDefinition:
@ManagedExecutorDefinition(
    name = "java:app/concurrent/virtualExecutor",
    virtual = true)
Dasselbe Attribut gibt es auch bei @ManagedScheduledExecutorDefinition und @ManagedThreadFactoryDefinition. Den so definierten Executor injizierst du anschließend und führst deine Tasks darüber aus. Standardmäßig ist virtual auf false gesetzt – der Container erzeugt also weiterhin Plattform-Threads, solange du virtuelle Threads nicht explizit aktivierst.
Einen einzelnen REST-Endpoint kannst du im Standard von Jakarta EE (Stand Jakarta EE 11) allerdings nicht per Annotation direkt auf einen virtuellen Thread legen. Genau das bietet aber das Quarkus-/SmallRye-Ökosystem mit der Annotation @RunOnVirtualThread – dazu mehr im nächsten Abschnitt.
Wie verwendet man virtuelle Threads mit Quarkus?
Quarkus bietet die Annotation @RunOnVirtualThread an. Sie stammt aus SmallRye Common (io.smallrye.common.annotation.RunOnVirtualThread) und ist – Stand heute – kein Teil der Jakarta-EE-Spezifikation. Mit ihr legst du einen einzelnen Endpoint auf einen virtuellen Thread:
@GET
@Path("/product/{productId}")
@RunOnVirtualThread
public ProductPageResponse getProduct(@PathParam("productId") String productId) {
  Product product = productService.getProduct(productId)
      .orElseThrow(NotFoundException::new);

  boolean available = warehouseService.isAvailable(productId);

  int shipsInDays =
    available ? 0 : supplierService.getDeliveryTime(product.supplier(), productId);

  return new ProductPageResponse(product, shipsInDays);
}
Am Methodenkörper musst du nicht ein einziges Zeichen ändern. Eine erste, experimentelle Fassung von @RunOnVirtualThread gab es in Quarkus schon in Version 2.10 vom Juni 2022; offiziell bewirbt Quarkus die Annotation seit Java 21.
In diesem GitHub-Repository findest du eine Beispiel-Quarkus-Anwendung mit dem oben gezeigten Controller – einmal mit Plattform-Threads, einmal mit virtuellen Threads und außerdem eine asynchrone Variante mit CompletableFuture. Die README erklärt, wie du die Anwendung startest und wie du die drei Controller aufrufst.
Wie verwendet man virtuelle Threads mit Spring?
In Spring würde der Controller wie folgt aussehen:
@GetMapping("/stage1-seq/product/{productId}")
public ProductPageResponse getProduct(@PathVariable("productId") String productId) {
  Product product = productService
      .getProduct(productId)
      .orElseThrow(() -> new ResponseStatusException(NOT_FOUND));

  boolean available = warehouseService.isAvailable(productId);

  int shipsInDays =
      available ? 0 : supplierService.getDeliveryTime(product.supplier(), productId);

  return new ProductPageResponse(product, shipsInDays);
}
Seit Spring Boot 3.2 genügt eine einzige Property in der application.properties, um alle Request-Handler auf virtuellen Threads laufen zu lassen:
spring.threads.virtual.enabled=trueSpring Boot konfiguriert daraufhin u. a. den Webserver (Tomcat/Jetty) und den Task-Executor so, dass jeder Request in einem eigenen virtuellen Thread bearbeitet wird.
Beachte: Damit laufen alle Controller auf virtuellen Threads. Für die meisten Anwendungsfälle ist das in Ordnung – nicht jedoch bei CPU-lastigen Aufgaben, die weiterhin auf Plattform-Threads laufen sollten.
In diesem GitHub-Repository findest du eine Beispiel-Spring-Anwendung mit dem oben gezeigten Controller. Die README erklärt, wie du die Anwendung startest und wie du den Controller von Plattform-Threads auf virtuelle Threads umschaltest.
Vorteile von virtuellen Threads
Virtuelle Threads bieten beeindruckende Vorteile:
Erstens sind sie günstig:
- Sie können deutlich schneller erzeugt werden als Plattform-Threads: Die Erzeugung eines Plattform-Threads dauert etwa 1 ms, die Erzeugung eines virtuellen Threads weniger als 1 µs.
- Sie benötigen weniger Speicher: Ein Plattform-Thread reserviert 1 MB für den Stack und committet, je nach Betriebssystem, 32 bis 64 KB im Voraus. Ein virtueller Thread beginnt mit etwa einem KB. Das gilt jedoch nur für flache Call-Stacks. Ein Call-Stack von der Größe eines halben Megabytes benötigt dieses halbe Megabyte in beiden Thread-Varianten.
- Virtuelle Threads zu blockieren ist billig, da ein blockierter virtueller Thread keinen Betriebssystem-Thread blockiert. Umsonst ist es jedoch nicht, da der Stack des virtuellen Threads auf den Heap kopiert werden muss.
- Context-Switches sind schnell, da sie im User-Space, nicht im Kernel-Space durchgeführt werden und in der JVM zahlreiche Optimierungen vorgenommen wurden, um sie schneller zu machen.
Zweitens können wir virtuelle Threads auf vertraute Weise einsetzen:
- An den
Thread- undExecutorService-APIs wurden nur minimale Änderungen vorgenommen. - Anstatt asynchronen Code mit Callbacks zu schreiben, können wir Code im traditionellen blockierenden Thread-pro-Request-Stil schreiben.
- Wir können virtuelle Threads mit existierenden Tools debuggen, beobachten und profilen.
Was sind virtuelle Threads nicht?
Virtuelle Threads haben natürlich nicht nur Vorteile. Schauen wir uns zunächst einmal an, was virtuelle Threads nicht sind, bzw. was wir mit ihnen nicht machen können oder sollten:
- Virtuelle Threads sind keine schnelleren Threads – sie können nicht mehr CPU-Befehle als ein Plattform-Thread in derselben Zeit ausführen. Sofern ein Task nicht blockiert, läuft er auf einem virtuellen Thread aufgrund des Overheads des Mountens/Unmountens sogar langsamer als auf einem bestehenden Plattform-Thread aus einem
ExecutorService. - Sie sind nicht präemptiv: Während ein virtueller Thread eine CPU-intensive Aufgabe ausführt, wird er nicht vom Carrier-Thread genommen. Wenn du also 20 Carrier-Threads und 20 virtuelle Threads hast, die die CPU beanspruchen, ohne zu blockieren, wird kein anderer virtueller Thread ausgeführt.
- Sie bieten keine höhere Abstraktion als Plattform-Threads. Du musst dir all der subtilen Dinge bewusst sein, die du auch bei der Verwendung regulärer Threads beachten musst. Das heißt, wenn ein virtueller Thread auf gemeinsam genutzte Daten zugreift, musst du dich um Sichtbarkeitsprobleme kümmern, du musst atomare Operationen synchronisieren usw.
Welche Einschränkungen weisen virtuelle Threads auf?
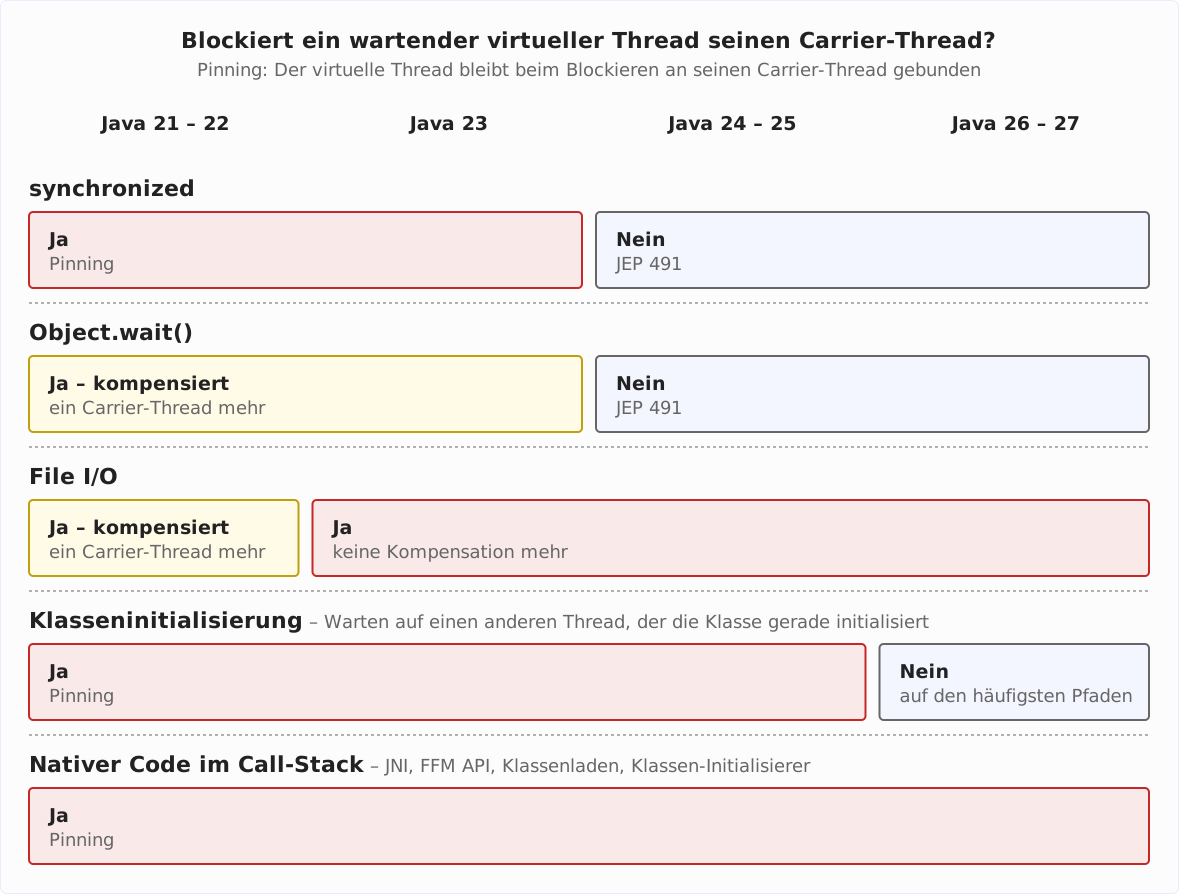
Über folgende Einschränkungen solltest du Bescheid wissen. Das Bild hat sich seit der Einführung in Java 21 allerdings deutlich entspannt – einige frühere Einschränkungen sind inzwischen aufgehoben. Die folgende Matrix zeigt für die fünf Operationen, um die es in diesem Kapitel geht, ob ein wartender virtueller Thread seinen Carrier-Thread blockiert – und ab welcher Java-Version nicht mehr:
1. Nicht unterstützte blockierende Operationen
Die überwiegende Mehrheit der blockierenden Operationen im JDK wurde so umgeschrieben, dass sie virtuelle Threads unterstützt. Eine relevante Ausnahme bleibt (Stand Java 27):
- File I/O
Hier blockiert ein wartender virtueller Thread auch seinen Carrier-Thread. Bis Java 22 erhöhte die JVM in diesem Fall vorübergehend die Anzahl der Carrier-Threads – bis zu einem Maximum von 256, das über die VM-Option jdk.virtualThreadScheduler.maxPoolSize angepasst werden kann. Seit Java 23 tut sie das bei gepuffertem File I/O (FileInputStream, FileOutputStream, RandomAccessFile, FileChannel) nicht mehr, weil Messungen keinen Vorteil zeigten.
Einen zusätzlichen Carrier-Thread gibt es nur noch bei FileDescriptor.sync(), bei force() auf Memory-Mapped Files, bei Direct I/O, bei Schreibzugriffen auf Dateien, die im synchronen Modus (rws, rwd, SYNC, DSYNC) geöffnet wurden, bei DNS-Lookups über InetAddress, bei System.in, System.out und System.err sowie bei der Ein- und Ausgabe von Prozessen.
Für diese Änderung gibt es keinen JEP; sie wird im Bug-Tracker unter JDK-8329593 aufgeführt.
2. Pinning
Pinning bedeutet, dass eine blockierende Operation, die normalerweise einen virtuellen Thread vom Carrier-Thread nehmen würde, dies nicht tut, weil der virtuelle Thread an seinen Carrier-Thread „gepinnt“ wurde – was bedeutet, dass er den Carrier-Thread nicht wechseln darf.
Stand Java 27 tritt Pinning nur noch dann auf, wenn der Call-Stack native Frames enthält – denn was innerhalb von nativem Code passiert, können wir nicht kontrollieren. Das betrifft nicht nur eigene JNI-Aufrufe und das Foreign Function & Memory API, sondern auch zwei Stellen im JDK selbst: das Laden einer Klasse beim Auflösen einer Symbolreferenz und das Blockieren innerhalb eines Klassen-Initialisierers. Innerhalb eines synchronized-Blocks pinnt ein virtueller Thread dagegen nicht mehr.
Ein dritter Fall ist seit Java 26 weitgehend entschärft: das Warten auf eine Klasse, die gerade ein anderer Thread initialisiert. Bis Java 25 blieb der virtuelle Thread dabei an seinen Carrier-Thread gepinnt – im Extremfall bis zum Deadlock, wenn alle Carrier-Threads auf dieselbe Klasse warteten und der initialisierende Thread seinerseits auf einen dieser virtuellen Threads angewiesen war. Seit Java 26 wird der virtuelle Thread auf den häufigsten Pfaden (invokestatic, new, getstatic und putstatic im Interpreter) vom Carrier-Thread genommen.
Für diese Änderung gibt es keinen JEP; sie wird im Bug-Tracker unter JDK-8369238 aufgeführt.
Erkennen von Pinning
Verbleibendes Pinning (z. B. durch nativen Code) erkennst du über das JDK-Flight-Recorder-Event jdk.VirtualThreadPinned, etwa in einer JFR-Aufzeichnung. Das Event wird aufgezeichnet, wenn ein virtueller Thread blockiert, während er gepinnt ist. Seit Java 24 nennt es den Grund des Pinnings (pinnedReason), die blockierende Operation und den Carrier-Thread. In den mitgelieferten JFR-Profilen wird es erst ab einer Dauer von 20 ms aufgezeichnet – kürzeres Pinning siehst du nur, wenn du den Schwellwert (threshold) herabsetzt.
Thread-Dumps mit virtuellen Threads
Die herkömmlichen Thread-Dumps, die per jcmd <pid> Thread.print ausgegeben werden, enthalten übrigens keine virtuellen Threads. Der Grund dafür ist, dass dieses Kommando die VM anhält, um einen Snapshot der laufenden Threads zu erstellen. Dies ist für einige hundert oder sogar einige tausend Threads machbar, aber nicht für Millionen von ihnen.
Daher wurde eine neue Variante von Thread-Dumps implementiert, bei der die VM nicht angehalten wird (jeder Thread wird für sich konsistent erfasst, einen gemeinsamen Zeitpunkt für alle Threads gibt es jedoch nicht), die dafür aber virtuelle Threads mit einschließt. Dieser neue Thread-Dump kann mit einem der beiden folgenden Kommandos erzeugt werden:
jcmd <pid> Thread.dump_to_file -format=plain <file>jcmd <pid> Thread.dump_to_file -format=json <file>
Das erste Kommando generiert einen Thread-Dump ähnlich dem bisherigen, mit Thread-Namen, -IDs und Stack-Traces. Das zweite Kommando generiert eine Datei im JSON-Format, die darüber hinaus Informationen über Thread-Container, Eltern-Container und Eigentümer-Threads enthält.
Lock-Informationen und Deadlocks
Seit Java 25 enthalten diese Thread-Dumps auch Informationen über Locks: den Zustand jedes Threads, den Objekt-Monitor, auf den ein Thread beim Eintritt in einen synchronized-Block wartet, und die Monitore, die er gerade hält. Seit Java 26 kommen die Locks aus java.util.concurrent dazu: Bei einem Thread, der auf ein ReentrantLock wartet, steht jetzt auch, welcher Thread das Lock hält.
Für diese beiden Änderungen gibt es keinen JEP; sie werden im Bug-Tracker unter JDK-8356870 und JDK-8365057 aufgeführt.
Was diese Thread-Dumps weiterhin nicht anzeigen, sind Deadlocks zwischen virtuellen Threads oder zwischen einem virtuellen und einem Plattform-Thread. Eine automatische Deadlock-Erkennung wie bei klassischen Thread-Dumps gibt es hier nicht – Deadlocks musst du anhand der Lock-Informationen selbst aufspüren.
Wann sollten virtuelle Threads eingesetzt werden?
Virtuelle Threads solltest du bei vielen nebenläufig abzuarbeitenden Tasks einsetzen, die in erster Linie blockierende Operationen enthalten.
Dies gilt für die meisten Serveranwendungen. Wenn deine Serveranwendung allerdings CPU-intensive Aufgaben bearbeitet, solltest du dafür Plattform-Threads verwenden.
Was gilt es sonst noch zu beachten?
Hier ein paar Tipps zum Einsatz von und zum Umstieg auf virtuelle Threads:
- Auch wenn viele Artikel über virtuelle Threads uns das glauben machen wollen: Sie verwenden nicht grundsätzlich weniger Speicher als ein Plattform-Thread. Dies ist nur dann der Fall, wenn der Call-Stack nicht sehr tief ist. Bei tiefen Call-Stacks verbrauchen beide Arten von Threads die gleiche Menge an Speicher.
- Virtuelle Threads müssen nicht gepoolt werden. Ein Pool wird verwendet, um teure Ressourcen zu teilen. Virtuelle Threads sind hingegen so billig, dass es besser ist, einen zu erstellen, wenn man ihn braucht, und ihn terminieren zu lassen, wenn man ihn nicht mehr braucht.
- Wenn du den Zugriff auf eine Ressource begrenzen musst, z. B. wie viele Threads gleichzeitig auf eine Datenbank oder eine API zugreifen dürfen, verwende statt eines Thread-Pools eine
Semaphore. - Ein Großteil des Codes für virtuelle Threads ist in Java geschrieben. Dementsprechend musst du die JVM aufwärmen, bevor du Performance-Tests durchführst, damit der gesamte Bytecode kompiliert und optimiert ist, bevor die Messung beginnt.
Fazit
Virtuelle Threads halten, was sie versprechen: Sie ermöglichen es uns, lesbaren und wartbaren, sequentiellen Code zu schreiben, der Betriebssystem-Threads nicht blockiert, wenn auf Locks, blockierende Datenstrukturen oder Antworten vom Dateisystem oder externen Services gewartet werden muss.
Virtuelle Threads können in der Größenordnung von mehreren Millionen erzeugt werden.
Die gängigen Backend-Frameworks wie Spring und Quarkus können bereits mit virtuellen Threads umgehen. Dennoch solltest du Anwendungen intensiv testen, wenn du sie auf virtuelle Threads umstellst. Beachte, dass du auf ihnen keine CPU-intensiven Rechenaufgaben ausführst, dass sie nicht durch das Framework gepoolt werden und dass in ihnen keine ThreadLocals gespeichert werden (s. auch Scoped Values).
Ich hoffe, du bist ebenso begeistert wie ich und kannst es nicht abwarten, virtuelle Threads in deinen Projekten einzusetzen!
Wenn dir der Artikel weitergeholfen hat, würde ich mich sehr über eine positive Bewertung auf meinem ProvenExpert-Profil freuen. Dein Feedback hilft mir, meine Inhalte weiter zu verbessern und motiviert mich, neue informative Artikel zu schreiben.