Bei Heapsort denken die meisten Java-Entwickler:innen zunächst an den Java-Heap. Dass Heapsort damit nichts zu tun hat – und wie Heapsort genau funktioniert – zeigt dir dieser Artikel.
Im Detail erfährst du:
- Was ist ein Heap?
- Wie funktioniert der Heapsort-Algorithmus?
- Wie sieht der Quellcode von Heapsort aus?
- Wie bestimmt man die Zeitkomplexität von Heapsort?
- Was ist Bottom-Up-Heapsort und welche Vorteile hat es?
- Wie schlägt sich Heapsort im Vergleich zu Quicksort und Mergesort?
Was ist ein Heap?
Ein „Heap“ (deutsch: „Haufen“ oder „Halde“) bezeichnet einen vollständigen Binärbaum, in dem jeder Knoten entweder größer oder gleich seinen Kindern ist („Max Heap“) – oder kleiner oder gleich seinen Kindern („Min Heap“).
Vollständig heißt: Alle Ebenen des Baums sind voll besetzt, nur in der untersten dürfen rechts Knoten fehlen.
Hier ist ein einfaches Beispiel für einen „Max Heap“:
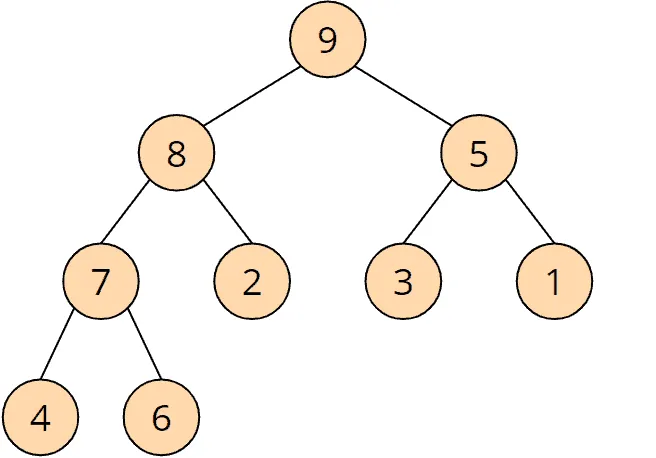
Die 9 ist größer als die 8 und die 5; die 8 ist größer als die 7 und die 2; usw.
Ein Heap wird auf ein Array projiziert, indem dessen Elemente von oben links zeilenweise nach rechts unten in das Array übertragen werden:
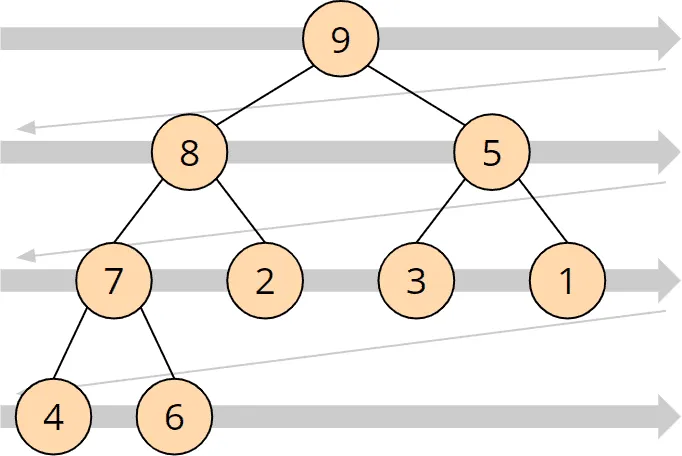
Der oben gezeigte Heap sieht als Array also so aus:

Weil der Baum vollständig ist, braucht das Array keine Verweise zwischen den Knoten. Die Position eines Elements legt fest, wo seine Kinder und sein Elternknoten stehen.
Die Kinder des Elements an Index i liegen an den Indizes 2i + 1 und 2i + 2, sein Elternknoten an Index (i − 1) / 2 (abgerundet). Das folgende Bild zeigt das für die 8 an Index 1:
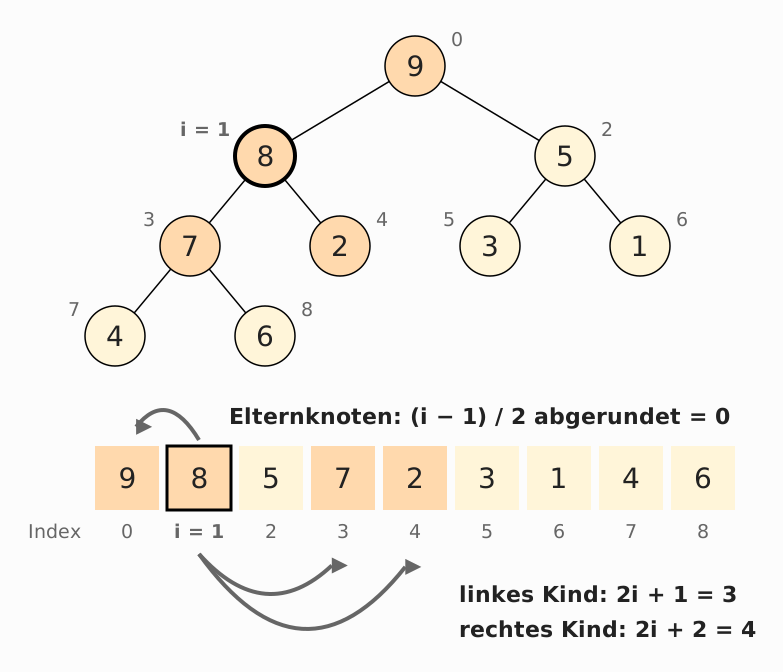
Der letzte Elternknoten ist der Elternknoten des letzten Elements. Er steht an Index n / 2 − 1 (mit abgerundetem n / 2) – bei den neun Elementen des Beispiels an Index 3, das ist die 7.
Bei einem „Max Heap“ ist das größte Element immer ganz oben – in der Array-Form ist es folglich ganz links. Wie man diese Eigenschaft zum Sortieren verwenden kann, erfährst du im folgenden Abschnitt.
Heapsort-Algorithmus
Der Heapsort-Algorithmus besteht aus zwei Phasen: In der ersten Phase wird das zu sortierende Array in einen Max Heap umgewandelt. Und in der zweiten Phase wird jeweils das größte Element (also das an der Baumwurzel) entnommen und aus den restlichen Elementen erneut ein Max Heap hergestellt.
Die folgenden Abschnitte erklären die zwei Phasen im Detail anhand eines Beispiels:
Phase 1: Heap erstellen
Das zu sortierende Array muss zunächst in einen Heap umgewandelt werden. Dazu wird keine neue Datenstruktur angelegt, sondern die Zahlen werden innerhalb des Arrays so umsortiert, dass die oben beschriebene Heap-Struktur entsteht.
Wie dies geschieht, erkläre ich in folgendem Beispiel anhand der aus den vorangegangenen Teilen der Artikelserie bekannten Zahlenfolge [3, 7, 1, 8, 2, 5, 9, 4, 6].
Diese „projizieren“ wir wie oben beschrieben auf einen Binärbaum. Dabei ist der Binärbaum keine separate Datenstruktur, sondern lediglich ein Gedankenkonstrukt – im Speicher liegen die Elemente ausschließlich in dem Array.
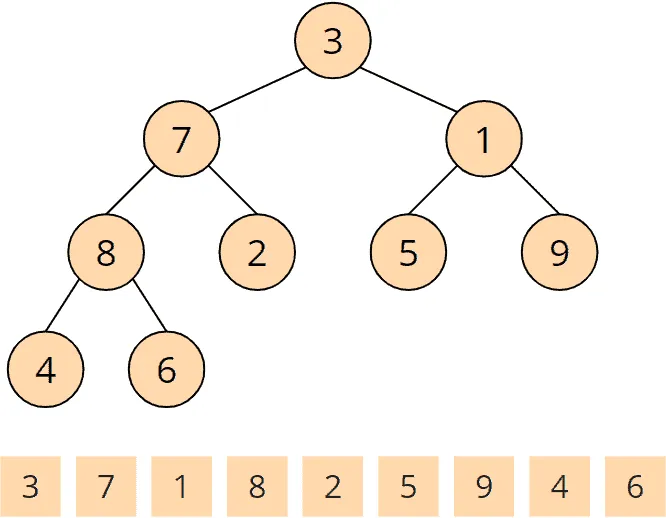
Dieser Baum entspricht noch keinem Max Heap. Dessen Definition lautet ja, dass Eltern immer größer oder gleich ihren Kindern sind.
Um einen Max Heap herzustellen, besuchen wir nun alle Elternknoten – rückwärts vom letzten bis zum ersten – und sorgen dafür, dass die Heap-Bedingung für den jeweiligen Knoten und die darunter erfüllt ist. Dies machen wir mit der sogenannten heapify()-Methode.
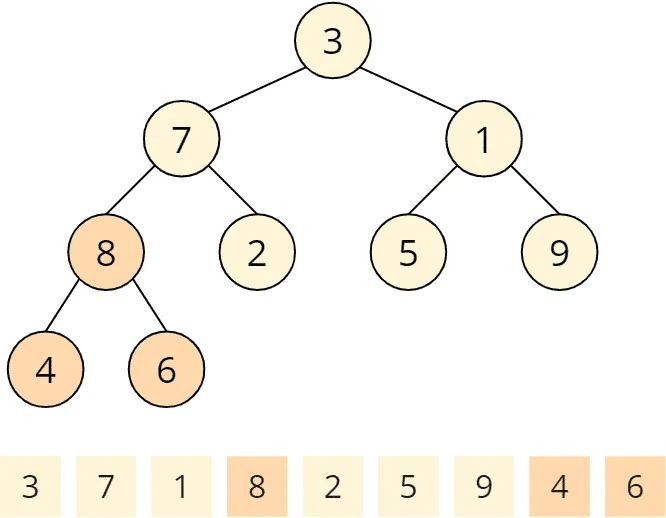
Aufruf Nr. 1 der heapify-Methode
Die heapify()-Methode wird zuerst für den letzten Elternknoten aufgerufen. Elternknoten sind 3, 7, 1 und 8. Der letzte Elternknoten ist die 8. Die heapify()-Methode prüft, ob die Kinder kleiner sind als der Elternknoten. 4 und 6 sind kleiner als 8. An diesem Elternknoten ist die Heap-Bedingung also erfüllt, und die heapify()-Methode ist beendet.
Aufruf Nr. 2 der heapify-Methode
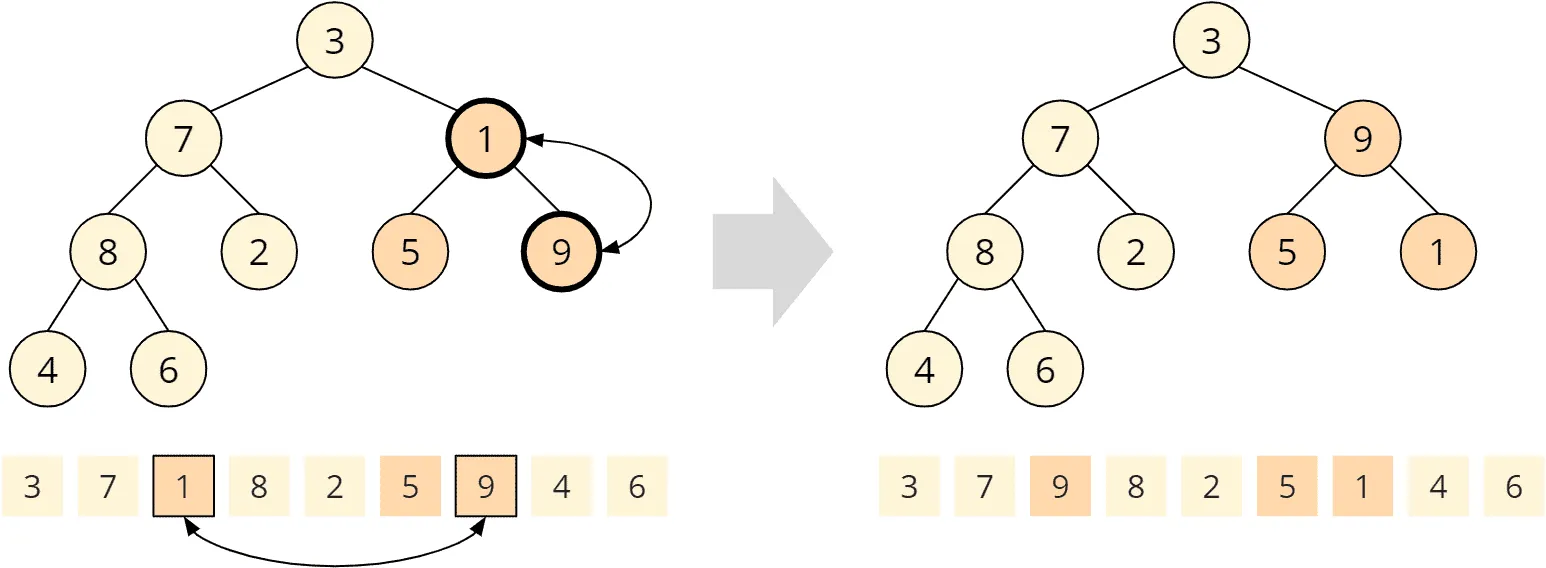
Als Zweites wird heapify() für den vorletzten Elternknoten aufgerufen: die 1. Die Kinder 5 und 9 sind beide größer als die 1, die Heap-Bedingung ist also verletzt. Um die Heap-Bedingung wiederherzustellen, tauschen wir nun das größere Kind mit dem Elternknoten, also die 9 mit der 1. Die heapify()-Methode ist damit wieder beendet.
Aufruf Nr. 3 der heapify-Methode
Nun wird heapify() auf der 7 aufgerufen. Kindknoten sind 8 und 2, nur die 8 ist größer als der Elternknoten. Wir tauschen also die 7 mit der 8:
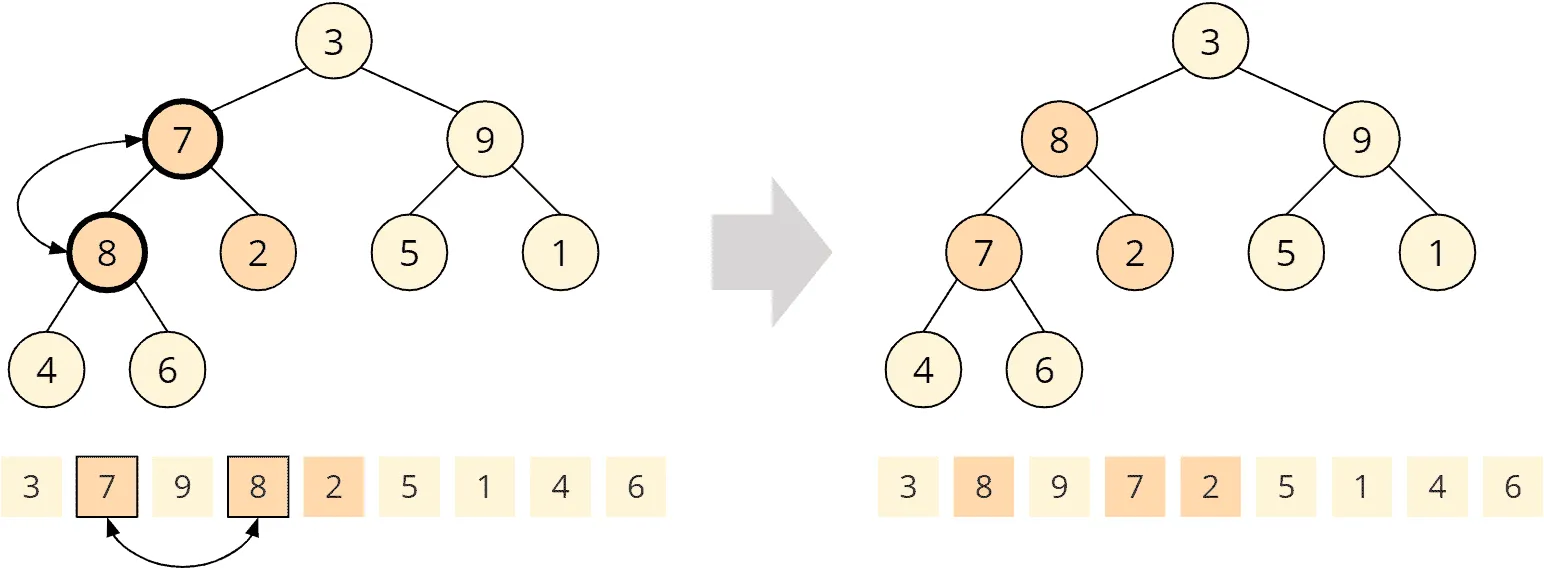
Da der Kindknoten, den wir eben getauscht haben, selbst zwei Kinder hat, muss die heapify()-Methode nun prüfen, ob die Heap-Bedingung für diesen Kindknoten noch erfüllt ist. In diesem Fall ist die 7 größer als 4 und 6, die Heap-Bedingung ist also erfüllt; die heapify()-Methode ist damit beendet.
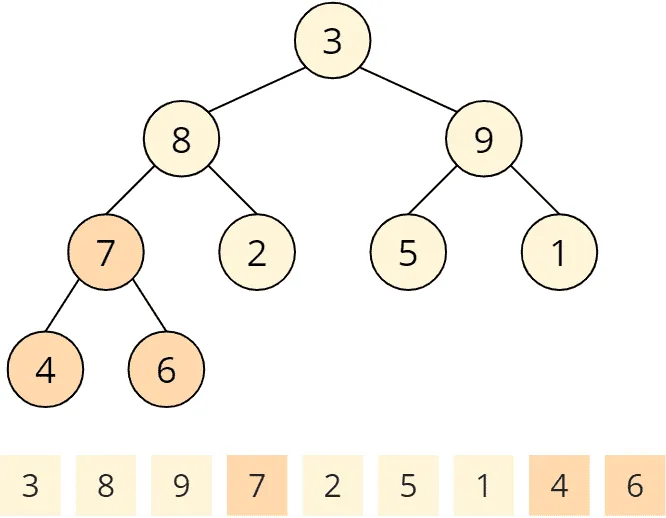
Aufruf Nr. 4 der heapify-Methode
Jetzt sind wir bereits am Wurzelknoten mit dem Element 3 angekommen. Beide Kindknoten, 8 und 9, sind größer, wobei die 9 das größere Kind ist und daher mit dem Elternknoten vertauscht wird:
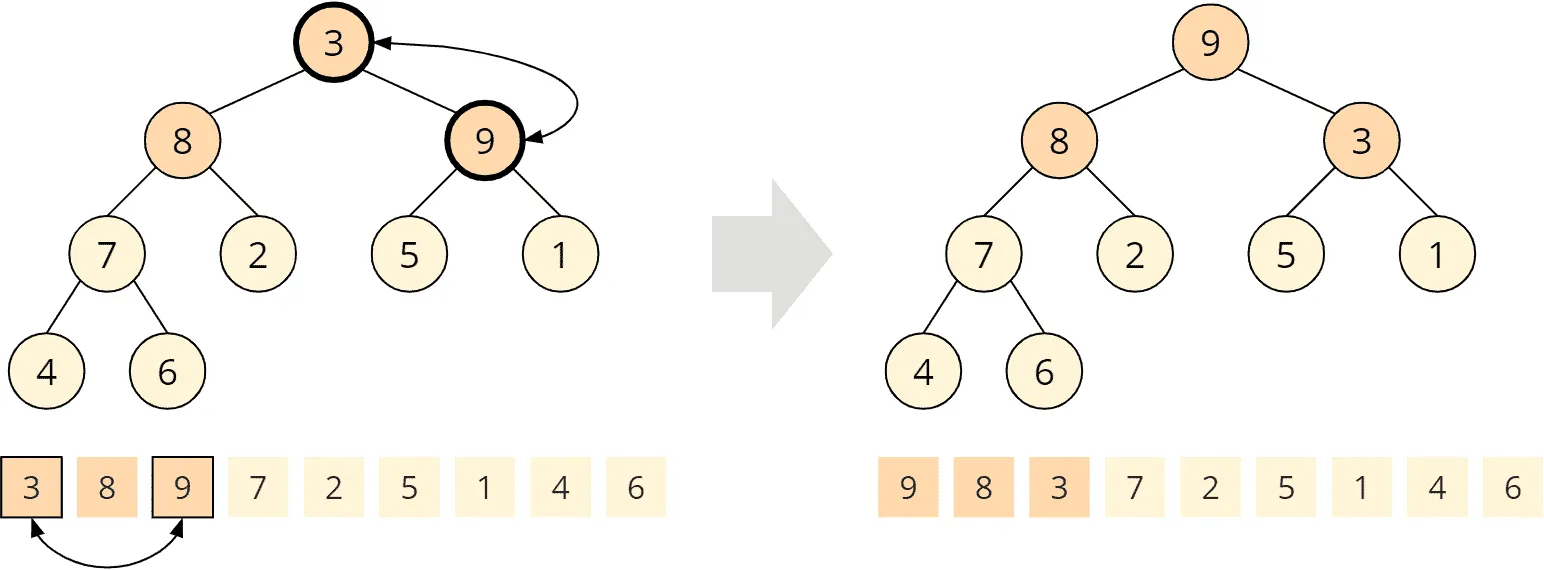
Wiederum hat der getauschte Kindknoten selbst Kinder, sodass wir die Heap-Bedingung an diesem Kindknoten überprüfen müssen. Die 5 ist größer als die 3, d. h. die Heap-Bedingung ist nicht erfüllt und muss durch Tauschen der 5 und der 3 wiederhergestellt werden:
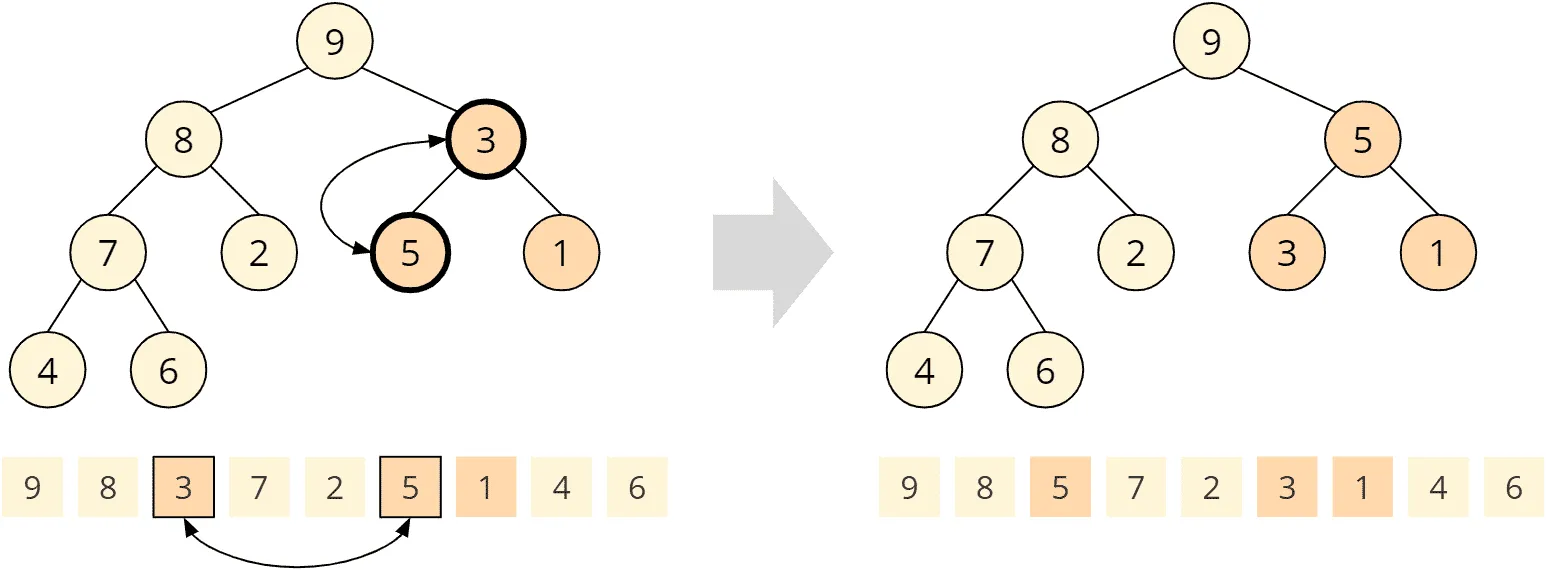
Damit ist auch der vierte und letzte Aufruf der heapify()-Methode beendet. Ein Max Heap ist entstanden:
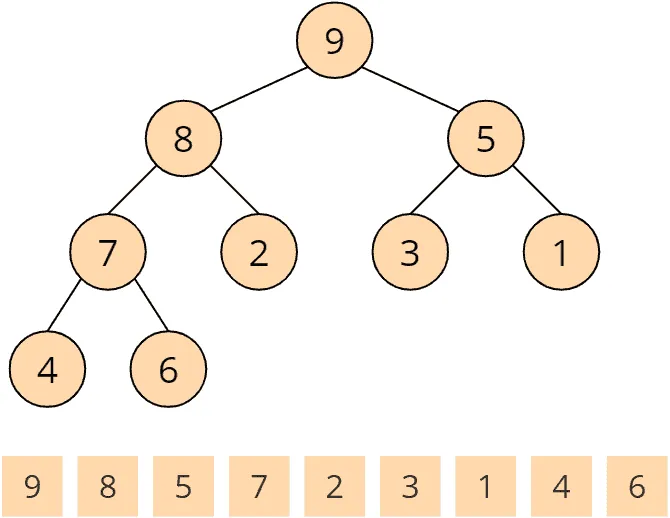
Damit gehen wir über in Phase zwei des Heapsort-Algorithmus.
Phase 2: Sortieren des Arrays
In Phase 2 machen wir uns die Tatsache zunutze, dass das größte Element des Max Heaps immer an dessen Wurzel (bzw. im Array ganz links) steht.
Phase 2, Schritt 1: Wurzel und letztes Element tauschen
Das Wurzelelement (die 9) tauschen wir nun mit dem letzten Element (der 6), sodass die 9 an ihrer finalen Position am Ende des Arrays steht (im Array blau markiert). Außerdem entfernen wir dieses Element gedanklich aus dem Baum (im Baum grau dargestellt):
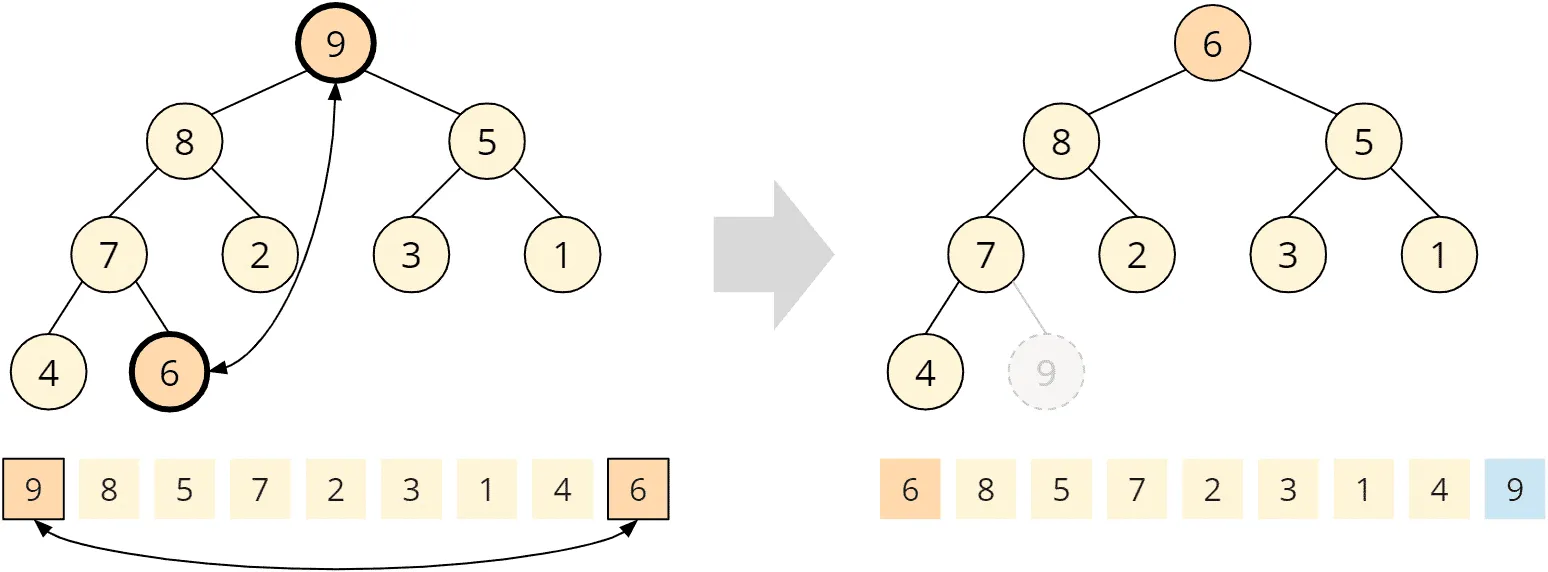
Nachdem wir die 6 an die Wurzel des Baumes gesetzt haben, ist dieser kein Max Heap mehr. Im nächsten Schritt „reparieren“ wir den Heap.
Phase 2, Schritt 2: Heap-Bedingung wiederherstellen
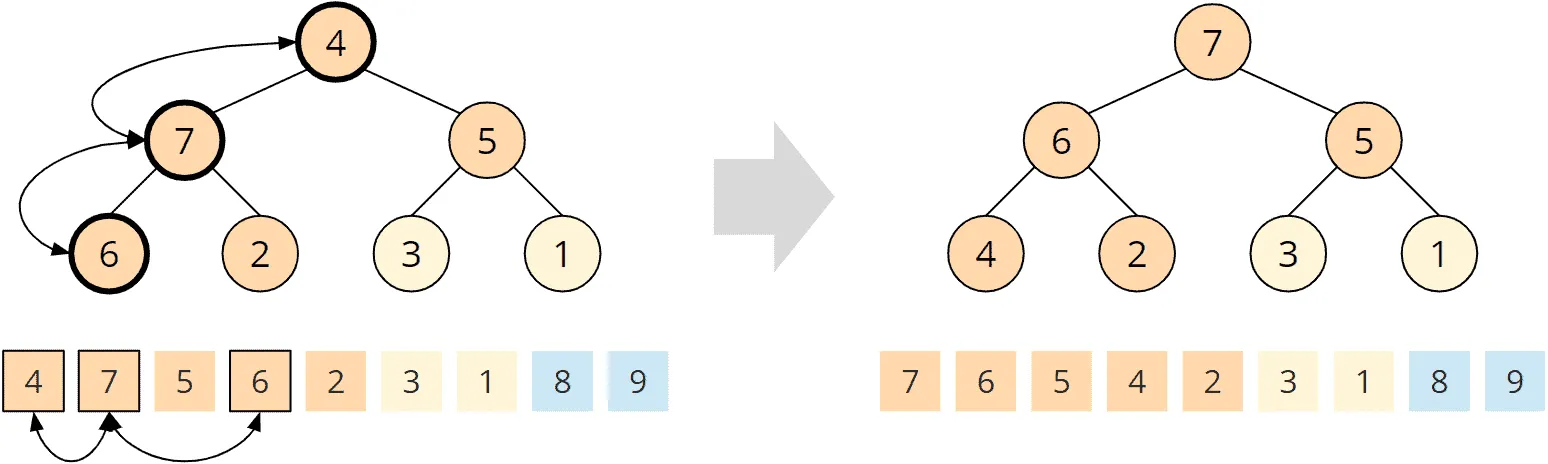
Um die Heap-Bedingung wiederherzustellen, rufen wir die aus Phase 1 bekannte heapify()-Methode auf dem Wurzelknoten auf. Wir vergleichen also die 6 mit ihren Kindern, 8 und 5. Die 8 ist größer, wir tauschen sie daher mit der 6:
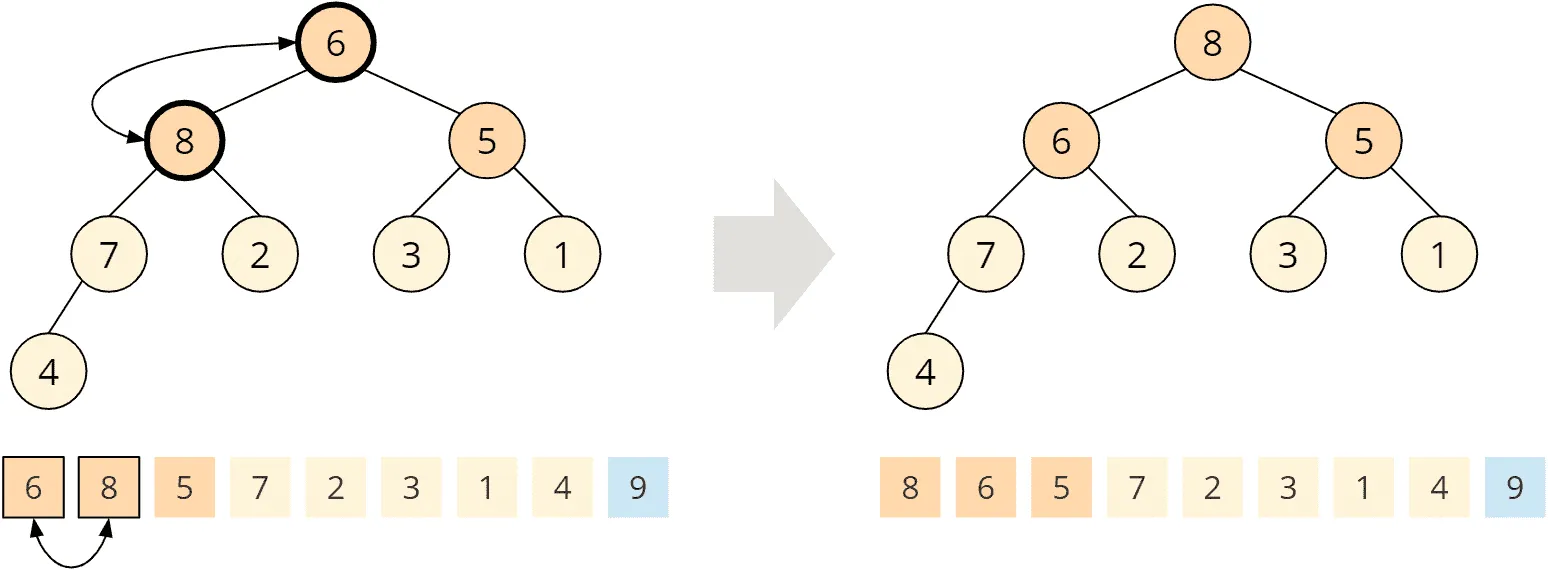
Der getauschte Kindknoten hat wiederum zwei Kinder, die 7 und die 2. Die 7 ist größer als die 6, daher tauschen wir auch diese zwei Elemente:
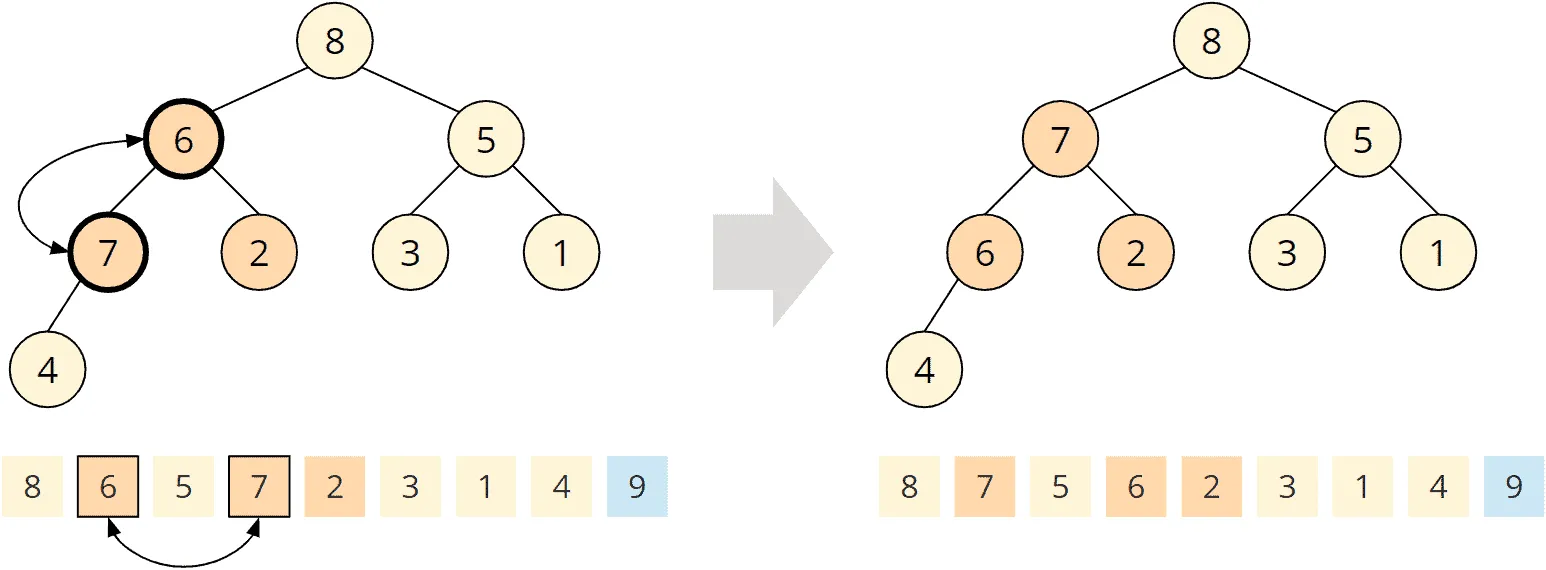
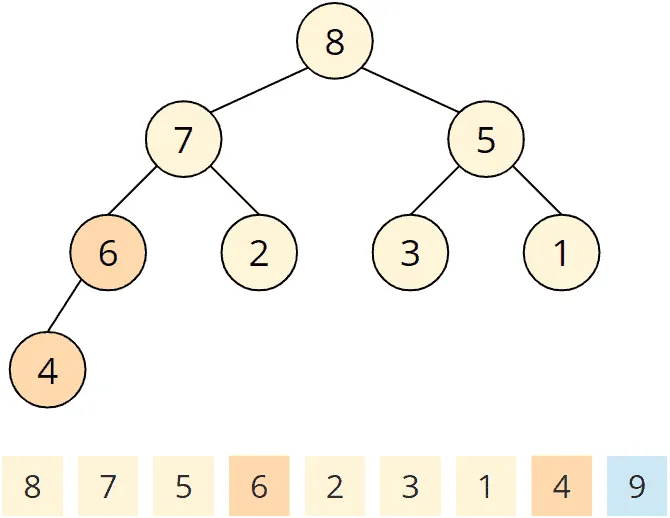
Der getauschte Kindknoten hat auch noch ein Kind, die 4. Die 6 ist größer als die 4, die Heap-Bedingung ist an diesem Knoten also erfüllt, sodass die heapify()-Methode beendet ist und wir wieder einen Max Heap haben:
Wiederholung der Schritte
Damit steht nun wieder die größte Zahl des verbleibenden Arrays, die 8, an erster Stelle. Diese wird wieder mit dem letzten Element des Baums vertauscht. Da wir den Baum um ein Element gekürzt haben, liegt das letzte Element des Baumes auf dem vorletzten Feld des Arrays:
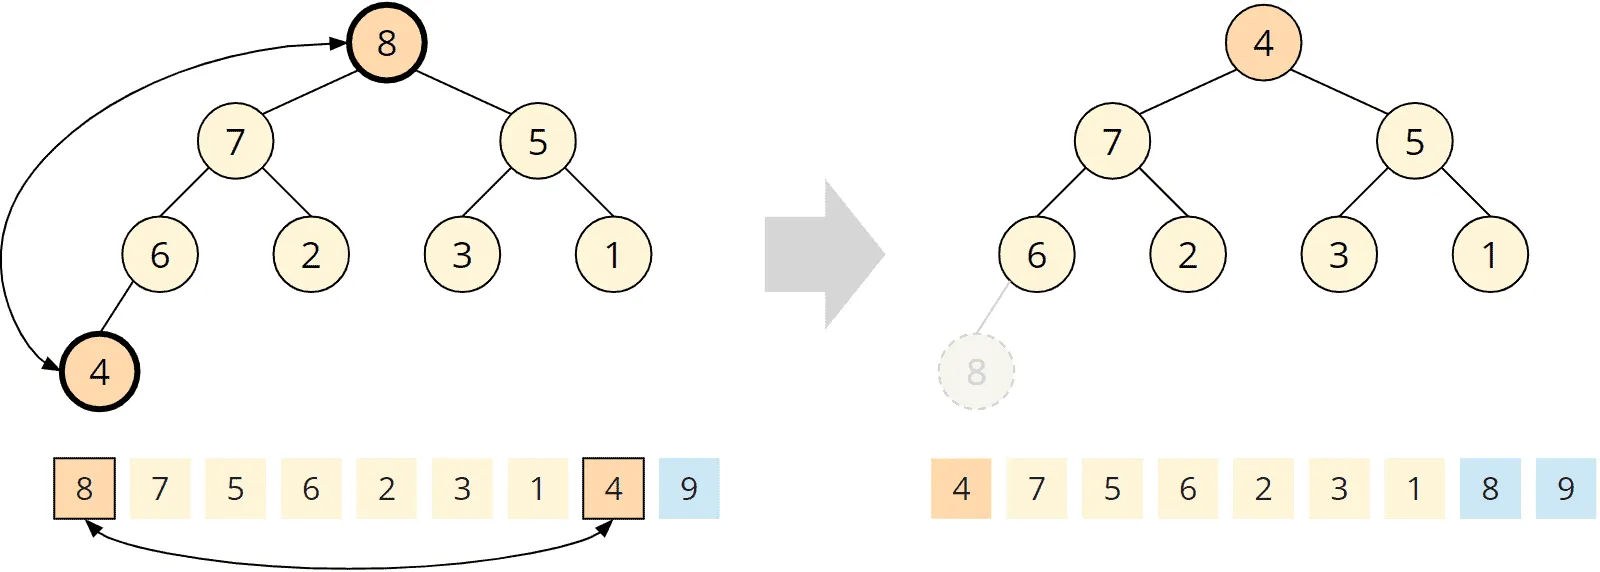
Damit sind die letzten zwei Felder des Arrays sortiert.
An der Wurzel ist nun wieder die Heap-Bedingung verletzt, und wir reparieren den Baum, indem wir heapify() auf dem Wurzelelement aufrufen (das folgende Bild zeigt alle heapify-Schritte auf einmal).
Wir wiederholen den Prozess so lange, bis der Baum nur noch ein Element enthält:
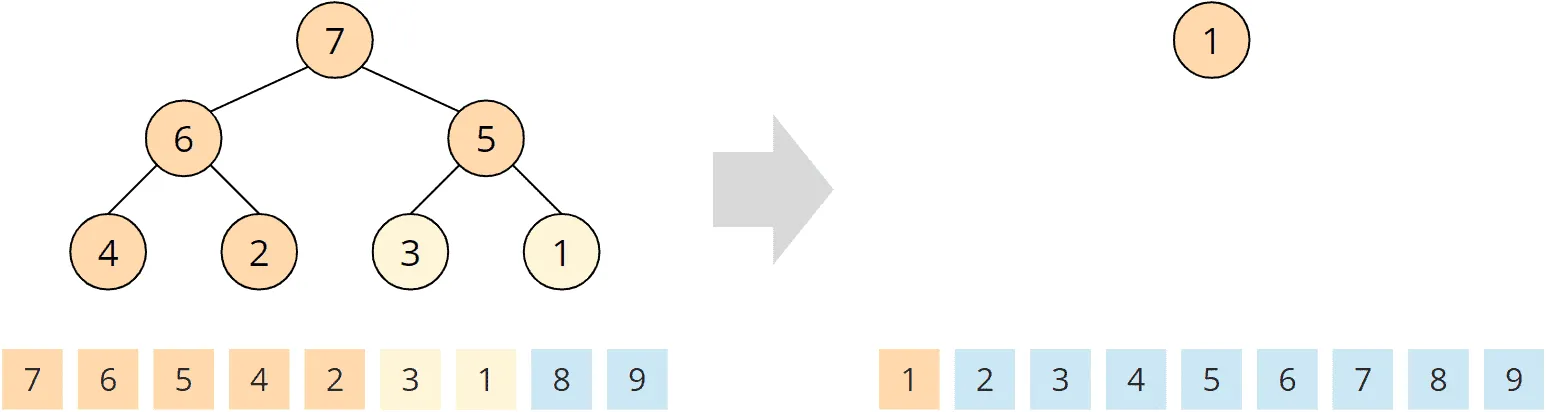
Dieses ist das kleinste und verbleibt am Anfang des Arrays. Der Algorithmus ist beendet, das Array ist sortiert:

Heapsort Java Code Beispiel
Im Folgenden findest du den Quellcode von Heapsort.
Die sort()-Methode ruft zunächst buildHeap() auf, um den Heap initial aufzubauen.
In der darauffolgenden Schleife iteriert die Variable swapToPos rückwärts vom Ende des Arrays bis zum zweiten Feld. Im Schleifenkörper wird das erste Element mit demjenigen an der Position swapToPos vertauscht und danach die heapify()-Methode auf dem Sub-Array bis zur (ausschließlichen) Position swapToPos aufgerufen:
public class Heapsort {

  public void sort(int[] elements) {
    buildHeap(elements);

    for (int swapToPos = elements.length - 1; swapToPos > 0; swapToPos--) {
      // Move root to end
      ArrayUtils.swap(elements, 0, swapToPos);

      // Fix remaining heap
      heapify(elements, swapToPos, 0);
    }
  }

  [...]
}
Die buildHeap()-Methode ruft für jeden Elternknoten – beginnend beim letzten – heapify() auf und übergibt dieser Methode das Array, die Länge des Sub-Arrays, das den Heap darstellt, und die Position des Elternknotens, an dem heapify() starten soll:
void buildHeap(int[] elements) {
  // "Find" the last parent node
  int lastParentNode = elements.length / 2 - 1;

  // Now heapify it from here on backwards
  for (int i = lastParentNode; i >= 0; i--) {
    heapify(elements, elements.length, i);
  }
}
Die heapify()-Methode prüft, ob ein Kindknoten größer ist als der Elternknoten. Wenn das der Fall ist, wird das Elternelement mit dem größeren Kindelement vertauscht, und der Prozess wird auf dem Kindknoten wiederholt.
void heapify(int[] heap, int length, int parentPos) {
  while (true) {
    int leftChildPos = parentPos * 2 + 1;
    int rightChildPos = parentPos * 2 + 2;

    // Find the largest element
    int largestPos = parentPos;
    if (leftChildPos < length && heap[leftChildPos] > heap[largestPos]) {
      largestPos = leftChildPos;
    }
    if (rightChildPos < length && heap[rightChildPos] > heap[largestPos]) {
      largestPos = rightChildPos;
    }

    // largestPos is now either parentPos, leftChildPos or rightChildPos.
    // If it's the parent, we're done
    if (largestPos == parentPos) {
      break;
    }

    // If it's not the parent, then switch!
    ArrayUtils.swap(heap, parentPos, largestPos);

    // ... and fix again starting at the child we moved the parent to
    parentPos = largestPos;
  }
}
Die Schleife in heapify() ließe sich auch rekursiv schreiben – dann bräuchte der Aufrufstapel aber O(log n) zusätzlichen Speicher.
Du findest den Quellcode in der Klasse Heapsort im GitHub-Repository. Diese unterscheidet sich leicht von der hier abgedruckten Klasse: Die Klasse im Repository implementiert das Interface SortAlgorithm, um innerhalb des Testframeworks austauschbar zu sein.
Heapsort Zeitkomplexität
Klicke auf den folgenden Link für eine Einführung in „Zeitkomplexität“ und „O-Notation“ (mit Beispielen und Diagrammen).
Zeitkomplexität der heapify()-Methode
Fangen wir mit der heapify()-Methode an, da diese auch für den initialen Aufbau des Heaps benötigt wird.
In der heapify()-Methode hangeln wir uns einmal von oben nach unten durch den Baum. Die Höhe eines Heaps – also eines vollständigen Binärbaums – der Größe n beträgt log2 n (abgerundet, die Wurzel wird nicht mitgezählt), d. h. bei einer Verdopplung der Anzahl der Elemente wird der Baum lediglich eine Ebene tiefer:
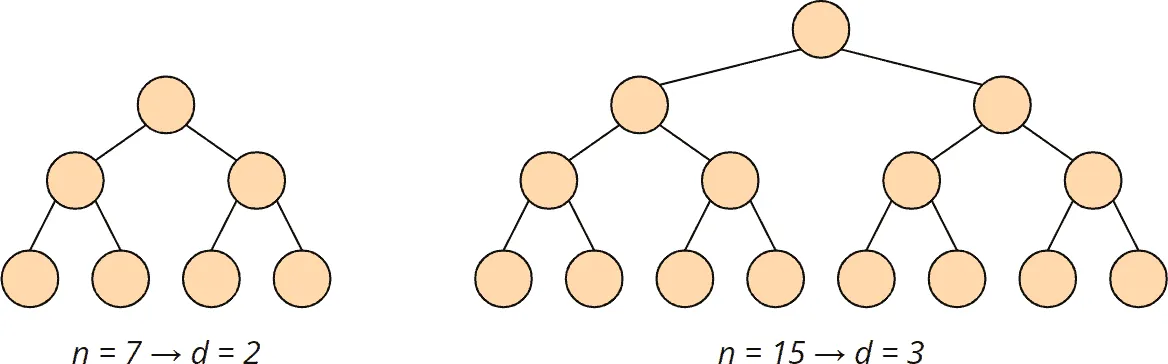
Die Komplexität für die heapify()-Methode ist entsprechend O(log n).
Zeitkomplexität der buildHeap()-Methode
Für den erstmaligen Aufbau des Heaps wird für jeden Elternknoten – rückwärts, beginnend beim letzten Knoten und endend an der Baumwurzel – die heapify()-Methode aufgerufen.
Ein Heap der Größe n hat n/2 (abgerundet) Elternknoten:
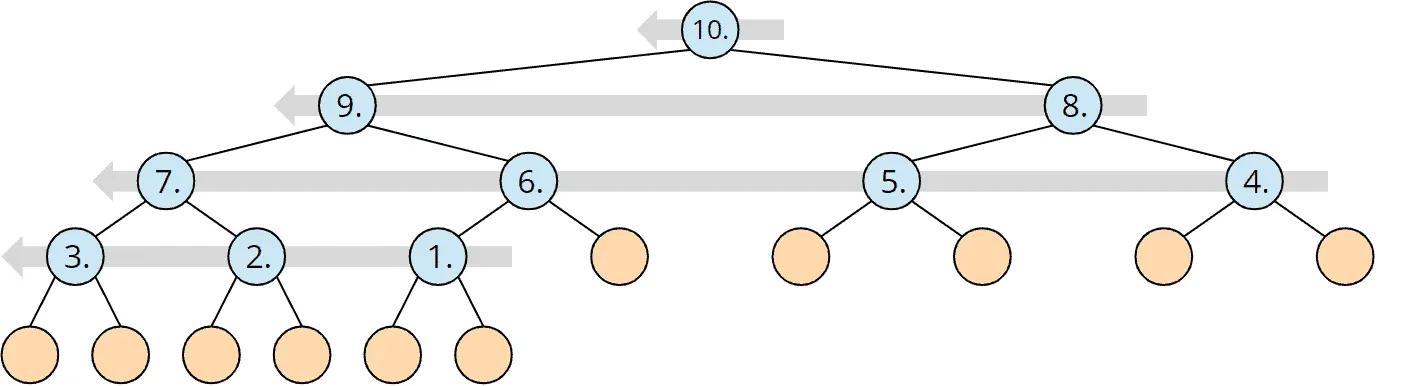
Da die Komplexität der heapify()-Methode, wie oben gezeigt, O(log n) ist, ist die Komplexität für die buildHeap()-Methode also maximal* O(n log n).
* Im übernächsten Abschnitt werde ich zeigen, dass die Zeitkomplexität der buildHeap()-Methode sogar O(n) ist. Da dies an der Gesamt-Zeitkomplexität nichts ändert, ist es nicht zwingend erforderlich, diese detailliertere Analyse durchzuführen.
Gesamt-Zeitkomplexität von Heapsort
In Phase 2 wird die heapify()-Methode (n − 1)-mal aufgerufen. Die Gesamtkomplexität für das Reparieren des Heaps ist also ebenfalls O(n log n).
Beide Teilalgorithmen haben damit die gleiche Zeitkomplexität. Es gilt somit:
Die Zeitkomplexität von Heapsort beträgt: O(n log n)
Das gilt für den Average und den Worst Case. Schneller geht es, wenn alle Elemente gleich sind: Dann findet heapify() nie ein größeres Kind und bricht jedes Mal nach den Vergleichen mit den beiden Kindern ab, ohne zu tauschen – Heapsort sortiert in diesem Fall in O(n).
Zeitkomplexität für den Aufbau des Heaps – genauer analysiert
Dieser Abschnitt ist sehr mathematisch und für die Herleitung der Zeitkomplexität des Gesamtalgorithmus (die wir ja bereits abgeschlossen haben) nicht zwingend erforderlich. Du kannst diesen Abschnitt daher auch überspringen.
Wir haben oben festgestellt, dass die buildHeap()-Methode für jeden Elternknoten heapify() aufruft. Was wir bisher nicht berücksichtigt haben, ist, dass die Tiefe der Teilbäume, auf denen heapify() aufgerufen wird, unterschiedlich ist. Folgende Grafik soll das verdeutlichen (d steht für die Tiefe der Teilbäume):
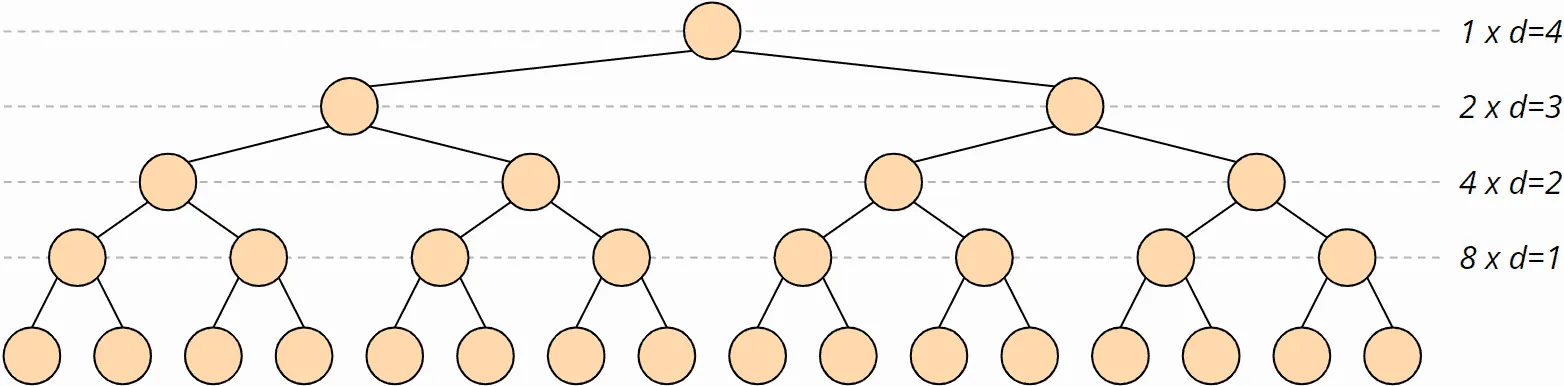
Die heapify()-Methode wird also maximal für n/4 Bäume der Tiefe 1 aufgerufen, für n/8 Bäume der Tiefe 2, für n/16 Bäume der Tiefe 3, usw.
Die maximale Anzahl der Tauschoperationen in der heapify()-Methode entspricht der Tiefe des Teilbaums, auf dem diese aufgerufen wird.
Die maximale Anzahl der Tauschoperationen Smax (S steht für „Swap“) für den Aufbau des Heaps beträgt somit:
Smax = n/4 · 1 + n/8 · 2 + n/16 · 3 + n/32 · 4 + ...
Wenn wir beide Seiten des Terms mit 2 multiplizieren, erhalten wir:
2 · Smax = n/2 · 1 + n/4 · 2 + n/8 · 3 + n/16 · 4 + ...
Legen wir einmal beide Terme übereinander:
| 2 · Smax = | n/2 · 1 + | n/4 · 2 + n/8 · 3 + n/16 · 4 + ... |
| Smax = | n/4 · 1 + n/8 · 2 + n/16 · 3 + n/32 · 4 + ... |
Beide Terme enthalten n/4, n/8, n/16 usw. mit jeweils einem um die Konstante 1 unterschiedlichen Faktor. Wenn wir die Terme subtrahieren, erhalten wir:
2 · Smax − Smax = n/2 · 1 + n/4 · (2 − 1) + n/8 · (3 − 2) + n/16 · (4 − 3) + ...
Das lässt sich vereinfachen zu:
Smax = n/2 + n/4 + n/8 + n/16 + ...
Bzw.:
Smax = n · (1/2 + 1/4 + 1/8 + 1/16 + ...)
Der Term 1/2 + 1/4 + 1/8 + 1/16 + ... nähert sich an 1 an, wie folgende Darstellung zeigt:
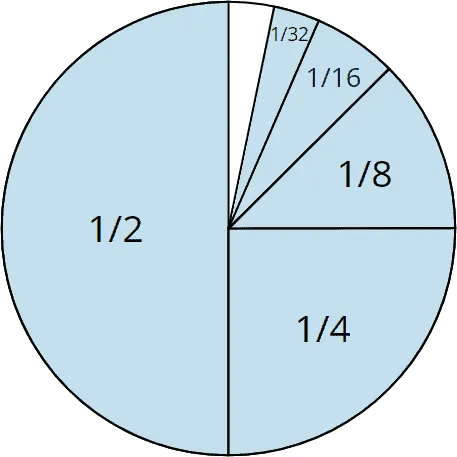
Somit lässt sich die Formel abschließend vereinfachen zu:
Smax ≤ n
Damit haben wir gezeigt, dass der Aufwand für den Aufbau des Heaps linear ist, die Zeitkomplexität also O(n) beträgt.
Die oben genannte Gesamtkomplexität von O(n log n) ändert sich durch die niedrigere Komplexitätsklasse eines Teilalgorithmus nicht.
Laufzeit des Java Heapsort Beispiels
Mit der Klasse UltimateTest kann die Laufzeit verschiedener Sortieralgorithmen für unterschiedliche Eingabegrößen ermittelt werden.
Die folgende Tabelle zeigt die Mediane der Laufzeiten für das Sortieren von zufällig angeordneten sowie aufsteigend und absteigend vorsortierten Elementen (dies ist der Übersicht halber nur ein Auszug):
| n | unsortiert | aufsteigend | absteigend |
|---|---|---|---|
| ... | ... | ... | ... |
| 2.097.152 | 172,6 ms | 80,3 ms | 85,7 ms |
| 4.194.304 | 381,4 ms | 165,3 ms | 177,0 ms |
| 8.388.608 | 893,2 ms | 341,5 ms | 364,0 ms |
| 16.777.216 | 2.298,4 ms | 700,0 ms | 750,2 ms |
| 33.554.432 | 5.663,5 ms | 1.434,7 ms | 1.537,5 ms |
| 67.108.864 | 13.005,5 ms | 2.962,3 ms | 3.158,8 ms |
Hier die Messwerte als Diagramm:
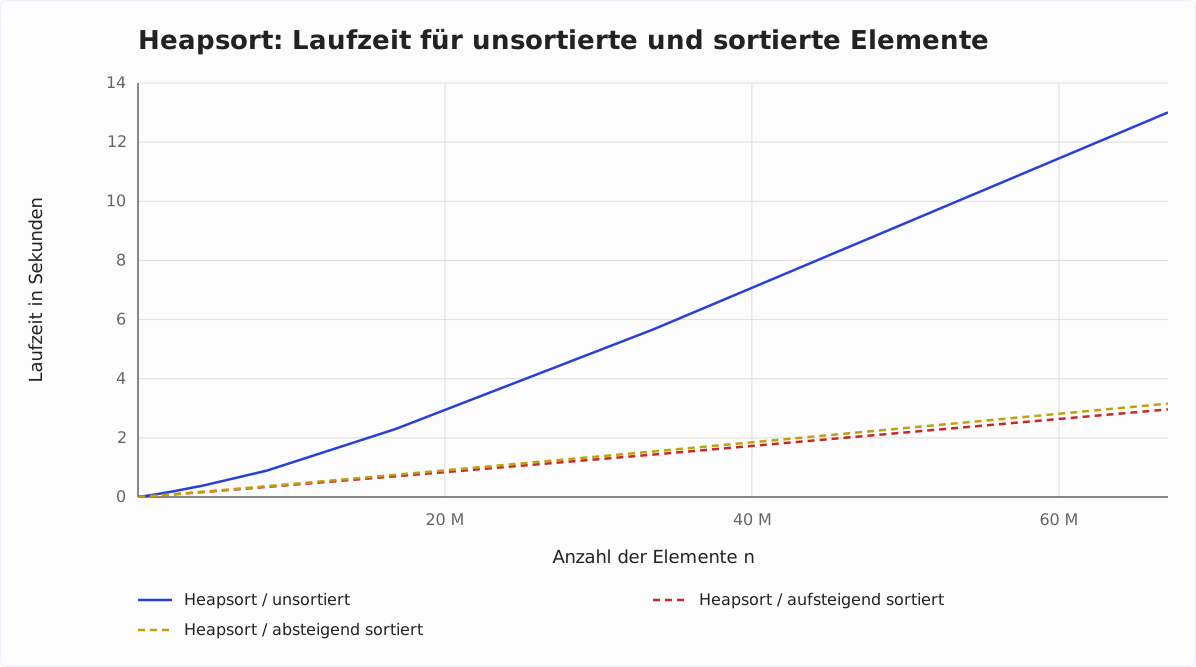
Es lässt sich gut sehen:
- Bei Verdopplung der Eingabemenge dauert das Sortieren vorsortierter Elemente etwas mehr als doppelt so lange (Faktor 2,05 bis 2,07 in der Tabelle); dies entspricht der erwarteten quasilinearen Laufzeit O(n log n). Bei unsortierten Elementen steigt der Faktor auf bis zu 2,6.
- Für vorsortierte Eingabedaten ist Heapsort 2,1- bis 4,4-mal so schnell wie für unsortierte (absteigend sortierte: 2,0- bis 4,1-mal) – je größer das Array, desto größer der Unterschied.
- Absteigend sortierte Eingabedaten brauchen etwa 7 % länger als aufsteigend sortierte.
Warum ist Heapsort für vorsortierte Eingabedaten schneller?
Um dieser Frage auf den Grund zu gehen, verwende ich das Programm CountOperations, um die Vergleichs-, Lese- und Schreiboperationen von Heapsort in beiden Phasen zu zählen – für unsortierte sowie aufsteigend und absteigend sortierte Daten.
Das Ergebnis findest du in der Datei CountOperations_Heapsort.log. Die Erkenntnisse aus dem Test sind:
- Wenn die Eingabedaten absteigend sortiert sind, gibt es in Phase 1 nur etwa halb so viele Vergleiche wie bei unsortierten oder aufsteigend sortierten Daten; außerdem gibt es keine Tauschoperationen. Dies liegt daran, dass ein absteigend sortiertes Array bereits einem Max Heap entspricht.
- Aufsteigend sortierte Eingabedaten hingegen entsprechen einem Min Heap. Dieser muss in der
buildHeap()-Phase komplett umgedreht werden, deshalb haben wir in diesem Fall etwa ein Drittel mehr Tauschoperationen als bei zufällig angeordneten Daten, in denen die Heap-Bedingung bereits an einigen Teilbäumen erfüllt ist. - In Phase 2 unterscheidet sich die Anzahl der Operationen nur minimal.
Wie lässt sich dann erklären, dass Heapsort sowohl für aufsteigend als auch für absteigend vorsortierte Eingabedaten so viel schneller ist?
Die naheliegende Erklärung ist die sogenannte Sprungvorhersage (englisch „branch prediction“).
Bei vorsortierten Eingabedaten führen die Vergleichsoperationen immer wieder zum selben Ergebnis. Wenn die Sprungvorhersage nun davon ausgeht, dass die Vergleiche auch in Zukunft zum selben Ergebnis führen, können die Befehls-Pipelines der CPU voll ausgenutzt werden.
Bei unsortierten Eingabedaten hingegen kann keine zuverlässige Aussage über zukünftige Vergleichsergebnisse getroffen werden. Entsprechend muss die Befehls-Pipeline häufig geleert und neu gefüllt werden.
Bottom-Up-Heapsort
Bottom-Up-Heapsort ist eine Variante, bei der die heapify()-Methode durch geschickte Optimierung mit weniger Vergleichen auskommt. Dies ist vorteilhaft, wenn nicht beispielsweise int-Primitive verglichen werden, sondern Objekte mit einer aufwändigen compareTo()-Methode.
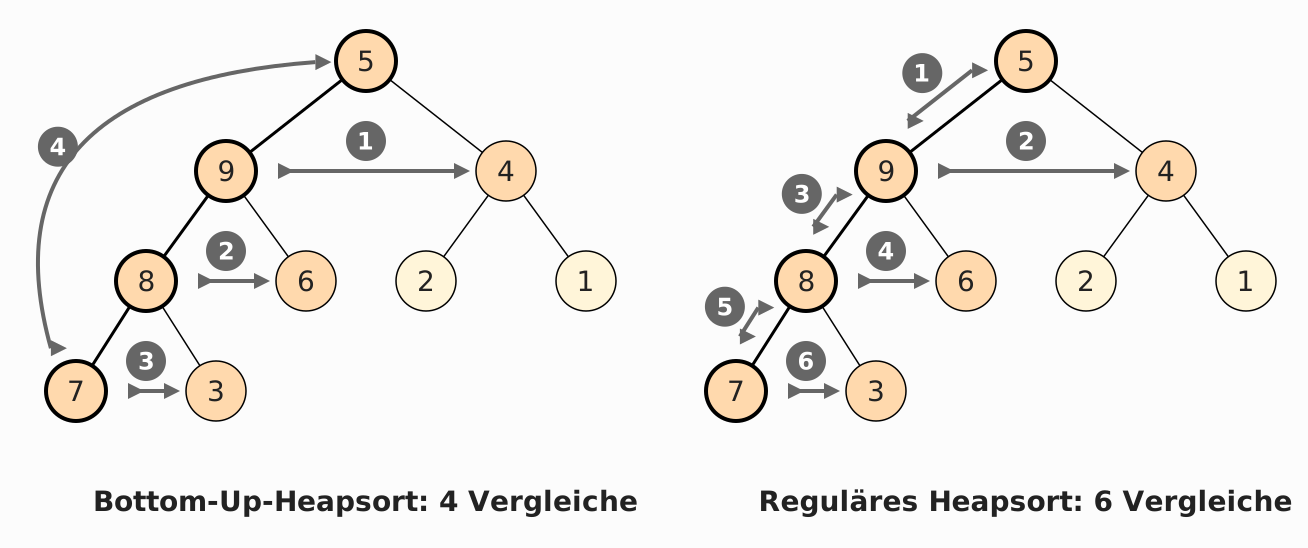
Im regulären heapify() führen wir von oben nach unten an jedem Knoten zwei Vergleiche aus, um das größte von drei Elementen zu finden:
- Elternknoten mit linkem Kind
- Der größere Knoten aus dem ersten Vergleich mit dem zweiten Kind
Bottom-Up-Heapsort Algorithmus
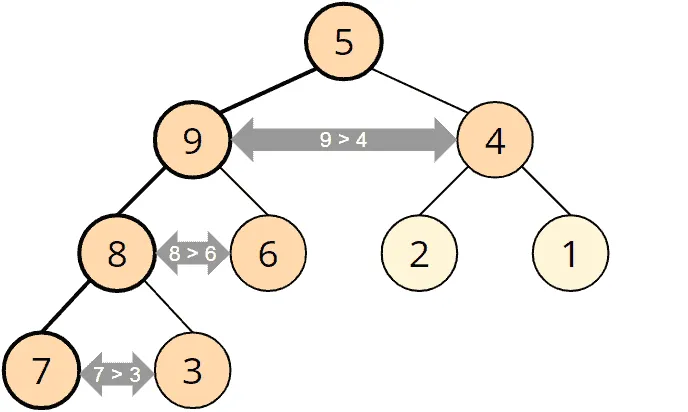
Bottom-Up-Heapsort hingegen vergleicht nur die zwei Kinder miteinander und folgt dem jeweils größeren Kind bis zum Ende des Baumes („top-down“). Von dort geht der Algorithmus wieder zurück Richtung Baumwurzel („bottom-up“) und sucht das erste Element, das nicht kleiner als die Wurzel ist. Von hier ab werden alle Elemente jeweils um eine Position Richtung Wurzel verschoben, und das Wurzelelement wird auf das freigewordene Feld gesetzt.
Das folgende Beispiel soll das Verständnis erleichtern.
Bottom-Up-Heapsort Beispiel
In folgendem Beispiel werden die 9 und 4 verglichen, dann die Kinder der 9 – die 8 und die 6, und zuletzt die Kinder der 8 – die 7 und die 3:
Wir erreichen auf diese Weise die 7 und vergleichen diese mit der Baumwurzel, der 5:
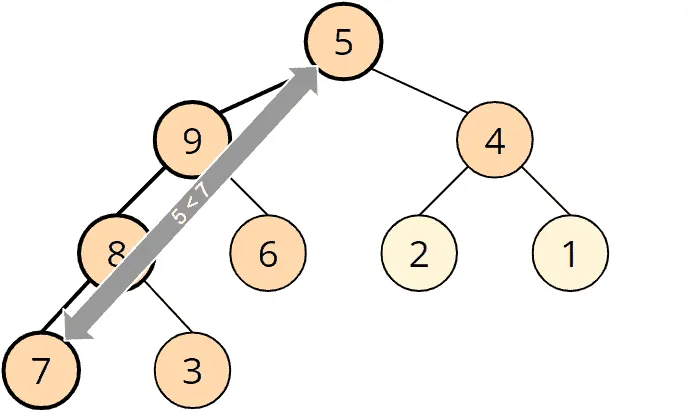
Die 5 ist kleiner als die 7. Das bedeutet, dass das Wurzelelement bis ganz nach unten durchgereicht werden muss:
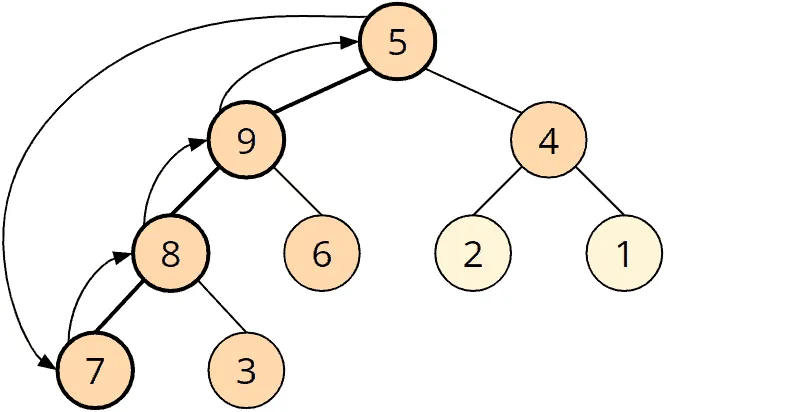
Im Endeffekt führt dies zum gleichen Ergebnis wie das reguläre heapify().
Bottom-Up-Heapsort macht sich zunutze, dass das Wurzelelement in der Regel sehr weit nach unten geschoben wird, da dieses nach jeder Iteration vom Ende des Baumes kommt und deshalb meist klein ist.
Somit sind weniger Vergleiche nötig, wenn einmal bis ganz nach unten verglichen wird und dann wieder ein kurzes Stück nach oben, als wenn von oben bis nach ganz unten jeweils zwei Vergleiche durchgeführt werden. Das folgende Bild zeigt beide Varianten am Beispiel von oben; die Zahlen an den Pfeilen geben die Reihenfolge der Vergleiche an:
Bottom-Up-Heapsort Quellcode
Die Klasse BottomUpHeapsort erbt von Heapsort und überschreibt lediglich deren heapify()-Methode mit der folgenden:
@Override
void heapify(int[] heap, int length, int rootPos) {
  int leafPos = findLeaf(heap, length, rootPos);
  int nodePos = findTargetNodeBottomUp(heap, rootPos, leafPos);

  if (rootPos == nodePos) {
    return;
  }

  // Move all elements starting at nodePos to parent, move root to nodePos
  int nodeValue = heap[nodePos];
  heap[nodePos] = heap[rootPos];

  while (nodePos > rootPos) {
    int parentPos = getParentPos(nodePos);
    int parentValue = heap[parentPos];
    heap[parentPos] = nodeValue;
    nodePos = parentPos;
    nodeValue = parentValue;
  }
}
Die findLeaf()-Methode vergleicht jeweils zwei Kinder und folgt dem jeweils größeren, bis das Ende des Baumes erreicht ist (bzw. ein Knoten, der nur noch ein Kind hat):
int findLeaf(int[] heap, int length, int rootPos) {
  int pos = rootPos;
  int leftChildPos = pos * 2 + 1;
  int rightChildPos = pos * 2 + 2;

  // Do two children exist?
  while (rightChildPos < length) {
    if (heap[rightChildPos] > heap[leftChildPos]) {
      pos = rightChildPos;
    } else {
      pos = leftChildPos;
    }
    leftChildPos = pos * 2 + 1;
    rightChildPos = pos * 2 + 2;
  }

  // Does one child exist?
  if (leftChildPos < length) {
    pos = leftChildPos;
  }

  return pos;
}
Die Methode findTargetNodeBottomUp() sucht von unten nach oben das erste Element, das nicht kleiner als der Wurzelknoten ist:
int findTargetNodeBottomUp(int[] heap, int rootPos, int leafPos) {
  int parent = heap[rootPos];
  while (leafPos != rootPos && heap[leafPos] < parent) {
    leafPos = getParentPos(leafPos);
  }
  return leafPos;
}
Und zuletzt die getParentPos()-Methode:
int getParentPos(int pos) {
  return (pos - 1) / 2;
}
Bottom-Up-Heapsort Performance
Die Performance von Bottom-Up-Heapsort kann ebenfalls mit dem UltimateTest gemessen werden; die Messwerte stammen aus demselben Lauf wie die Tabelle oben:
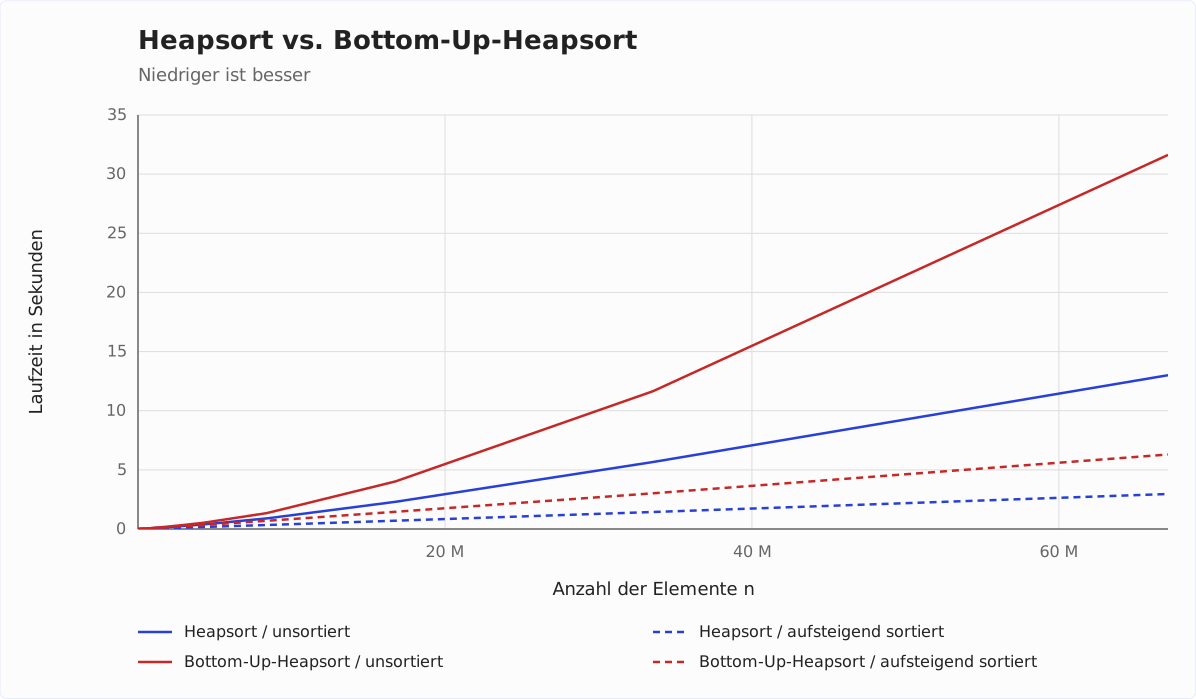
Bottom-Up-Heapsort ist also langsamer als das reguläre Heapsort – und zwar umso deutlicher, je größer das Array ist:
- Bei unsortierten Daten sind beide bis 65.536 Elemente gleich schnell (höchstens 3 % Unterschied). Danach fällt Bottom-Up-Heapsort zurück und braucht bei 67.108.864 Elementen 2,4-mal so lange.
- Bei sortierten Daten braucht Bottom-Up-Heapsort bei 67.108.864 Elementen etwa doppelt so lange (aufsteigend 2,1-mal, absteigend 2,0-mal).
2020 sah das noch anders aus: Damals war Bottom-Up-Heapsort bei unsortierten Daten bis etwa eine Million Elemente schneller und bei sortierten Daten höchstens 6 % langsamer.
Warum ist Bottom-Up-Heapsort langsamer?
An der Anzahl der Operationen liegt es nicht: Laut CountOperations braucht Bottom-Up-Heapsort weniger Vergleichs-, Lese- und Schreiboperationen als das reguläre Heapsort. Zwar geht es zweimal durch den Baum – nach unten und ein Stück zurück nach oben – und braucht dafür 1,8- bis 1,9-mal so viele Schleifendurchläufe. Dieses Verhältnis ist aber bei jeder Arraygröße fast gleich und erklärt den wachsenden Abstand nicht.
Auch der Rückweg kostet keine Speicherzugriffe: Der Weg nach unten ist bei 67.108.864 Elementen 26 Ebenen tief, und da die beiden Kinder einer Ebene in höchstens zwei Cache-Lines liegen, liest er höchstens 52 Cache-Lines zu je 128 Bytes, knapp 7 KB. Die liegen auf dem Rückweg noch im L1-Cache, der beim M5 Pro je nach Kern 64 oder 128 KB groß ist.
Der Unterschied liegt darin, wie die beiden Varianten den Baum hinabsteigen. Auf jeder Ebene müssen beide wissen, welches Kind größer ist, bevor sie weitergehen können:
- Heapsort rät. Der Vergleich ist ein bedingter Sprung, und der Prozessor sagt dessen Ergebnis voraus – die Sprungvorhersage von oben. So kann er die nächste Ebene schon laden, bevor der Vergleich fertig ist. Rät er falsch, muss er neu ansetzen; rät er richtig, hat er Zeit gewonnen.
- Bottom-Up-Heapsort wartet. Der JIT-Compiler übersetzt die Wahl des größeren Kindes in
findLeaf()ohne Sprung (auf ARM mit dem Befehlcsel). Es gibt nichts zu raten – aber die nächste Ebene kann erst geladen werden, wenn beide Kinder geladen und verglichen sind. Jeder Schritt wartet auf den vorigen.
Wie sich das auswirkt, zeigen die Performance-Counter des Prozessors, die ich beim Sortieren mitgelesen habe (Details in der Info-Box unten). Die Werte gelten pro Element, bei 67.108.864 Elementen:
| Variante, Eingabe | Takte | L1-Cache-Fehlzugriffe | Wartetakte auf Fehlzugriffe | falsche Sprungvorhersagen |
|---|---|---|---|---|
| Heapsort, unsortiert | 873 | 26,3 | 226 | 13,5 |
| Bottom-Up, unsortiert | 2.098 | 23,6 | 1.528 | 0,8 |
| Heapsort, aufsteigend | 196 | 0,3 | 1,0 | 3,6 |
| Bottom-Up, aufsteigend | 404 | 0,1 | 0,8 | 0,1 |
Mit diesen Zahlen lässt sich jeder der drei Fälle aus dem Diagramm erklären:
- Große unsortierte Arrays: Beide Varianten verfehlen den L1-Cache etwa gleich oft. Heapsort rät zwar etwa auf jeder zweiten Ebene falsch, lädt aber bei jedem richtigen Tipp voraus, sodass mehrere Fehlzugriffe gleichzeitig laufen. Bei Bottom-Up-Heapsort laufen sie nacheinander: Es wartet 1.528 Takte pro Element, Heapsort nur 226. Diese Differenz macht die gesamte Lücke aus.
- Sortierte Daten: Hier wartet keine der beiden Varianten auf den Speicher. Heapsort rät fast immer richtig und arbeitet ungebremst. Bottom-Up-Heapsort muss weiterhin Schritt für Schritt warten und braucht doppelt so viele Takte.
- Kleine unsortierte Arrays: Bis 65.536 Elemente verfehlen beide den L1-Cache kaum (höchstens 1,5-mal pro Element). Heapsort verliert Zeit durch seine falschen Tipps, Bottom-Up-Heapsort durch das Warten – beides kostet etwa gleich viel, und die Varianten sind gleich schnell.
Bottom-Up-Heapsort mit teuren Vergleichsoperationen
Bottom-Up-Heapsort optimiert dahingehend, dass weniger Vergleiche ausgeführt werden müssen. Bei int-Primitiven fallen Vergleiche nicht ins Gewicht, daher kann Bottom-Up-Heapsort hier seine Vorteile nicht ausspielen.
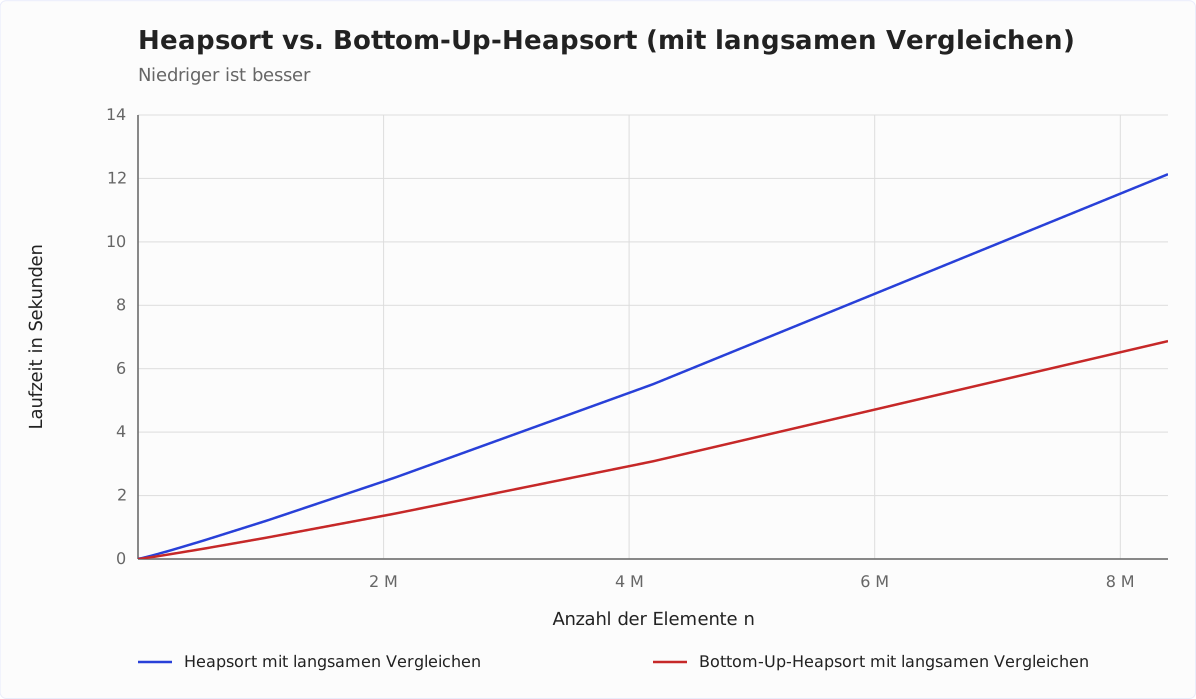
Ich habe daher einen weiteren Test ausgeführt, indem ich die Vergleichsoperationen künstlich verteuert habe. Du findest die angepassten Algorithmen in den Klassen HeapsortSlowComparisons und BottomUpHeapsortSlowComparisons im GitHub-Repository.
Sie bremsen jeden Vergleich mit Thread.onSpinWait(). Auf x86-Prozessoren übersetzt der JIT-Compiler diesen Aufruf in die Instruktion PAUSE, die den Prozessor kurz warten lässt. Auf dem Apple M5 erzeugt JDK 27 stattdessen eine YIELD-Instruktion, die dort praktisch nichts kostet – ohne weiteres Zutun sind die langsamen Varianten so schnell wie die ohne Bremse. Für die Messung habe ich die JVM daher pro Aufruf vier ISB-Instruktionen (Instruktionsbarrieren) erzeugen lassen; die JVM-Optionen stehen in der Info-Box unten.
Bottom-Up-Heapsort schneidet bei diesem Vergleich deutlich besser ab – ab 16.384 Elementen ist es 1,74- bis 1,79-mal so schnell wie das reguläre Heapsort:
Weitere Eigenschaften von Heapsort
Im Folgenden werden die Platzkomplexität von Heapsort, dessen Stabilität und Parallelisierbarkeit betrachtet.
Platzkomplexität von Heapsort
Heapsort ist ein In-Place-Sortierverfahren, d. h. außer für Schleifen- und Hilfsvariablen wird kein zusätzlicher Speicherplatz benötigt. Die Anzahl dieser Variablen ist immer gleich, egal ob wir zehn Elemente sortieren oder zehn Millionen. Daher gilt:
Die Platzkomplexität von Heapsort ist: O(1).
Stabilität von Heapsort
Es lassen sich sehr leicht Beispiele konstruieren, die zeigen, dass Elemente mit gleichem Key ihre Position zueinander ändern können:
Beispiel 1
Wenn wir das Array [3, 2a, 2b, 1] mit Heapsort sortieren, sehen die Schritte wie folgt aus (2a und 2b stellen zwei Elemente mit demselben Key dar; hellgelb markiert sind die Elemente, die im nächsten Schritt vertauscht werden; blau markiert sind fertig sortierte Elemente):
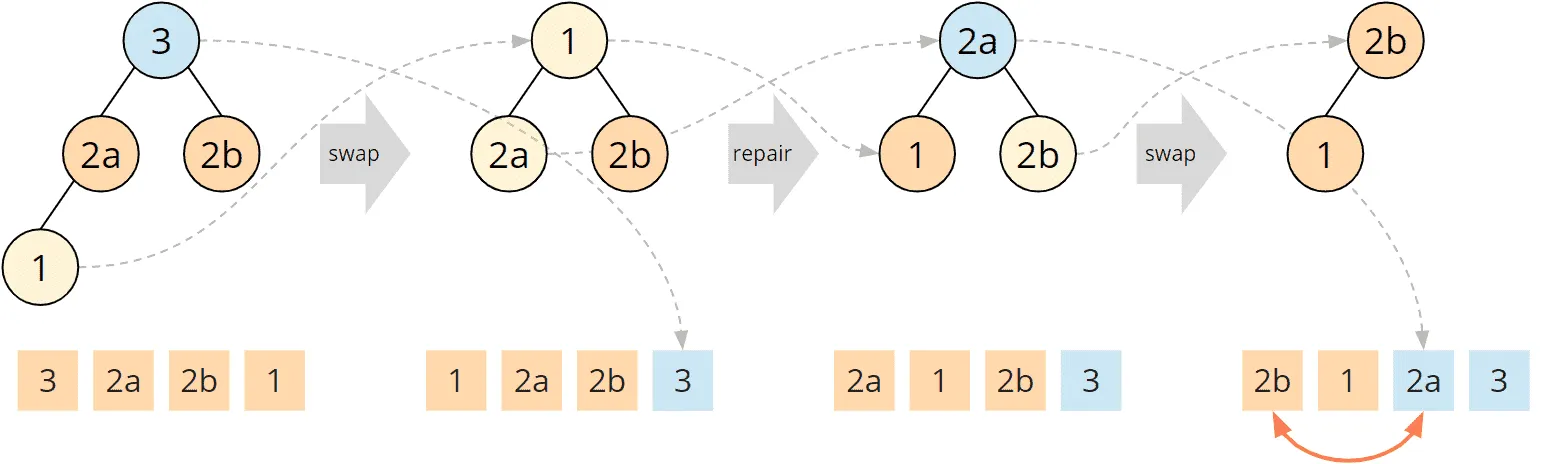
An dieser Stelle können wir abbrechen, denn wir sehen bereits jetzt, dass das Ziel-Array auf [2a, 3] enden wird, d. h. die 2a wird rechts neben der 2b im Ziel-Array landen.
Algorithmus anpassen?
Im zweiten Schritt haben wir entsprechend dem Algorithmus die 1 mit der 2a vertauscht. Könnten wir den Algorithmus so ändern, dass bei Kindknoten mit gleichem Key nicht mit dem linken Kind getauscht wird, sondern mit dem rechten?
In dem Fall würde das Array oben stabil sortiert werden, da die 1 nicht mit der 2a, sondern mit der 2b getauscht werden würde, und daraufhin die 2b an der vorletzten Stelle des Arrays landen würde.
Beispiel 2
Versuchen wir das einmal mit einem anderen Eingabearray, mit [4, 3, 2a, 2b, 1]:
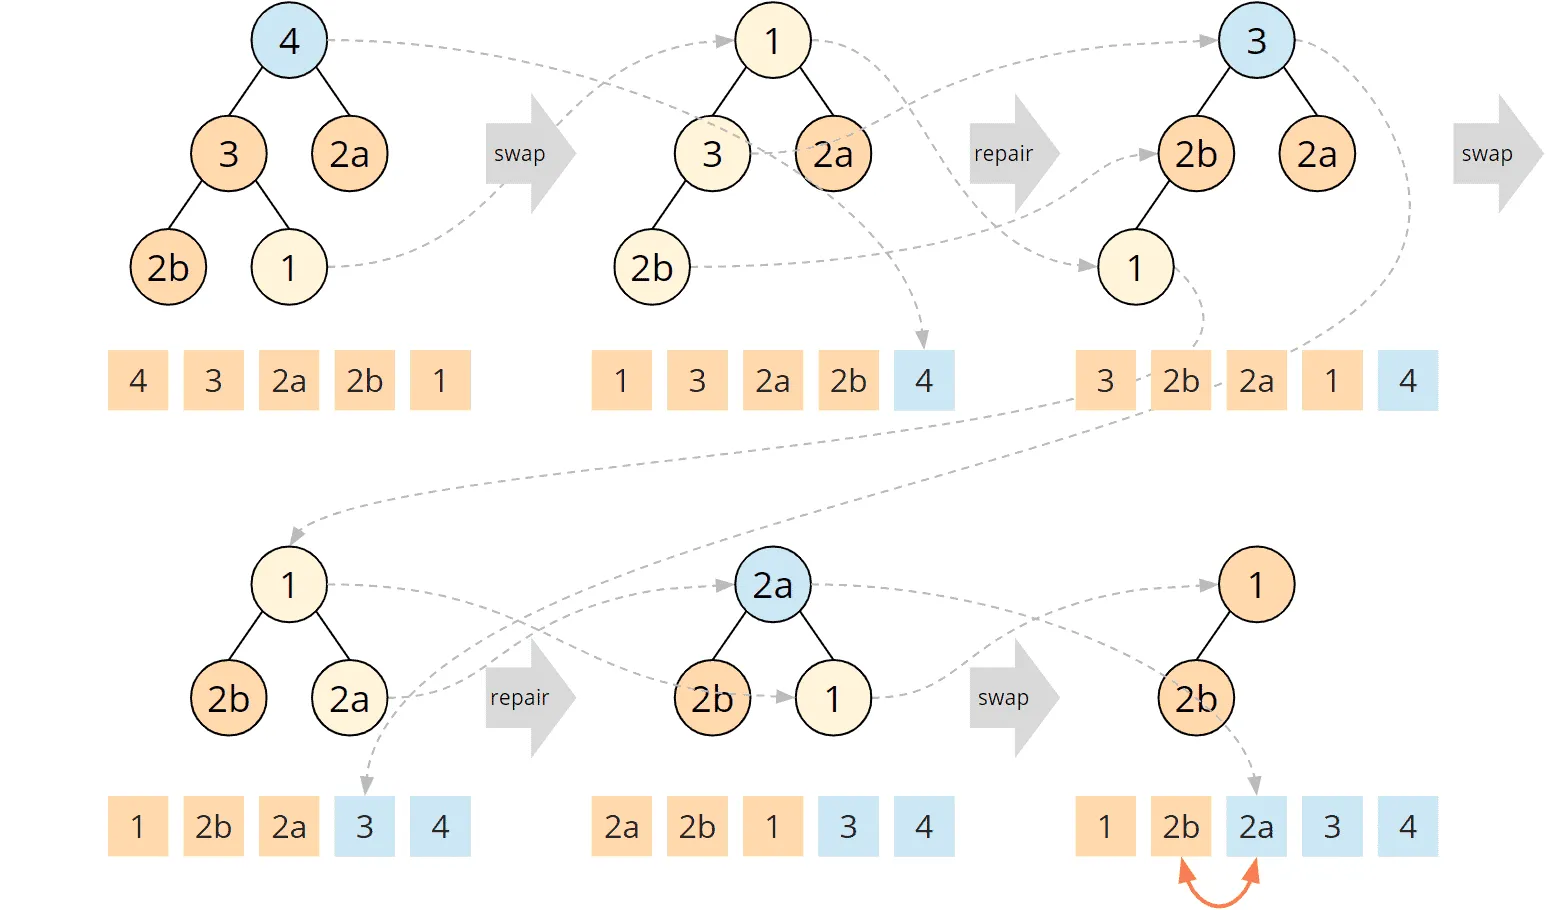
Nach Schritt 2 wurde der Stand erreicht, den wir zuvor als Ausgangsarray hatten, wobei jedoch 2a und 2b ihre Positionen getauscht haben. Wenn wir im nächsten Schritt die 1 nun mit dem rechten Kind tauschen, passiert das Gleiche wie oben: Die 2a landet zuerst im Ziel-Array und damit rechts von der 2b.
Wir haben für beide Algorithmus-Varianten Gegenbeispiele gezeigt und können daher feststellen:
Heapsort ist kein stabiles Sortierverfahren.
Parallelisierbarkeit von Heapsort
Bei Heapsort wird das gesamte Array ständig verändert, sodass es keine naheliegenden Lösungen gibt, den Algorithmus zu parallelisieren.
Vergleich von Heapsort mit anderen effizienten Sortierverfahren
Im folgenden Diagramm siehst du die Laufzeiten von Heapsort im Vergleich zu denen von Quicksort und Mergesort (im Englischen in der Regel „Merge Sort“), gemessen auf derselben Maschine. Die Werte für Quicksort und Mergesort stammen aus einem Lauf vom 27. September 2026; Quicksort wählt wie in der Messung von 2020 das mittlere Element als Pivot:
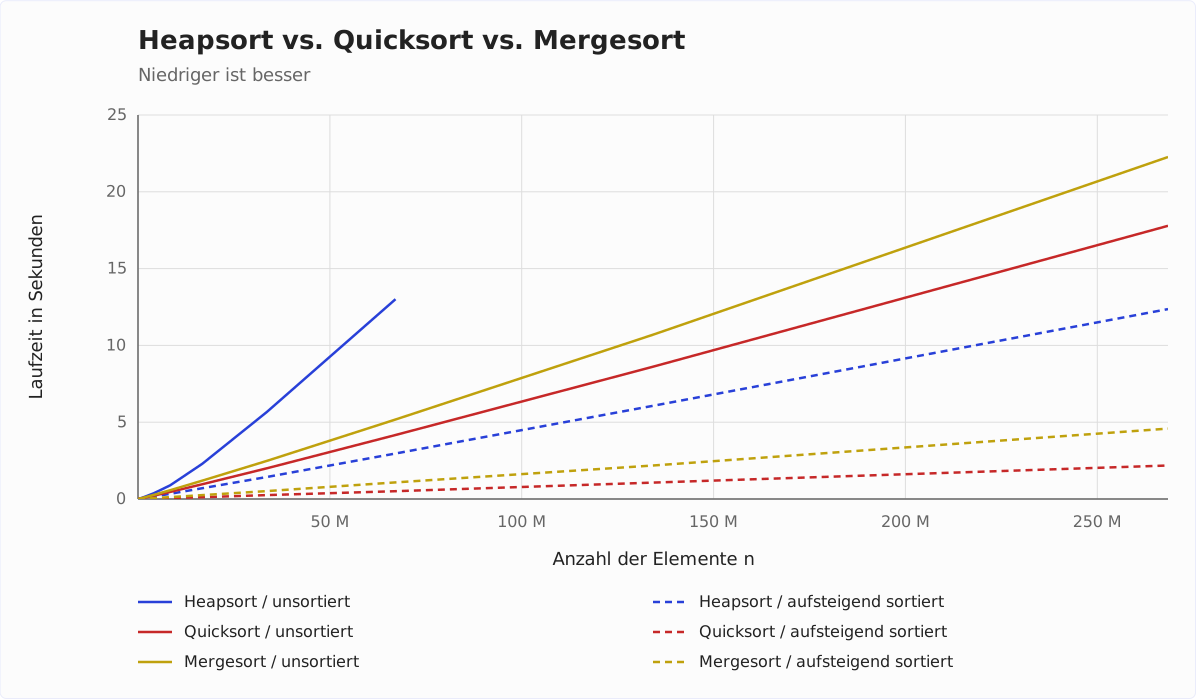
Für 67.108.864 zufällig verteilte Elemente braucht Heapsort 13,0 Sekunden, Quicksort 4,2 und Mergesort 5,2 Sekunden. Heapsort braucht damit 3,1-mal so lange wie Quicksort und 2,5-mal so lange wie Mergesort (2020: 3,6- und 2,4-mal). Bei aufsteigend sortierten Daten braucht Heapsort ab 16.384 Elementen 5,7- bis 6,2-mal so lange wie Quicksort (2020: 8- bis 9-mal) und 2,7- bis 2,9-mal so lange wie Mergesort (2020: 2-mal).
Heapsort vs. Quicksort
Wie im vorangegangenen Abschnitt gezeigt, ist Quicksort in der Regel deutlich schneller als Heapsort.
Weil Quicksort im Worst Case eine Zeitkomplexität von O(n²) hat, wird in der Praxis in manchen Fällen Heapsort gegenüber Quicksort vorgezogen.
Wie im Artikel über Quicksort gezeigt, ist bei geeigneter Wahl des Pivot-Elements der Eintritt des Worst Case unwahrscheinlich. Dennoch bleibt ein gewisses Risiko: Wer die verwendete Quicksort-Implementierung gut genug kennt, kann eine Anwendung mit entsprechend präparierten Eingabedaten in die Knie zwingen.
Die Java-Klassenbibliothek kombiniert deshalb beide Verfahren: Seit Java 14 wechselt Arrays.sort() für int-, long-, float- und double-Arrays von Dual-Pivot-Quicksort zu Heapsort, sobald die Rekursion zu tief wird. So bleibt die Laufzeit auch bei präparierten Eingabedaten bei O(n log n). Dieses Prinzip – Quicksort mit Heapsort als „Notbremse“ – heißt Introsort.
Für diese Änderung gibt es keinen JEP; sie wird im Bug-Tracker unter JDK-8226297 aufgeführt.
Heapsort vs. Mergesort
Auch Mergesort ist in der Regel schneller als Heapsort. Außerdem ist Mergesort im Gegensatz zu Heapsort stabil.
Heapsort hat gegenüber Mergesort den Vorteil, dass es keinen zusätzlichen Speicherbedarf hat, während Mergesort zusätzlichen Speicher in der Größenordnung O(n) benötigt.
Zusammenfassung
Heapsort ist ein effizienter, nicht-stabiler Sortieralgorithmus mit einer Zeitkomplexität von O(n log n) im Average und Worst Case. Nur wenn alle Elemente gleich sind, bricht heapify() sofort ab – dann sortiert Heapsort in O(n).
Heapsort ist deutlich langsamer als Quicksort und Mergesort. Als alleiniges Sortierverfahren triffst du es deshalb selten an, wohl aber als „Notbremse“: Seit Java 14 schaltet Arrays.sort() darauf um, wenn Quicksort bei einem int-, long-, float- oder double-Array zu tief rekursiert.
Übrigens: Einen Binär-Heap, wie ihn Heapsort in Phase 1 aufbaut, nutzt auch die Java-Klasse PriorityQueue als interne Datenstruktur.
Weitere Sortieralgorithmen findest du in der Übersicht aller Sortieralgorithmen und ihrer Eigenschaften im ersten Teil der Artikelserie.
Hat dir dieser Artikel Zeit gespart? Dann freue ich mich, wenn du eine Minute davon in eine Bewertung auf meinem ProvenExpert-Profil investierst. Dein Feedback zeigt mir, dass sich die Arbeit an diesen Artikeln lohnt.