Ein BufferedReader liest Text aus einer Quelle – einer Datei, einem Netzwerk-Stream, der Konsole – in großen Blöcken in einen Puffer, statt jedes Zeichen einzeln von der Quelle zu holen. Aus diesem Puffer liefert er den Text Zeichen für Zeichen oder Zeile für Zeile. So liest du auch große Textdateien zeilenweise, ohne sie komplett in den Arbeitsspeicher laden zu müssen.
Für eine Datei sieht der Code dafür in den meisten Fällen so aus:
try (BufferedReader reader = Files.newBufferedReader(Path.of("files/server.log"))) {
  String line;
  while ((line = reader.readLine()) != null) {
    System.out.println(line);
  }
}
2026-10-17 08:15:02 INFO Server started on port 8080
2026-10-17 08:15:07 INFO GET /java/java-bufferedreader/ 200
2026-10-17 08:15:09 WARN GET /java/bufferedreader/ 404
2026-10-17 08:15:11 INFO GET /java/java-streams/ 200
2026-10-17 08:15:12 ERROR Connection reset by peerFiles.newBufferedReader() öffnet die Datei und liefert einen BufferedReader, der die Datei als UTF-8 dekodiert. readLine() liefert bei jedem Aufruf die nächste Zeile, ohne das Zeilenende, und am Ende der Datei null. Das Try-with-resources schließt den Reader – und damit die Datei – auch dann, wenn beim Lesen eine Exception auftritt.
BufferedReader gibt es seit Java 1.1. Seitdem ist einiges dazugekommen: Files.newBufferedReader() in Java 7, die Methode lines() in Java 8, readAllLines() und readAllAsString() in Java 25 und, ebenfalls in Java 25, die Klasse IO, die intern selbst einen BufferedReader verwendet.
In diesem Artikel erfährst du,
- wie ein
BufferedReaderpuffert und warum er schneller ist als einFileReaderallein, - welche Wege es gibt, einen
BufferedReaderzu erzeugen, und welchen ich empfehle, - was passiert, wenn die Zeichenkodierung der Datei nicht passt,
- welche Zeilenenden
readLine()erkennt und wann esnullliefert, - wie du Zeilen mit
lines()als Stream verarbeitest, - wie du mit
mark()undreset()vorausliest und warumready()nicht sagt, ob noch Zeilen kommen, - wie du mit einem
BufferedReaderund mitIO.readln()von der Konsole liest, - wie schnell die einzelnen Lesemethoden sind,
- worin sich
BufferedReaderundScannerunterscheiden.
Die Beispiele in diesem Artikel
Die meisten Beispiele lesen die kleine Log-Datei files/server.log aus der Einleitung. Sie hat fünf Zeilen, jede mit Datum, Uhrzeit, Log-Level und Nachricht. Der Log-Level steht immer an den Positionen 20 bis 24 (von 0 an gezählt) und ist mit Leerzeichen auf fünf Zeichen aufgefüllt.
Den vollständigen Code sowie die Datei server.log findest du im GitHub-Repository java-bufferedreader, im Package eu.happycoders.bufferedreader. Jeder Abschnitt hat dort eine eigene Klasse mit main()-Methode, die die gezeigten Ausgaben erzeugt. Starte die Klassen im Hauptverzeichnis des Repositorys; Dateien, die von den Beispielen angelegt werden, landen im Verzeichnis target/.
Die Beispiele verwenden Methoden aus Java 25 und laufen deshalb erst ab dieser Version. Wo eine Methode jünger ist als Java 8, steht im Text, seit wann es sie gibt.
Was ist ein BufferedReader?
BufferedReader ist ein Reader, der einen anderen Reader umhüllt. Er liest von diesem nicht Zeichen für Zeichen, sondern in Blöcken von bis zu 8.192 Zeichen, legt sie in einem internen Puffer ab und bedient alle folgenden read()- und readLine()-Aufrufe aus diesem Puffer. Erst wenn der Puffer leer ist, holt er den nächsten Block.
Der BufferedReader speichert den umhüllten Reader in einem Feld vom Typ Reader und ruft zum Lesen auf ihm ausschließlich die Methode read(char[], int, int) auf. Er funktioniert deshalb mit jeder Unterklasse von Reader. Meist ist der umhüllte Reader ein InputStreamReader, der die Bytes eines InputStream in Zeichen umwandelt. Die folgende Grafik zeigt, wie die Klassen zum Lesen von Dateien zusammenhängen. Die durchgezogenen Linien stehen für Binärdaten, also Bytes, die gestrichelten für Textdaten, also Zeichen und Strings:
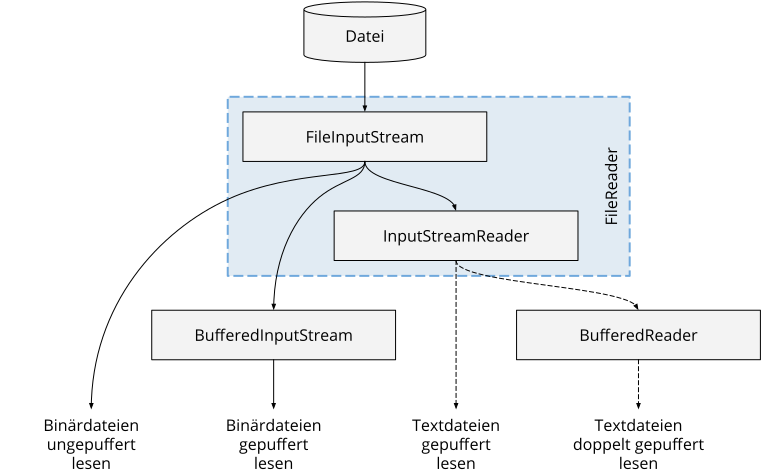
FileReader ist eine Kombination aus FileInputStream und InputStreamReader. Und der InputStreamReader hat selbst schon einen Puffer: Er liest die Bytes in Blöcken von 8.192 Bytes und dekodiert sie zu Zeichen.
Warum dann noch ein BufferedReader? Weil der Puffer des InputStreamReader nur die Zugriffe auf die Datei bündelt, nicht das Dekodieren der Zeichen. Jeder read()-Aufruf auf einem InputStreamReader legt ein neues char-Array der Länge 2 an, synchronisiert, prüft die Array-Grenzen und lässt den Decoder höchstens zwei chars dekodieren.
Warum zwei? Ein char ist in Java eine UTF-16-Codeeinheit. Zeichen außerhalb der sogenannten Basic Multilingual Plane, z. B. viele Emojis, belegen zwei davon, ein sogenanntes Surrogatpaar. Der Decoder kann ein solches Zeichen nur als Ganzes dekodieren und braucht dafür Platz für zwei chars. read() gibt dann das erste char zurück und merkt sich das zweite für den nächsten Aufruf.
Der BufferedReader dagegen lässt den Decoder bis zu 8.192 Zeichen auf einmal dekodieren. Ein read() auf dem BufferedReader ist danach bis zum nächsten Nachfüllen nur noch ein Zugriff auf sein char-Array.
Der zweite Vorteil ist die Methode readLine(): Sie gibt es nur im BufferedReader, nicht in Reader, InputStreamReader oder FileReader.
Einen BufferedReader erzeugen
Es gibt drei gebräuchliche Wege, um einen BufferedReader zu erzeugen: über Files.newBufferedReader(), über einen FileReader und über einen InputStreamReader. Die ersten beiden Varianten lesen Dateien, die dritte liest aus einem beliebigen InputStream.
Files.newBufferedReader()
Die Methode Files.newBufferedReader() aus der NIO.2-API gibt es seit Java 7. Sie erwartet einen Path und liefert einen fertigen BufferedReader:
Path log = Path.of("files/server.log");
try (BufferedReader reader = Files.newBufferedReader(log)) {
  System.out.println(reader.readLine());
}
2026-10-17 08:15:02 INFO Server started on port 8080Ohne Angabe einer Zeichenkodierung dekodiert der so erzeugte Reader die Datei als UTF-8. Eine andere Kodierung übergibst du als zweites Argument, z. B. Files.newBufferedReader(log, StandardCharsets.ISO_8859_1).
new BufferedReader(new FileReader(…))
Der klassische Weg verschachtelt zwei Konstruktoraufrufe: Ein FileReader öffnet die Datei, und ein BufferedReader umhüllt ihn.
try (BufferedReader reader =
    new BufferedReader(new FileReader("files/server.log", UTF_8))) {
  System.out.println(reader.readLine());
}
2026-10-17 08:15:02 INFO Server started on port 8080Den FileReader-Konstruktor mit Charset-Parameter gibt es seit Java 11. Ohne diesen Parameter verwendet der FileReader die Standard-Kodierung der JVM, und die ist seit Java 18 ebenfalls UTF-8. Bis einschließlich Java 17 hing sie vom Betriebssystem und der Locale ab; Details dazu stehen im Artikel über das Lesen von Dateien, im Abschnitt Welche Zeichenkodierung verwendet Java standardmäßig zum Lesen von Textdateien?
Das Try-with-resources muss nur den BufferedReader deklarieren. Wird er geschlossen, schließt er auch den FileReader – wie das genau abläuft, zeigt der Abschnitt Einen BufferedReader schließen.
InputStreamReader: ein BufferedReader um einen beliebigen InputStream
Nicht jeder Text liegt als Datei vor. Kommt er aus einem Netzwerk-Socket, aus der Ausgabe eines Prozesses, aus einer Ressource im Classpath oder aus einer komprimierten Datei, liefert dir die jeweilige API einen InputStream. Den wandelt ein InputStreamReader in Zeichen um, und um diesen legst du den BufferedReader.
Das folgende Beispiel komprimiert die Log-Datei mit GZIPOutputStream und liest die erste Zeile aus der komprimierten Datei:
Path log = Path.of("files/server.log");
Path gzipped = Path.of("target/server.log.gz");
try (OutputStream out = new GZIPOutputStream(Files.newOutputStream(gzipped))) {
  Files.copy(log, out);
}

try (BufferedReader reader =
    new BufferedReader(
        new InputStreamReader(
            new GZIPInputStream(Files.newInputStream(gzipped)), UTF_8))) {
  System.out.println(reader.readLine());
}
2026-10-17 08:15:02 INFO Server started on port 8080Die Kette liest sich von innen nach außen: Files.newInputStream() liefert die komprimierten Bytes, GZIPInputStream entpackt sie, InputStreamReader dekodiert die entpackten Bytes als UTF-8, und BufferedReader puffert die Zeichen und zerlegt sie in Zeilen.
Gib beim InputStreamReader die Kodierung immer an. Welche Kodierung die Bytes haben, hängt von ihrer Quelle ab – an den Bytes selbst lässt sie sich nicht ablesen.
Die Puffergröße festlegen
Ein zweiter Konstruktor nimmt die Größe des Puffers in Zeichen entgegen:
try (BufferedReader reader =
    new BufferedReader(new FileReader(log.toFile(), UTF_8), 65_536)) {
  System.out.println(reader.readLine());
}
2026-10-17 08:15:02 INFO Server started on port 8080Ohne diesen Parameter ist der Puffer 8.192 Zeichen groß. Ob ein größerer Puffer das Lesen beschleunigt, zeigt der Abschnitt Wie schnell ist der BufferedReader?
Wenn die Zeichenkodierung nicht passt
Files.newBufferedReader() unterscheidet sich von den beiden anderen Wegen in einem Punkt, der erst auffällt, wenn eine Datei nicht in der erwarteten Kodierung vorliegt.
Das folgende Programm schreibt „Grüße aus Köln“ als ISO-8859-1 in eine Datei. In ISO-8859-1 belegt jeder Umlaut ein Byte, in UTF-8 zwei. Anschließend liest es die Datei dreimal: mit Files.newBufferedReader(), mit einem FileReader für UTF-8 und mit Files.newBufferedReader() für ISO-8859-1:
Path latin1 = Path.of("target/greeting-latin1.txt");
Files.writeString(latin1, "Grüße aus Köln", ISO_8859_1);

try (BufferedReader reader = Files.newBufferedReader(latin1)) {
  System.out.println(reader.readLine());
} catch (MalformedInputException e) {
  System.out.println("Files.newBufferedReader(): " + e);
}

try (BufferedReader reader =
    new BufferedReader(new FileReader(latin1.toFile(), UTF_8))) {
  System.out.println("FileReader:                " + reader.readLine());
}

try (BufferedReader reader = Files.newBufferedReader(latin1, ISO_8859_1)) {
  System.out.println("With ISO_8859_1:           " + reader.readLine());
}
Files.newBufferedReader(): java.nio.charset.MalformedInputException: Input length = 1
FileReader: Gr��e aus K�ln
With ISO_8859_1: Grüße aus KölnBeide Reader in den ersten zwei Versuchen dekodieren UTF-8, und beide stoßen auf das Byte des „ü“, das in UTF-8 kein gültiges Zeichen ist. Sie reagieren aber verschieden:
- Der Reader aus
Files.newBufferedReader()wirft eineMalformedInputException, eine Unterklasse vonIOException. - Der
FileReaderersetzt jedes ungültige Byte durch das Unicode-Ersatzzeichen U+FFFD, das die meisten Schriftarten als Raute mit Fragezeichen zeichnen – und liest ohne Fehlermeldung weiter.
Erst mit der passenden Kodierung im dritten Versuch kommt der Text richtig an.
Ich empfehle Files.newBufferedReader() für alle Dateien. Eine Datei in der falschen Kodierung fällt dann beim ersten ungültigen Byte auf, statt als Text mit Ersatzzeichen weiterverarbeitet zu werden. Der Preis: Eine Datei, die auch nur ein ungültiges Byte enthält, lässt sich so nicht lesen. Musst du solche Dateien trotzdem verarbeiten, nimm bewusst einen InputStreamReader oder FileReader und prüfe die gelesenen Zeilen auf U+FFFD.
Wie Zeichenkodierungen funktionieren und wie dieselben Bytes je nach Kodierung zu anderen Zeichen werden, erklärt der Abschnitt Zeichenkodierung im Artikel über das Lesen von Dateien.
Zeilenweise lesen mit readLine()
readLine() liest so lange Zeichen, bis es auf ein Zeilenende trifft, und liefert alles davor als String. Das Zeilenende selbst ist nicht Teil des Ergebnisses.
Zeilenenden
Welche Zeichen eine Zeile beenden, hängt vom Betriebssystem ab, das die Datei geschrieben hat: Linux und macOS verwenden ein Line Feed (\n), Windows die Kombination Carriage Return und Line Feed (\r\n), das klassische Mac OS bis Version 9 ein einzelnes Carriage Return (\r). readLine() erkennt alle drei, auch gemischt in einer Datei – und als viertes Zeilenende das Ende der Eingabe.
Das folgende Beispiel liest mit einer kleinen Hilfsmethode einen Text, der alle vier Zeilenenden enthält. Die Hilfsmethode setzt jede Zeile in eckige Klammern, damit auch Leerzeichen und leere Zeilen sichtbar werden, und gibt am Ende den Rückgabewert null aus, mit dem readLine() das Ende signalisiert:
printLines("Unix\nWindows\r\nClassic Mac OS\rLast line without terminator");private static void printLines(String text) throws IOException {
try (BufferedReader reader = new BufferedReader(Reader.of(text))) {
String line;
while ((line = reader.readLine()) != null) {
System.out.println("[" + line + "]");
}
System.out.println("null");
}
}[Unix]
[Windows]
[Classic Mac OS]
[Last line without terminator]
nullReader.of() gibt es seit Java 24. Die Methode liefert einen Reader, der die Zeichen eines Strings (genauer: einer CharSequence) liest. Bis Java 23 brauchtest du dafür einen StringReader.
Keine der vier Zeilen enthält ein \r oder \n. Die letzte Zeile endet ohne Zeilenende, und readLine() liefert sie trotzdem vollständig.
Leere Zeilen und das Ende der Eingabe
Eine leere Zeile und das Ende der Eingabe sind für readLine() zwei verschiedene Dinge: Für eine leere Zeile liefert es einen leeren String, am Ende der Eingabe null.
printLines("first\n\nthird\n");[first]
[]
[third]
nullNach dem letzten \n kommt keine weitere, leere Zeile: Ein Zeilenende am Ende der Eingabe beendet die letzte Zeile, es beginnt keine neue. Erst zwei Zeilenenden hintereinander ergeben am Ende eine leere Zeile:
printLines("first\n\n");[first]
[]
nullBei einer leeren Eingabe liefert schon der erste readLine()-Aufruf null:
printLines("");nullDeshalb prüft eine Leseschleife das Ergebnis von readLine() auf null und nicht auf den leeren String. Eine Schleife, die stattdessen mit line.isEmpty() aufhört, endet bei der ersten leeren Zeile – und enthält die Eingabe keine, wirft isEmpty() am Ende der Eingabe eine NullPointerException, weil line dann null ist.
readLine() nur einmal pro Schleifendurchlauf
Die Schleife aus der Einleitung weist das Ergebnis von readLine() in ihrer Bedingung der Variablen line zu und prüft es dort auf null. Naheliegend wäre auch, readLine() in der Bedingung nur zu prüfen und im Schleifenkörper ein zweites Mal aufzurufen:
// falsch: liest pro Durchlauf zwei Zeilen und gibt nur die zweite aus
while (reader.readLine() != null) {
  System.out.println(reader.readLine());
}
2026-10-17 08:15:07 INFO GET /java/java-bufferedreader/ 200
2026-10-17 08:15:11 INFO GET /java/java-streams/ 200
nullDabei werden allerdings die erste, die dritte und die fünfte Zeile nur bei der Auswertung der Schleifenbedingung gelesen und dann verworfen. Nur die zweite und die vierte Zeile werden ausgegeben. Und weil die Datei eine ungerade Anzahl Zeilen hat, liefert der zweite Aufruf im letzten Durchlauf null.
Zeilen ohne Längenbegrenzung
readLine() liest, bis ein Zeilenende kommt – notfalls die ganze Eingabe. Schickt dir jemand ein Gigabyte ohne Zeilenumbruch, baut readLine() daraus einen einzigen String oder bricht mit einem OutOfMemoryError ab, wenn der Heap dafür nicht reicht.
Für Eingaben aus fremden Quellen, etwa aus dem Netzwerk, solltest du die Länge deshalb begrenzen – z. B. indem du mit read(char[], int, int) blockweise liest und nach dem Zeilenende suchst.
lines(): Zeilen als Stream
Seit Java 8 liefert lines() die Zeilen eines BufferedReader als Stream<String>. Damit stehen dir alle Operationen der Stream-API zur Verfügung. Das folgende Beispiel gibt nur die Zeilen mit einem HTTP-Request aus:
try (BufferedReader reader = Files.newBufferedReader(log)) {
  reader.lines()
      .filter(line -> line.contains(" GET "))
      .forEach(System.out::println);
}
2026-10-17 08:15:07 INFO GET /java/java-bufferedreader/ 200
2026-10-17 08:15:09 WARN GET /java/bufferedreader/ 404
2026-10-17 08:15:11 INFO GET /java/java-streams/ 200Der Stream liest die Datei nicht beim Aufruf von lines(), sondern erst während der terminalen Operation, hier forEach(). Die Datei muss also bis dahin offen sein – deshalb steht die ganze Pipeline innerhalb des Try-with-resources.
Das zweite Beispiel zählt die Zeilen pro Log-Level. Den Log-Level schneidet substring(20, 25) aus jeder Zeile heraus, und strip() entfernt die Leerzeichen, mit denen er aufgefüllt ist. Collectors.groupingBy() gruppiert die Zeilen nach diesem Wert und zählt sie, die TreeMap sortiert die Log-Level alphabetisch:
try (BufferedReader reader = Files.newBufferedReader(log)) {
  Map<String, Long> linesPerLevel =
      reader.lines()
          .collect(groupingBy(
              line -> line.substring(20, 25).strip(),
              TreeMap::new,
              counting()));
  System.out.println(linesPerLevel);
}
{ERROR=1, INFO=3, WARN=1}Die Methoden von Stream deklarieren keine checked Exceptions. Tritt beim Lesen eine IOException auf, verpackt der Stream sie deshalb in eine UncheckedIOException. Das zeigt das folgende Beispiel mit der ISO-8859-1-Datei aus dem Abschnitt Wenn die Zeichenkodierung nicht passt:
try (BufferedReader reader = Files.newBufferedReader(latin1)) {
  long count = reader.lines().count();
  System.out.println(count + " lines");
} catch (UncheckedIOException e) {
  System.out.println(e + "\n  caused by " + e.getCause());
}
java.io.UncheckedIOException: java.nio.charset.MalformedInputException: Input length = 1
caused by java.nio.charset.MalformedInputException: Input length = 1Eine Einschränkung nennt das Javadoc von lines(): Nach der terminalen Operation steht der Reader an keiner festgelegten Position. Du kannst also nicht die ersten Zeilen per Stream verarbeiten und danach mit readLine() weiterlesen.
Brauchst du von einer Datei nur den Stream ihrer Zeilen, geht es auch ohne eigenen BufferedReader: Files.lines(path) öffnet die Datei und liefert direkt den Stream. In das Try-with-resources gehört dann statt des Readers der Stream, denn er hält die Datei offen, bis er geschlossen wird. Das erste Beispiel dieses Abschnitts sieht damit so aus:
try (Stream<String> lines = Files.lines(log)) {
  lines.filter(line -> line.contains(" GET "))
      .forEach(System.out::println);
}
2026-10-17 08:15:07 INFO GET /java/java-bufferedreader/ 200
2026-10-17 08:15:09 WARN GET /java/bufferedreader/ 404
2026-10-17 08:15:11 INFO GET /java/java-streams/ 200Verarbeitest du die Zeilen mit einem parallelen Stream, hat Files.lines() übrigens einen zweiten Vorteil: Eine UTF-8-Datei auf dem Standard-Dateisystem, die höchstens Integer.MAX_VALUE Bytes groß ist, halbiert es für die Threads selbst, während sich BufferedReader.lines() nur in wachsenden Blöcken aufteilen lässt. Wie sich das auf die Laufzeit auswirkt, zeigt der Artikel über parallele Streams.
Alles auf einmal lesen: readAllLines() und readAllAsString()
Seit Java 25 hat jeder Reader zwei Methoden, die den Rest der Eingabe auf einmal lesen: readAllLines() liefert die Zeilen als unveränderliche List<String>, readAllAsString() den Text als einen einzigen String, einschließlich aller Zeilenenden.
try (BufferedReader reader = Files.newBufferedReader(log)) {
  List<String> lines = reader.readAllLines();
  System.out.println(lines.size() + " lines");
}

try (BufferedReader reader = Files.newBufferedReader(log)) {
  String content = reader.readAllAsString();
  System.out.println(content.length() + " characters");
}
5 lines
276 charactersFür eine Datei sind Files.readAllLines(path) (seit Java 8) und Files.readString(path) (seit Java 11) kürzer; beide zeigt der Artikel über das Lesen von Dateien.
Die neuen Methoden, also readAllLines() und readAllAsString(), haben aber zwei Vorteile: Sie funktionieren mit jedem Reader, also auch mit einem InputStreamReader um einen Netzwerk-Stream. Und sie lesen nur den Rest – du kannst also erst einzelne Zeilen mit readLine() lesen und dann den Rest auf einmal:
try (BufferedReader reader = Files.newBufferedReader(log)) {
  String first = reader.readLine();
  List<String> rest = reader.readAllLines();
  System.out.println("First line: " + first);
  System.out.println("Remaining:  " + rest.size() + " lines");
}
First line: 2026-10-17 08:15:02 INFO Server started on port 8080
Remaining: 4 linesBeide Methoden halten den ganzen Rest der Eingabe im Speicher. Das Javadoc rät deshalb davon ab, sie für Eingaben unbekannter Herkunft zu verwenden: Eine riesige Eingabe belegt entsprechend viel Speicher.
Zeichenweise lesen: read() und read(char[], int, int)
Wie jeder Reader hat auch der BufferedReader Methoden, um einzelne Zeichen zu lesen. read() liefert das nächste Zeichen als int und am Ende der Eingabe -1. Der Rückgabetyp ist int und nicht char, damit -1 sich von jedem Zeichen unterscheidet.
Das folgende Beispiel zählt die Ziffern in der Log-Datei:
try (BufferedReader reader = Files.newBufferedReader(log)) {
  int digits = 0;
  int c;
  while ((c = reader.read()) != -1) {
    if (Character.isDigit(c)) {
      digits++;
    }
  }
  System.out.println(digits + " digits");
}
83 digitsread(char[] cbuf, int off, int len) liest bis zu len Zeichen in das Array cbuf, ab Position off, und liefert die Anzahl der gelesenen Zeichen – am Ende der Eingabe wieder -1. Das folgende Beispiel liest die Datei in Blöcken von 100 Zeichen:
try (BufferedReader reader = Files.newBufferedReader(log)) {
  char[] buffer = new char[100];
  int calls = 0;
  int total = 0;
  int n;
  while ((n = reader.read(buffer, 0, buffer.length)) != -1) {
    calls++;
    total += n;
  }
  System.out.println(total + " characters in " + calls + " calls");
}
276 characters in 3 callsDie 276 Zeichen kommen in drei Blöcken an: 100, 100 und 76 Zeichen. Wie viele Zeichen ein Aufruf liefert, ist allerdings nicht garantiert – er darf auch weniger liefern, als ins Array passen, ohne dass die Eingabe zu Ende ist. Verlass dich also immer auf den Rückgabewert, nie auf die Länge des Arrays.
Vorauslesen und überspringen: mark(), reset(), skip() und ready()
Die folgenden vier Methoden brauchst du seltener als readLine(). Bei ready() lohnt sich der Blick trotzdem, denn ihr Name verspricht mehr, als die Methode hält.
mark() und reset()
Mit mark() merkst du dir eine Position im Reader, mit reset() springst du dorthin zurück. So kannst du vorauslesen und die gelesenen Zeichen danach erneut lesen.
Betrachten wir als Beispiel eine Datei, die mit einer Kopfzeile beginnen kann, die mit # anfängt. Die Methode printData() liest die erste Zeile. Ist sie eine Kopfzeile, gibt die Methode sie als solche aus; andernfalls springt sie mit reset() zurück, und die Zeile wird als erste Datenzeile erneut gelesen:
private static void printData(Reader source) throws IOException {
  try (BufferedReader reader = new BufferedReader(source)) {
    reader.mark(1_000);
    String first = reader.readLine();
    if (first != null && first.startsWith("#")) {
      System.out.println("Header: " + first);
    } else {
      reader.reset();
    }

    String line;
    while ((line = reader.readLine()) != null) {
      System.out.println("Data:   " + line);
    }
  }
}
Die Methode rufen wir mit und ohne Kopfzeile auf:
printData(Reader.of("# exported 2026-10-17\nAda Lovelace\nAlan Turing\n"));
printData(Reader.of("Ada Lovelace\nAlan Turing\n"));
Header: # exported 2026-10-17
Data: Ada Lovelace
Data: Alan Turing
Data: Ada Lovelace
Data: Alan TuringDas Argument von mark() ist das Read-Ahead-Limit: die Anzahl Zeichen, die du nach mark() lesen darfst, ohne dass die Markierung verloren geht. Liest du mehr, kann reset() mit einer IOException und der Meldung „Mark invalid“ scheitern – sicher ist das, sobald der BufferedReader nach dem Überschreiten des Limits seinen Puffer nachladen musste.
Ist das Read-Ahead-Limit größer als der Puffer, legt der BufferedReader beim nächsten Nachladen einen neuen Puffer in der Größe des Limits an – ein Limit von einer Million Zeichen belegt also 2 MB, denn ein char ist zwei Bytes groß.
Wähle das Limit deshalb so groß wie die längste Zeile, die du zurücknehmen willst, und nicht größer. Die 1.000 Zeichen im Beispiel decken jede realistische Kopfzeile ab.
skip()
skip(n) überspringt bis zu n Zeichen und liefert, wie viele es tatsächlich waren. Im folgenden Beispiel überspringt es Datum und Uhrzeit einer Log-Zeile, die zusammen mit den Leerzeichen 20 Zeichen lang sind:
try (BufferedReader reader =
    new BufferedReader(Reader.of("2026-10-17 08:15:02 INFO  Started"))) {
  long skipped = reader.skip(20);
  System.out.println("Skipped " + skipped + " characters: " + reader.readLine());
}
Skipped 20 characters: INFO Startedready()
ready() liefert true, wenn der nächste Lesezugriff garantiert nicht auf Eingaben wartet – also wenn der Puffer noch Zeichen enthält oder der darunterliegende Reader sofort Zeichen liefern kann. Der Name verleitet dazu, ready() als „es kommen noch Daten“ zu lesen. Das stimmt nicht: false heißt nur, dass in diesem Moment keine Zeichen bereitliegen.
Das zeigt das folgende Beispiel. Ein virtueller Thread schreibt nach einer halben Sekunde eine Zeile in eine Pipe, der BufferedReader liest am anderen Ende:
PipedWriter writer = new PipedWriter();
try (BufferedReader reader = new BufferedReader(new PipedReader(writer))) {
  Thread producer = Thread.startVirtualThread(() -> {
    try (writer) {
      Thread.sleep(500);
      writer.write("Hello\n");
    } catch (IOException e) {
      throw new UncheckedIOException(e);
    } catch (InterruptedException _) {
      Thread.currentThread().interrupt();
    }
  });

  System.out.println("ready():    " + reader.ready());
  System.out.println("readLine(): " + reader.readLine());
  System.out.println("readLine(): " + reader.readLine());
  producer.join();
}
ready(): false
readLine(): Hello
readLine(): nullready() liefert false, weil die Zeile noch nicht geschrieben ist. Der erste readLine()-Aufruf wartet trotzdem auf sie und liefert „Hello“. Erst der zweite liefert null, denn inzwischen hat der Thread die Pipe geschlossen.
Bei Dateien liefert ready() true, solange in der Datei noch ungelesene Bytes stehen. Bei Netzwerk-Streams, Pipes und der Konsole liefert es dagegen false, sobald die Daten langsamer kommen, als du sie liest. Eine Schleife while (reader.ready()) hört dann mitten in der Eingabe auf. Das Ende der Eingabe erkennst du ausschließlich am Rückgabewert null von readLine() bzw. -1 von read().
Von der Konsole lesen
Die Konsole liefert ihre Eingaben über den InputStream System.in. Um daraus Zeilen zu lesen, gibt es zwei Wege: einen BufferedReader und, seit Java 25, die Methode IO.readln().
BufferedReader um System.in
Wie bei jedem InputStream setzt du zwischen System.in und den BufferedReader einen InputStreamReader. Welche Kodierung die Konsole verwendet, steht seit Java 25 in der System-Property stdin.encoding; das Javadoc von System.in empfiehlt, sie an den InputStreamReader zu übergeben.
Das folgende Programm liest Zeilen, bis du eine leere Zeile eingibst oder die Eingabe mit Strg+D (unter Windows Strg+Z und Enter) beendest:
// kein Try-with-resources: es würde System.in schließen
BufferedReader in = new BufferedReader(
    new InputStreamReader(System.in, System.getProperty("stdin.encoding")));

System.out.println("Enter lines, finish with an empty line:");
String line;
while ((line = in.readLine()) != null && !line.isEmpty()) {
  System.out.println("You entered: " + line);
}
In einem Terminal sieht eine Sitzung mit zwei Eingaben und einer abschließenden leeren Zeile so aus:
Enter lines, finish with an empty line:
Hello
You entered: Hello
BufferedReader
You entered: BufferedReader
Beachte die Bedingung der Schleife: Sie prüft zuerst auf null und dann auf die leere Zeile. Beendest du die Eingabe mit Strg+D, liefert readLine() null, und line.isEmpty() würde eine NullPointerException werfen.
Den BufferedReader legst du einmal an und verwendest ihn für alle Eingaben. Er liest nämlich mehr von System.in, als er mit einer Zeile zurückgibt – bei einer nach System.in umgeleiteten Datei bis zu 8.192 Zeichen. Ein zweiter BufferedReader um System.in würde diese Zeichen nicht mehr lesen. Das Javadoc von System.in sagt deshalb: Sobald du System.in in einen Reader verpackt hast, lies nur noch über diesen Reader.
Für interaktive Programme verweist dasselbe Javadoc übrigens auf die Klasse Console, die z. B. Passwörter einlesen kann, ohne dass die getippten Zeichen auf dem Bildschirm erscheinen.
IO.readln()
Seit Java 25 gibt es die Klasse IO im Paket java.lang (JEP 512, mehr dazu im Artikel über die Java 25 Features). Ihre Methode readln() gibt einen Prompt aus und liest eine Zeile:
String name = IO.readln("Your name: ");
IO.println("Hello, " + name + "!");
Your name: Ada
Hello, Ada!IO.readln() ist selbst mit einem BufferedReader implementiert: Beim ersten Aufruf legt die Klasse einen BufferedReader um einen InputStreamReader um System.in an, mit der Kodierung aus stdin.encoding, und verwendet ihn für alle weiteren Aufrufe. Es gilt also dieselbe Regel wie oben – nach dem ersten IO.readln() darfst du nur noch über IO.readln() lesen, nicht mehr über einen eigenen Reader um System.in.
Für kleine Programme und Übungsaufgaben empfehle ich IO.readln(). Ein BufferedReader lohnt sich, wo du die Eingabe als Ganzes verarbeitest, z. B. mit lines() oder bis zum Ende der Eingabe – denn IO.readln() liefert zwar am Ende der Eingabe ebenfalls null, hat aber keine Methode, die alle Zeilen auf einmal liefert.
Wie schnell ist der BufferedReader?
Wie viel der Puffer bringt und welche Lesemethode am schnellsten ist, habe ich mit dem Java Microbenchmark Harness (JMH) gemessen, dem Microbenchmark-Werkzeug des OpenJDK-Projekts. Jede Methode liest eine Textdatei von 100.000.000 Bytes vollständig: UTF-8, 1.222.747 Zeilen mit 0 bis 160 Zeichen, im Mittel 80, und im Mittel ist jedes hundertste Zeichen ein Umlaut.
Das folgende Diagramm zeigt, wie lange jede Methode für die ganze Datei braucht, in Millisekunden. Blau sind die Methoden des BufferedReader, grau die beiden Reader ohne BufferedReader und zum Vergleich Scanner.nextLine().
Alle BufferedReader-Methoden laufen auf einem new BufferedReader(new FileReader(…)), außer in der Zeile „Files.newBufferedReader() + readLine()“:
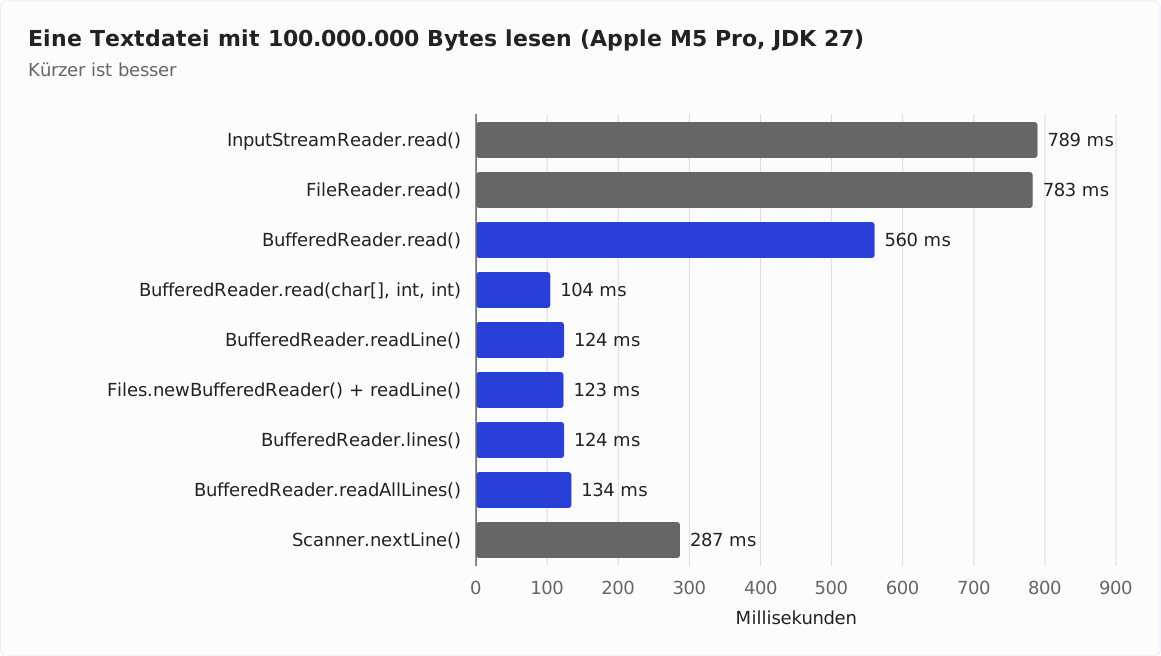
Ohne BufferedReader braucht das zeichenweise Lesen mit FileReader.read() 783 ms. InputStreamReader.read() liegt mit 789 ms gleichauf, denn FileReader ist eine Unterklasse von InputStreamReader.
Mit BufferedReader.read() sind es 560 ms – FileReader.read() ist also 40 % langsamer. Der BufferedReader spart hier das Dekodieren von höchstens zwei Zeichen pro Aufruf, das der Abschnitt Was ist ein BufferedReader? beschreibt. Was bleibt, ist ein read()-Aufruf pro Zeichen, und jeder dieser Aufrufe betritt einen synchronized-Block.
Bei der Testdatei sind das 99.024.162 Aufrufe. Die Datei hat 975.838 Zeichen weniger als Bytes, denn sie enthält 975.838 Umlaute, und jeder davon belegt in UTF-8 zwei Bytes.
Die Zahl der Aufrufe ist der Hebel: BufferedReader.read(char[], int, int) mit einem Array von 8.192 Zeichen holt dieselben 99.024.162 Zeichen mit 12.088 Aufrufen und braucht dafür 104 ms. BufferedReader.read() braucht mehr als fünfmal so lange.
Bei read(char[], int, int) kopiert der BufferedReader übrigens nichts in seinen eigenen Puffer: Ist das übergebene Array mindestens so groß wie der Puffer, reicht er den Aufruf direkt an den InputStreamReader durch.
readLine() braucht 124 ms und ist damit 19 % langsamer als read(char[], int, int), denn es sucht in jeder Zeile nach dem Zeilenende und legt für jede der 1.222.747 Zeilen einen String an. Dafür bekommst du die Zeilen fertig zerlegt.
Die übrigen zeilenweisen Varianten liegen nah beieinander:
- Der Reader aus
Files.newBufferedReader()liest mitreadLine()in 123 ms – sein strenger Decoder, der bei ungültigen Bytes eine Exception wirft, kostet nichts Messbares. lines()braucht 124 ms, so lange wie diereadLine()-Schleife.readAllLines()braucht 134 ms und ist damit 8 % langsamer als diereadLine()-Schleife; es legt zusätzlich alle 1.222.747 Strings in einer Liste ab und hält sie gleichzeitig im Speicher.
Scanner.nextLine() braucht mit 287 ms mehr als doppelt so lange wie readLine(). Der Scanner sucht das Zeilenende mit einem regulären Ausdruck statt mit einem Zeichenvergleich; was ihn sonst vom BufferedReader unterscheidet, zeigt der Abschnitt BufferedReader vs. Scanner.
Die Puffergröße
Bringt ein größerer Puffer als die standardmäßigen 8.192 Zeichen mehr Tempo? Die folgende Tabelle zeigt, wie lange die readLine()-Schleife mit verschiedenen Puffergrößen braucht:
| Puffergröße (Zeichen) | readLine() |
|---|---|
| 256 | 101 ms |
| 1.024 | 87 ms |
| 8.192 (Standard) | 122 ms |
| 65.536 | 121 ms |
| 1.048.576 | 121 ms |
Ab 8.192 Zeichen ändert ein größerer Puffer nichts mehr, denn die Zahl der Dateizugriffe hängt nicht an ihm: Der InputStreamReader darunter liest die Datei bei jeder Puffergröße mit denselben 12.208 Lesezugriffen von je bis zu 8.192 Bytes. Das zeigt ein zählender InputStream zwischen Datei und InputStreamReader.
Auffällig ist die andere Richtung: Mit 1.024 Zeichen braucht readLine() nur 87 ms. Die Ursache ist aber nicht der kleinere Puffer, sondern der JIT-Compiler. Er übersetzt die Schleife, die UTF-8-Bytes in Zeichen umwandelt, anhand des Profils, das die JVM beim Aufwärmen über diese Schleife sammelt. Das zeigt eine Gegenprobe: Ein Programm wärmt die JVM mit Blöcken einer Größe auf und misst danach mit Blöcken einer anderen Größe, wie lange der InputStreamReader allein für das Dekodieren der Datei braucht – je Kombination in einer eigenen JVM:
utf8, warm-up blocks 1,024, measured blocks 1,024: 46.8 ms (checksum 10)
utf8, warm-up blocks 8,192, measured blocks 8,192: 83.5 ms (checksum 40)
utf8, warm-up blocks 1,024, measured blocks 8,192: 55.6 ms (checksum 525)
utf8, warm-up blocks 8,192, measured blocks 1,024: 92.1 ms (checksum 525)
ascii, warm-up blocks 1,024, measured blocks 1,024: 13.8 ms (checksum 590)
ascii, warm-up blocks 8,192, measured blocks 8,192: 13.1 ms (checksum 440)
Schnell ist das Dekodieren immer dann, wenn die JVM mit 1.024er-Blöcken aufgewärmt wurde – auch wenn sie danach 8.192er-Blöcke dekodiert. Langsam ist es nach dem Aufwärmen mit 8.192er-Blöcken, auch bei 1.024er-Blöcken. Die Blockgröße beim Messen spielt also keine Rolle.
Die beiden letzten Zeilen lesen eine Kopie der Datei, in der jeder Umlaut durch ein x ersetzt ist. Bei reinem ASCII-Text gibt es den Unterschied nicht. Das passt zum Aufbau des UTF-8-Decoders: Er wandelt ASCII-Zeichen am Anfang jedes Aufrufs mit einer eigens optimierten Methode um und fällt ab dem ersten Nicht-ASCII-Zeichen in eine Schleife zurück, die Byte für Byte arbeitet. Wie schnell der Maschinencode dieser Schleife ist, hängt vom beim Aufwärmen gesammelten Profil ab.
Damit erklärt sich auch die Tabelle oben: JMH misst jede Puffergröße in eigenen JVMs und wärmt jede davon mit derselben Puffergröße auf, mit der es anschließend misst. Ein BufferedReader mit 1.024 Zeichen Puffer lässt den Decoder in Blöcken von 1.024 Zeichen arbeiten, also sammelt seine JVM beim Aufwärmen das Profil, aus dem der schnelle Code entsteht. Mit 8.192 Zeichen Puffer entsteht der langsame Code. Daher die 87 gegen 122 ms in der Tabelle.
In einer echten Anwendung, die Reader verschiedener Größe und Herkunft verwendet, sammelt die JVM ein gemischtes Profil – mit welcher Puffergröße dein Programm dann schneller wäre, lässt sich nicht vorhersagen. Ich empfehle deshalb, die Standardgröße von 8.192 Zeichen beizubehalten.
BufferedReader vs. Scanner
Auch die Klasse Scanner liest Zeilen, mit hasNextLine() und nextLine(). Gebaut ist sie aber für etwas anderes: Sie zerlegt Text in Tokens und wandelt diese in Zahlen und andere Typen um.
Betrachten wir als Beispiel die erste Zeile der Log-Datei. Damit beide Klassen denselben Text zerlegen, steht sie in den folgenden zwei Listings als String line im Code. Scanner zerlegt sie mit next() an den Leerzeichen und liefert den Rest der Zeile mit nextLine():
String line = "2026-10-17 08:15:02 INFO  Server started on port 8080";

try (Scanner scanner = new Scanner(line)) {
  String date = scanner.next();
  String time = scanner.next();
  String level = scanner.next();
  String message = scanner.nextLine().strip();
  System.out.println(date + " | " + time + " | " + level + " | " + message);
}
2026-10-17 | 08:15:02 | INFO | Server started on port 8080Ein BufferedReader zerlegt Zeilen nicht; readLine() liefert die ganze Zeile als String – so wie line im Beispiel. Diesen String zerlegst du mit String.split(). Das zweite Argument begrenzt das Ergebnis auf vier Teile, damit die Nachricht in einem Stück bleibt:
String[] parts = line.split("\\s+", 4);
System.out.println(String.join(" | ", parts));
2026-10-17 | 08:15:02 | INFO | Server started on port 8080Einen weiteren Unterschied zeigt ein Lesefehler. Das folgende Beispiel verwendet einen Reader, der beim ersten Lesezugriff eine IOException wirft – so, wie es ein Netzlaufwerk tut, das mitten im Lesen verschwindet. Der BufferedReader reicht die Exception an den Aufrufer weiter:
try (BufferedReader reader = new BufferedReader(new FailingReader())) {
  System.out.println(reader.readLine());
} catch (IOException e) {
  System.out.println("Caught: " + e);
}
Caught: java.io.IOException: Simulated read errorDer Scanner dagegen fängt dieselbe Exception ab und meldet, dass keine Zeile mehr kommt. Erst die Methode ioException() verrät, dass etwas schiefgegangen ist:
try (Scanner scanner = new Scanner(new FailingReader())) {
  System.out.println("hasNextLine(): " + scanner.hasNextLine());
  System.out.println("ioException(): " + scanner.ioException());
}
hasNextLine(): false
ioException(): java.io.IOException: Simulated read errorEin Programm, das ioException() nicht abfragt, verarbeitet also eine abgebrochene Datei, als wäre sie vollständig.
Die folgende Tabelle stellt die beiden Klassen gegenüber:
BufferedReader | Scanner | |
|---|---|---|
| Zweck | Zeichen und Zeilen lesen | Text in Tokens zerlegen und umwandeln |
| Puffer | 8.192 Zeichen | anfangs 1.024 Zeichen (verdoppelt sich, wenn ein Token oder eine Zeile nicht hineinpasst) |
| Zeilenende finden | Vergleich mit \n und \r | regulärer Ausdruck |
| Zahlen lesen | nicht direkt (z. B. Integer.parseInt() auf einem Teil der Zeile) | nextInt(), nextDouble() usw. |
IOException | wird geworfen | wird abgefangen, abrufbar mit ioException() |
| Thread-sicher | ja (Methoden synchronisiert) | nein |
| Testdatei zeilenweise lesen | 124 ms (readLine()) | 287 ms (nextLine()) |
Meine Empfehlung: Lies Dateien und andere Eingaben, die Zeile für Zeile verarbeitet werden, mit einem BufferedReader. Den Scanner nimm dort, wo du gemischte Eingaben aus Wörtern und Zahlen zerlegst – z. B. bei Übungsaufgaben, die Zahlen von der Konsole lesen.
Einen BufferedReader schließen
Ein BufferedReader hält, über den Reader darunter, eine Datei oder eine Netzwerkverbindung offen. Er muss deshalb geschlossen werden, am besten mit Try-with-resources.
Dabei reicht es, den äußersten Reader zu schließen. close() schließt den Reader, den der BufferedReader umhüllt, und der schließt wiederum seinen InputStream. Das zeigt das folgende Beispiel mit einem Reader, der beim Schließen eine Meldung ausgibt:
try (BufferedReader reader =
    new BufferedReader(new ClosingReporter(Reader.of("Hello\n")))) {
  System.out.println(reader.readLine());
}
System.out.println("After the try block");
Hello
Inner reader closed
After the try blockClosingReporter ist ein FilterReader aus dem Demo-Repository, der in close() die Meldung ausgibt und dann den umhüllten Reader schließt.
Die Ausnahme ist System.in. Schließt du einen BufferedReader um System.in, ist System.in geschlossen, und kein Teil des Programms kann danach noch von der Konsole lesen. Deshalb steht der Reader im Abschnitt BufferedReader um System.in nicht in einem Try-with-resources.
Häufige Fehler
Die folgenden Fehler zeigen die Abschnitte oben jeweils ausführlich:
readLine()steht zweimal in der Schleife. Jede zweite Zeile geht verloren, und am Ende kommt einnullan – die richtige Form zeigt der AbschnittreadLine()nur einmal pro Schleifendurchlauf.- Die Schleife hört bei der ersten leeren Zeile auf. Das Ende der Eingabe meldet
readLine()mitnull, nicht mit einem leeren String. ready()steuert die Schleife. Bei Netzwerk-Streams, Pipes und der Konsole bricht sie mitten in der Eingabe ab, dennready()sagt nur, ob jetzt gerade Zeichen bereitliegen.- Der
InputStreamReaderbekommt keine Kodierung. Er dekodiert dann als UTF-8, auch wenn die Bytes aus dem Netzwerk oder einem Archiv anders kodiert sind. - Eine Zeile aus fremder Quelle ist beliebig lang.
readLine()liest bis zum nächsten Zeilenende, notfalls bis der Speicher voll ist. - Ein Try-with-resources schließt
System.in. Danach kann kein Teil des Programms mehr von der Konsole lesen.
Zusammenfassung
Ein BufferedReader umhüllt einen anderen Reader, liest von ihm Blöcke von bis zu 8.192 Zeichen und bedient read() und readLine() aus diesem Puffer. Er ist der Standardweg, um Text Zeile für Zeile zu lesen, ohne ihn komplett in den Speicher laden zu müssen.
readLine() erkennt \n, \r\n und \r als Zeilenende und liefert am Ende der Eingabe null, für eine leere Zeile dagegen einen leeren String. lines() liefert die Zeilen als Stream und verpackt eine IOException in eine UncheckedIOException.
In der Messung liest die readLine()-Schleife eine Textdatei von 100 MB in 124 ms; Zeichen für Zeichen ohne BufferedReader dauert es 783 ms. Ein Puffer über den standardmäßigen 8.192 Zeichen bringt nichts.
Seit Java 25 lesen readAllLines() und readAllAsString() den Rest der Eingabe auf einmal, und IO.readln() liest Zeilen von der Konsole – über einen BufferedReader, den die Klasse IO intern anlegt.
ready() sagt nur, ob der nächste Lesezugriff sofort Zeichen liefert. Liefert es false, können trotzdem noch Zeichen kommen – etwa über einen Netzwerk-Stream, auf dem die nächsten Daten noch unterwegs sind. Das Ende der Eingabe erkennst du nur an null von readLine() bzw. -1 von read().
Scanner liest ebenfalls Zeilen, fängt aber IOExceptions ab und ist für das Zerlegen in Tokens gebaut.
Meine Empfehlungen:
- Erzeuge den
BufferedReaderfür Dateien mitFiles.newBufferedReader(). Er meldet eine falsche Kodierung mit einerMalformedInputException, statt Ersatzzeichen zu liefern. - Lies mit der Schleife
while ((line = reader.readLine()) != null)oder mitlines()– und nie mitready()als Schleifenbedingung. - Gib beim
InputStreamReaderdie Kodierung immer an, beiSystem.indie ausstdin.encoding. - Schließe den
BufferedReadermit Try-with-resources, außer er umhülltSystem.in. - Behalte die Standard-Puffergröße von 8.192 Zeichen bei.
- Nimm
Scannernur dort, wo du Wörter und Zahlen aus derselben Eingabe zerlegst.
Wie du Dateien in einem Rutsch in einen String, eine Liste oder ein Byte-Array liest, zeigt der Artikel über das Lesen von Dateien aus derselben Serie.
Hat dieser Artikel deine Fragen beantwortet? Dann freue ich mich über eine Bewertung auf meinem ProvenExpert-Profil – sie hilft anderen Entwickler:innen, diese Inhalte zu finden.