Sortieralgorithmen sind Thema jeder Informatik-Ausbildung. Viele von uns haben irgendwann einmal die genaue Funktionsweise von Insertion Sort bis Merge- und Quicksort auswendig lernen müssen, einschließlich ihrer Zeitkomplexitäten im best, average und worst case in Big-O-Notation … um nach der Prüfung das meiste davon wieder zu vergessen ;-)
Wenn du eine Auffrischung brauchst, wie die gebräuchlichsten Sortieralgorithmen funktionieren und wie sie sich unterscheiden, ist diese Artikelserie genau das Richtige für dich.
Dieser erste Artikel behandelt folgende Fragen:
- Welches sind die gebräuchlichsten Sortierverfahren?
- In welchen Eigenschaften unterscheiden sie sich?
- Wie ist das Laufzeitverhalten der einzelnen Sortiermethoden (Platz- und Zeitkomplexität)?
Möchtest du wissen, wie ein bestimmter Sortieralgorithmus genau funktioniert? Jedes aufgelistete Sortierverfahren linkt zu einem vertiefenden Artikel, der …
- die Funktionsweise des jeweiligen Verfahrens anhand eines Beispiels erklärt,
- die Zeitkomplexität herleitet (auf anschauliche Weise, ohne komplizierte mathematische Beweise),
- zeigt, wie man den jeweiligen Sortieralgorithmus in Java implementiert, und
- die Performance der Java-Implementierung misst und mit dem theoretischen Laufzeitverhalten abgleicht.
Die Quellcodes der gesamten Artikelserie findest du in meinem GitHub-Repository.
Eigenschaften von Sortieralgorithmen
Sortierverfahren unterscheiden sich hauptsächlich in den folgenden Eigenschaften (Erklärungen findest du in den folgenden Abschnitten):
- Geschwindigkeit (oder besser: Zeitkomplexität)
- Platzkomplexität
- Stabilität
- Vergleichsbasiert / nicht-vergleichsbasiert
- Parallelisierbarkeit
- Rekursiv / nicht-rekursiv
- Adaptivität
Du kannst die Erklärungen auch erst einmal überspringen und später hierher zurückkehren. Hier geht es direkt zu den wichtigsten Sortieralgorithmen.
Zeitkomplexität von Sortieralgorithmen
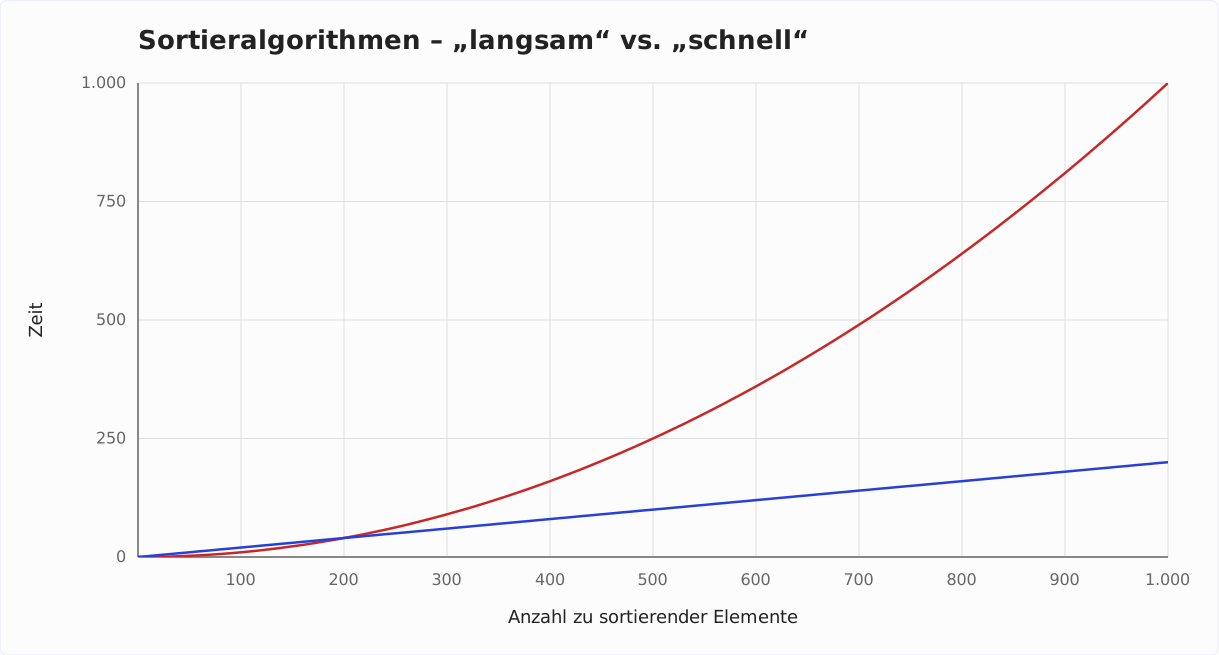
Das wichtigste Kriterium bei der Auswahl eines Sortierverfahrens ist in den meisten Fällen seine Geschwindigkeit. Interessant ist hierbei in erster Linie, wie sich die Geschwindigkeit in Abhängigkeit von der Anzahl der zu sortierenden Elemente ändert.
Denn ein Algorithmus (im Diagramm die rote Kurve) kann bei hundert Elementen doppelt so schnell sein wie ein anderer (die blaue Kurve), bei tausend Elementen aber durchaus fünfmal langsamer (oder noch viel, viel langsamer; aber das ließ sich nicht mehr gut in dem Diagramm abbilden):
Deshalb gibt man die Laufzeit eines Algorithmus im Allgemeinen als Zeitkomplexität in der sogenannten „O-Notation“ (englisch: „Big O notation“) an.
Die folgenden Klassen von Zeitkomplexitäten sind für Sortieralgorithmen relevant (detailliertere Beschreibungen dieser Komplexitätsklassen findest du in dem jeweils verlinkten Artikel):
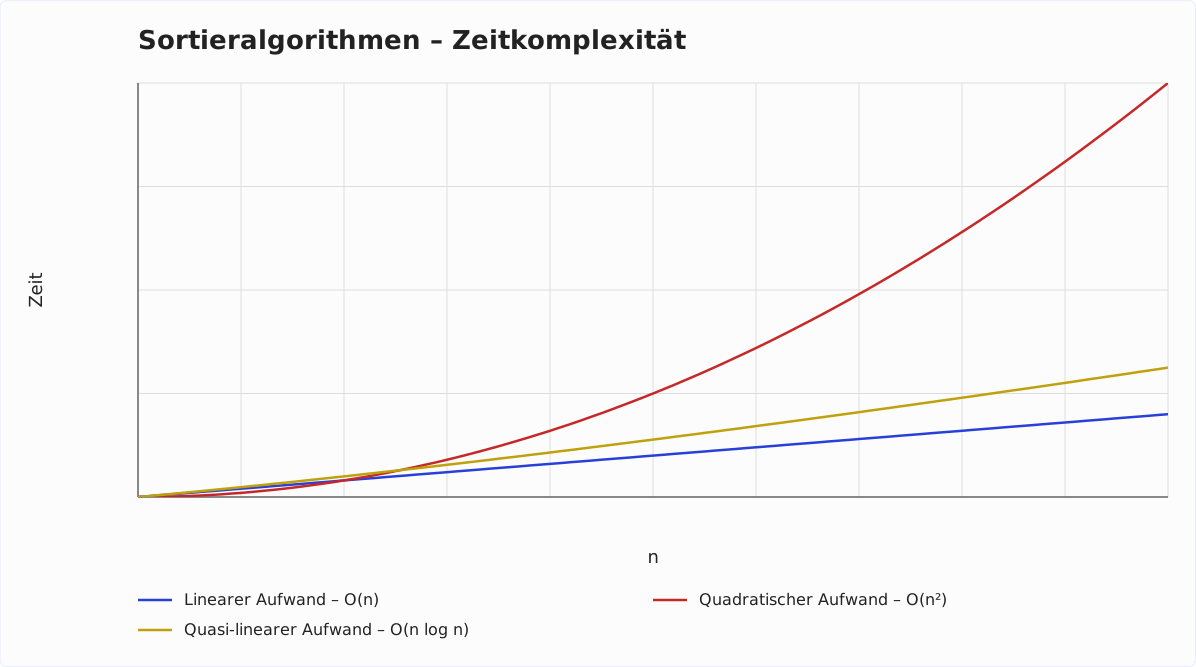
- O(n) (ausgesprochen „O von n“): linearer Aufwand – für doppelt so viele Elemente benötigt das Sortierverfahren doppelt so lange;
- O(n log n) (ausgesprochen „O von n log n“): quasi-linearer Aufwand – fast so gut wie linearer Aufwand;
- O(n²) (ausgesprochen „O von n Quadrat“): quadratischer Aufwand – für doppelt so viele Elemente benötigt das Sortierverfahren viermal so lange, für 10× so viele Elemente 100× so lange, für 1.000× so viele Elemente 1.000.000× so lange, usw.
Hier noch einmal das Diagramm von oben mit der Angabe der Zeitkomplexitäten und einer zusätzlichen Kurve für quasi-linearen Aufwand. Da die Zeitkomplexität keine Aussage über die absolut benötigten Zeiten macht, sind die Achsen hier nicht mehr mit Werten beschriftet.
Bei quadratischer Komplexität stößt man schnell an die Leistungsgrenzen heutiger Hardware:
Während Quicksort auf einem Apple M5 Pro (Stand 2026) eine Milliarde Elemente in 72 Sekunden sortiert, braucht Insertion Sort schon für 524.288 Elemente 12 Sekunden. Hochgerechnet sind das etwa 44 Sekunden für eine Million Elemente – und für eine Milliarde Elemente beeindruckende 44 Millionen Sekunden, also ein Jahr und fünf Monate.
Quadratische Komplexität sollte also, wenn möglich, vermieden werden.
Platzkomplexität von Sortieralgorithmen
Nicht nur Zeitkomplexität ist für Sortierverfahren relevant, sondern auch die Platzkomplexität. Diese gibt an, wie viel zusätzlichen Speicherplatz der Algorithmus in Abhängigkeit von der Anzahl der zu sortierenden Elemente benötigt. Damit ist nicht der Speicherplatz gemeint, der für die zu sortierenden Elemente selbst benötigt wird, sondern darüber hinaus benötigter Platz für z. B. Hilfsvariablen, Schleifenzähler und temporäre Arrays.
Platzkomplexität wird mit den gleichen Klassen angegeben wie Zeitkomplexität. Hier treffen wir noch auf eine weitere Klasse:
- O(1) (ausgesprochen „O von 1“): konstanter Aufwand – bei vielen Sortieralgorithmen ist der zusätzliche Speicherbedarf unabhängig von der Anzahl der zu sortierenden Elemente.
Stabile und nicht-stabile Sortierverfahren
Bei stabilen Sortierverfahren wird die relative Reihenfolge von Elementen, die den gleichen Sortierschlüssel haben, beibehalten. Bei nicht-stabilen Sortierverfahren wird dies nicht garantiert: Die relative Reihenfolge kann beibehalten werden, muss es aber nicht.
Was bedeutet das?
Im folgenden Beispiel haben wir eine zufällig erzeugte Namensliste. Die Liste ist zunächst nach Vornamen sortiert:
| Nach Vornamen sortiert |
|---|
| Annika Weigert |
| Fabio Müller |
| Gertrud Selig |
| Jonathan Heinemann |
| Mathias Müller |
| Waltraud Birke |
Diese Liste soll nun – ohne die Vornamen zu betrachten – nach Nachnamen sortiert werden. Wenn wir dafür ein stabiles Sortierverfahren anwenden, ist das Ergebnis immer:
| Stabil nach Nachnamen sortiert |
|---|
| Waltraud Birke |
| Jonathan Heinemann |
| Fabio Müller |
| Mathias Müller |
| Gertrud Selig |
| Annika Weigert |
D. h., die Reihenfolge von Fabio und Mathias bleibt bei einem stabilen Sortierverfahren immer unverändert. Bei einem nicht-stabilen Sortierverfahren kann auch das folgende Sortierergebnis herauskommen:
| Nicht stabil nach Nachnamen sortiert |
|---|
| Waltraud Birke |
| Jonathan Heinemann |
| Mathias Müller |
| Fabio Müller |
| Gertrud Selig |
| Annika Weigert |
Mathias und Fabio sind hierbei gegenüber der Ausgangsreihenfolge vertauscht.
Vergleichsbasierte und nicht-vergleichsbasierte Sortierverfahren
Die meisten der bekannten Sortierverfahren basieren auf dem Vergleich zweier Elemente auf kleiner, größer oder gleich. Es existieren jedoch auch nicht-vergleichsbasierte Sortieralgorithmen.
Wie das funktionieren kann, erfährst du in den Abschnitten Counting Sort und Radix Sort.
Parallelisierbarkeit
Diese Eigenschaft beschreibt, ob und inwieweit sich ein Sortieralgorithmus für die parallele Abarbeitung auf mehreren CPU-Kernen eignet. Mergesort z. B. kann seine beiden Hälften parallel sortieren. Heapsort dagegen verändert ständig das gesamte Array – es gibt keine naheliegende Aufteilung.
Rekursive / nicht-rekursive Sortiermethoden
Ein rekursiver Sortieralgorithmus benötigt zusätzlichen Speicherplatz auf dem Stack. Bei zu tiefer Rekursion droht der gefürchtete StackOverflowError – Quicksort etwa scheitert daran, wenn es ein vorsortiertes Array mit dem Pivot-Element rechts sortiert. Quicksort und Mergesort sind rekursiv; Insertion Sort, Selection Sort und Heapsort sind es nicht.
Adaptivität
Ein adaptiver Sortieralgorithmus kann sein Verhalten während der Laufzeit an bestimmte Eingabedaten (z. B. vorsortierte Elemente) anpassen und diese deutlich schneller sortieren als zufällig verteilte Elemente. Insertion Sort braucht auf dem M5 Pro für 524.288 aufsteigend sortierte Elemente 0,35 Millisekunden, für zufällig verteilte 12 Sekunden.
Vergleich der wichtigsten Sortieralgorithmen
Die folgende Tabelle gibt einen Überblick über alle in dieser Artikelserie vorgestellten Sortieralgorithmen. Es handelt sich um eine Auswahl der am weitesten verbreiteten Sortierverfahren. Dies sind auch die, die man in der Regel in der Informatik-Ausbildung lernt.
Jeder Eintrag ist verlinkt zu einem vertiefenden Artikel, der den jeweiligen Algorithmus und dessen Eigenschaften im Detail beschreibt und auch dessen Quellcode enthält.
Wenn dir zunächst ein Überblick genügt, findest du im Anschluss an die Tabelle die Sortieralgorithmen in jeweils einem Satz erklärt.
| Algorithmus | Zeit best case | Zeit avg. case | Zeit worst case | Platz | Stabil |
|---|---|---|---|---|---|
| Insertion Sort | O(n) | O(n²) | O(n²) | O(1) | Ja |
| Selection Sort | O(n²) | O(n²) | O(n²) | O(1) | Nein |
| Bubble Sort | O(n) | O(n²) | O(n²) | O(1) | Ja |
| Quicksort | O(n log n) | O(n log n) | O(n²) | O(log n) | Nein |
| Mergesort | O(n log n) | O(n log n) | O(n log n) | O(n) | Ja |
| Heapsort | O(n) | O(n log n) | O(n log n) | O(1) | Nein |
| Counting Sort | O(n + k) | O(n + k) | O(n + k) | O(n + k) | Ja |
| Radix Sort | O(k · (b + n)) | O(k · (b + n)) | O(k · (b + n)) | O(b + n) | Ja |
Die Variable k steht bei Counting Sort für keys (die Anzahl der möglichen Schlüsselwerte) und bei Radix Sort für key length (die maximale Länge eines Schlüssels). Die Variable b bei Radix Sort steht für Basis. Den best case O(n) erreicht Heapsort nur, wenn alle Elemente gleich sind.
Die Vergleichstabelle oben zeigt drei der sieben Eigenschaften: Zeitkomplexität, Platzkomplexität und Stabilität. Die übrigen vier – ob ein Verfahren vergleichsbasiert, rekursiv, adaptiv und parallelisierbar ist – zeigt die folgende Tabelle; die Details stehen in den jeweiligen Artikeln:
| Algorithmus | Vergleichsbasiert | Rekursiv | Adaptiv | Parallelisierbar |
|---|---|---|---|---|
| Insertion Sort | Ja | Nein | Ja | Nein |
| Selection Sort | Ja | Nein | Nein | Eingeschränkt |
| Bubble Sort | Ja | Nein | Ja | Ja (Odd-Even Sort) |
| Quicksort | Ja | Ja | Nein | Ja |
| Mergesort | Ja | Ja | Nein (Timsort: Ja) | Ja |
| Heapsort | Ja | Nein | Nein | Nein |
| Counting Sort | Nein | Nein | Nein | Ja |
| Radix Sort | Nein | Nein (MSD-Variante: Ja) | Nein | Ja |
Bei Selection Sort lässt sich nur die Suche nach dem kleinsten Element parallelisieren, nicht die äußere Schleife. Bubble Sort lässt sich parallelisieren, wird dadurch aber nicht auf jeder CPU schneller: Auf dem M5 Pro braucht die Odd-Even-Variante 3,49-mal so lange wie die sequenzielle. Und paralleles Counting Sort bleibt nur stabil, wenn jede Partition an vorab berechnete Positionen ins Zielarray schreibt.
Einfache Sortierverfahren
Einfache Sortierverfahren sind gut geeignet, um kleine Listen zu sortieren. Für große Listen sind sie aufgrund des quadratischen Aufwands ungeeignet. Insbesondere Insertion Sort (das bei unsortierten Elementen rund 40 % schneller ist als Selection Sort, weil es im Durchschnitt nur halb so viele Vergleiche braucht) wird gerne verwendet, um effiziente Sortieralgorithmen wie Quicksort und Mergesort weiter zu optimieren. Dazu lässt man diese Verfahren kleine Teillisten von einigen Dutzend Elementen (das JDK z. B. unter 44 Elementen) mit Insertion Sort sortieren.
Insertion Sort
Insertion Sort (auf Deutsch: Einfüge-Sortieren) verwendet man zum Beispiel beim Sortieren von Spielkarten: Man nimmt eine Karte nach der anderen auf und fügt sie an der richtigen Stelle in die bereits sortierten Karten ein.
| Zeit best case | Zeit avg. case | Zeit worst case | Platz | Stabil |
|---|---|---|---|---|
| O(n) | O(n²) | O(n²) | O(1) | Ja |
Selection Sort
Selection Sort kannst du dir anhand des Spielkartenbeispiels so vorstellen, dass alle einzusortierenden Karten offen vor dir liegen. Du suchst die kleinste Karte und nimmst sie auf, dann suchst du die nächstgrößere Karte und steckst sie rechts neben die erste, usw., bis du als Letztes die größte Karte ganz rechts in die Hand steckst.
| Zeit best case | Zeit avg. case | Zeit worst case | Platz | Stabil |
|---|---|---|---|---|
| O(n²) | O(n²) | O(n²) | O(1) | Nein |
Bubble Sort
Bei Bubble Sort werden von links nach rechts jeweils nebeneinanderliegende Elemente verglichen und – falls diese in der falschen Reihenfolge vorliegen – miteinander vertauscht. Dieser Vorgang wird so oft wiederholt, bis alle Elemente sortiert sind.
| Zeit best case | Zeit avg. case | Zeit worst case | Platz | Stabil |
|---|---|---|---|---|
| O(n) | O(n²) | O(n²) | O(1) | Ja |
Effiziente Sortierverfahren
Effiziente Sortieralgorithmen erreichen eine deutlich bessere Zeitkomplexität von O(n log n). Sie eignen sich daher auch für große Datensätze mit Milliarden von Elementen.
Quicksort
Quicksort funktioniert nach dem „Teile und herrsche“-Prinzip. Durch eine sogenannte Partitionierung wird der Datensatz zunächst grob in kleine und große Elemente aufgeteilt: kleine kommen nach links, große nach rechts. Jede dieser Partitionen wird danach rekursiv wieder partitioniert, so lange, bis eine Partition nur noch ein Element enthält und damit als sortiert gilt.
Sobald für alle Partitionen und Teil-Partitionen die tiefste Rekursionsstufe erreicht ist, ist die gesamte Liste sortiert.
Quicksort hat zwei Nachteile:
- Im worst case (z. B. bei bereits sortierten Elementen und ungünstiger Wahl des Pivot-Elements) ist die Zeitkomplexität O(n²) – wie sich das vermeiden lässt, zeigt der Quicksort-Artikel.
- Quicksort ist nicht stabil.
| Zeit best case | Zeit avg. case | Zeit worst case | Platz | Stabil |
|---|---|---|---|---|
| O(n log n) | O(n log n) | O(n²) | O(log n) | Nein |
Mergesort
Mergesort funktioniert ebenfalls nach dem „Teile und herrsche“-Prinzip, allerdings in umgekehrter Reihenfolge: Anstatt wie Quicksort zuerst zu partitionieren und dann in die Rekursion abzusteigen, steigt Mergesort zuerst in die Rekursion ab, bis Teillisten mit nur noch einem Element erreicht sind, und fügt dann jeweils zwei Teillisten so zusammen („merged“ sie), dass eine sortierte Teilliste entsteht.
Beim letzten Schritt aus der Rekursion heraus werden die zwei verbleibenden Teillisten gemergt und ergeben das sortierte Gesamtergebnis.
Mergesort hat gegenüber Quicksort den Vorteil, dass seine Zeitkomplexität auch im worst case O(n log n) nicht überschreitet und dass es stabil ist. Allerdings erkauft man sich diese Vorteile durch einen zusätzlichen Platzbedarf in der Größenordnung O(n).
| Zeit best case | Zeit avg. case | Zeit worst case | Platz | Stabil |
|---|---|---|---|---|
| O(n log n) | O(n log n) | O(n log n) | O(n) | Ja |
Heapsort
Heapsort arbeitet mit der Datenstruktur Heap, einem auf ein Array abgebildeten Binärbaum, in dem jeder Knoten größer oder gleich seinen Kindern ist. Das größte Element liegt also immer auf der Wurzelposition.
Dieses Wurzelelement wird entnommen, dann wird das letzte Element auf die Wurzelposition gesetzt und danach der Baum per „Heapify“-Operation repariert, woraufhin wiederum das größte der verbleibenden Elemente auf der Wurzelposition liegt. Der Prozess wird so lange wiederholt, bis der Baum leer ist. Die dem Baum entnommenen Elemente ergeben das sortierte Ergebnis.
| Zeit best case | Zeit avg. case | Zeit worst case | Platz | Stabil |
|---|---|---|---|---|
| O(n) | O(n log n) | O(n log n) | O(1) | Nein |
Den best case O(n) erreicht Heapsort nur, wenn alle Elemente gleich sind.
Nicht-vergleichsbasierte Sortierverfahren
Nicht-vergleichsbasierte Sortierverfahren basieren nicht auf dem Vergleich zweier Elemente auf kleiner, größer oder gleich.
Wie können sie dann funktionieren?
Am besten lässt sich das an einem Beispiel erklären – im Folgenden anhand von Counting Sort.
Counting Sort
Bei Counting Sort werden Elemente – wie der Name schon sagt – gezählt. Um beispielsweise ein Array mit Zahlen aus dem Bereich 1 bis 10 zu sortieren, zählen wir (in einem einzigen Durchgang), wie oft die 1 vorkommt, wie oft die 2, usw. bis zur 10.
Im zweiten Durchgang schreiben wir dann die 1 so oft von links beginnend in das Array, wie sie vorkommt, dann die 2 so oft, wie diese vorkommt, usw. wiederum bis zur 10.
Dieses Verfahren wird in der Regel nur für kleine Zahlentypen wie byte, char oder short eingesetzt, oder wenn der Bereich der zu sortierenden Zahlen bekannt ist (z. B. int-Werte zwischen 0 und 150). Der Grund dafür ist, dass wir für das Zählen der Elemente ein zusätzliches Array entsprechend der Größe des Zahlenbereichs benötigen.
| Zeit best case | Zeit avg. case | Zeit worst case | Platz | Stabil |
|---|---|---|---|---|
| O(n + k) | O(n + k) | O(n + k) | O(n + k) | Ja |
Die Variable k steht für die Anzahl der möglichen Werte (keys).
Radix Sort
Bei Radix Sort werden die Elemente Ziffer für Ziffer sortiert. Dreistellige Zahlen z. B. zuerst nach den Einerstellen, dann nach den Zehnerstellen und zuletzt nach den Hunderterstellen.
Dieses Verfahren eignet sich im Gegensatz zu Counting Sort auch für große Zahlenräume wie int und long und ist stabil. Nicht-negative int-Werte sortiert es ab 2.048 Elementen sogar schneller als Quicksort und Arrays.sort(). Allerdings hat es mit O(b + n) einen linearen zusätzlichen Platzbedarf und wird daher seltener eingesetzt.
| Zeit best case | Zeit avg. case | Zeit worst case | Platz | Stabil |
|---|---|---|---|---|
| O(k · (b + n)) | O(k · (b + n)) | O(k · (b + n)) | O(b + n) | Ja |
Sonstige Sortieralgorithmen
Es gibt zahlreiche weitere Sortieralgorithmen (Shell Sort, Comb Sort, Bucket Sort, um nur ein paar zu nennen). Die in diesem Artikel vorgestellten Methoden zu kennen stellt meiner Meinung nach jedoch ein sehr gutes Grundlagenwissen dar.
Falls du dir die Javadocs von List.sort() und Arrays.sort() durchgelesen hast, fragst du dich vielleicht, warum ich hier Timsort und Dual-Pivot Quicksort nicht aufführe.
Timsort ist kein komplett eigenständiges Sortierverfahren. Vielmehr ist es eine Kombination aus Mergesort, Insertion Sort und etwas zusätzlicher Logik. Timsort beschreibe ich im Artikel über Mergesort.
Ebenso ist Dual-Pivot Quicksort eine Variante des regulären Quicksort und wird im Quicksort-Artikel beschrieben.
Welcher Sortieralgorithmus ist der schnellste?
Das hängt von der Anzahl und der Art der Elemente ab – für jeden Fall geben die Messungen dieser Serie eine klare Antwort:
- Wenige Elemente: Für sehr kleine Arrays ist Insertion Sort schneller als Quicksort. Gibt Quicksort Teil-Arrays mit bis zu 96 Elementen an Insertion Sort ab, sinkt seine Laufzeit für 5,5 Millionen Elemente auf etwa 85 %.
- Viele Elemente, beliebiger Typ: Quicksort ist das schnellste vergleichsbasierte Verfahren dieser Serie. Für eine Viertelmilliarde unsortierte Elemente ist es 25 % schneller als Mergesort; Heapsort braucht für 67.108.864 zufällig verteilte Elemente 3,1-mal so lange wie Quicksort.
- Viele nicht-negative
int-Werte: Hier gewinnt Radix Sort. 134.217.728 Elemente sortiert es in 1,2 Sekunden,Arrays.sort()braucht 7,0 Sekunden. Radix Sort belegt dafür zusätzlichen Speicher in der Größenordnung des Eingabearrays.
Ich empfehle dir trotzdem, zuerst zu Arrays.sort() und List.sort() zu greifen. Beide greifen auf die Verfahren aus diesem Artikel zurück: Arrays.sort() kombiniert für primitive Datentypen Dual-Pivot Quicksort mit Insertion Sort und Heapsort und nimmt für größere byte-, short- und char-Arrays Counting Sort; Objekte sortieren beide mit Timsort. Welcher Algorithmus wann zum Zug kommt, zeigt der Artikel über Sortieren in Java.
Hat dein Rechner mehrere Kerne, sortiert Arrays.parallelSort() große Arrays auf mehreren Kernen gleichzeitig: 100 Millionen double-Werte auf dem M5 Pro in 0,52 Sekunden – Arrays.sort() braucht dafür 6,1 Sekunden.
Zusammenfassung
Dieser Artikel hat einen Überblick über die gängigsten Sortieralgorithmen gegeben und die Eigenschaften beschrieben, in denen sich diese hauptsächlich unterscheiden.
Die weiteren Teile dieser Serie beschreiben je einen Sortieralgorithmus im Detail – anhand von Beispielen und mit Quellcodes. Die Links findest du in der Vergleichstabelle oben.
In einem weiteren Teil gebe ich einen Überblick über die Sortiermethoden, die Java bereitstellt, und zeige, wie man zum einen primitive Datentypen sortiert und zum anderen Objekte mit Hilfe von Comparator und Comparable.
Was soll ich als Nächstes vertiefen? Das erfahre ich am besten durch dein Feedback: Eine Bewertung auf meinem ProvenExpert-Profil zeigt mir, welche Themen dir wichtig sind – und motiviert mich, weitere Artikel zu schreiben.