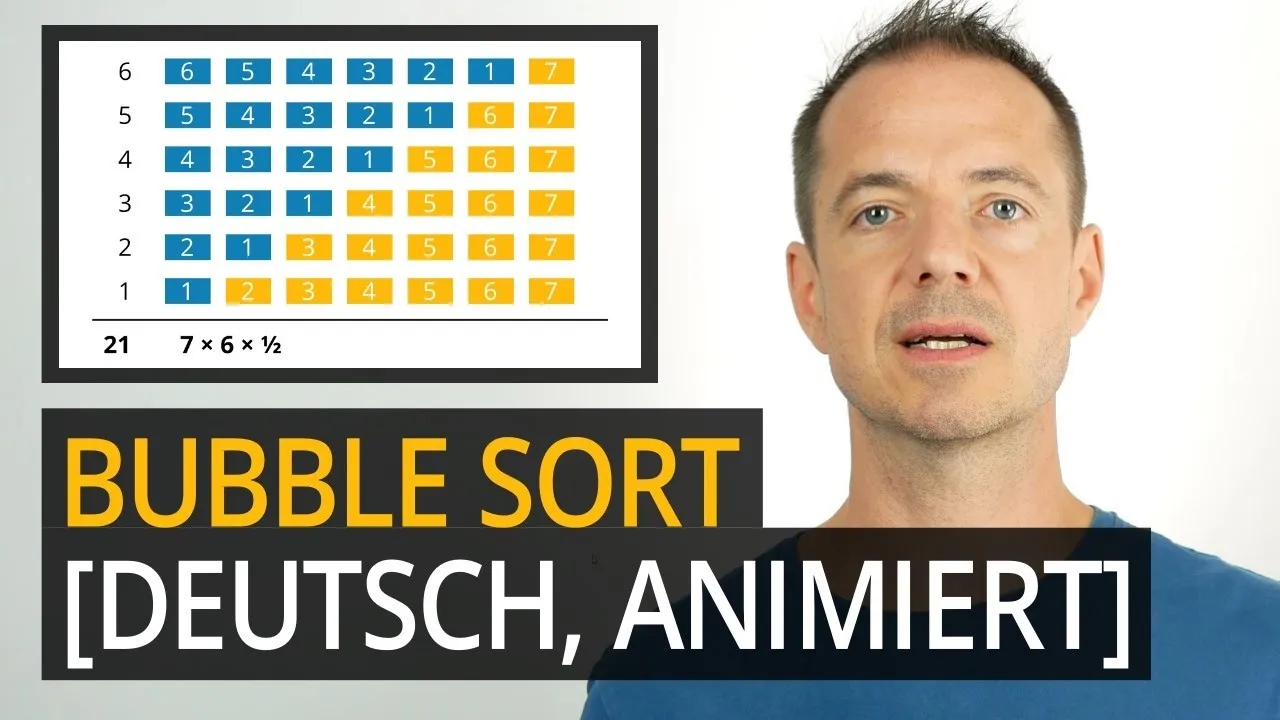
Dieser Artikel ist Teil der Serie „Sortieralgorithmen: Ultimate Guide“ und…
- erklärt die Funktionsweise von Bubble Sort,
- stellt den Quellcode von Bubble Sort vor,
- erklärt, wie man die Zeitkomplexität von Bubble Sort herleitet
- und prüft, ob die gemessene Laufzeit der Implementierung dem Verhalten entspricht, das die Zeitkomplexität erwarten lässt.
Die Quellcodes aller Artikel dieser Serie findest du in meinem GitHub-Repository.
Bubble Sort Algorithmus
Bei Bubble Sort (auch: „Bubblesort“) werden jeweils zwei aufeinanderfolgende Elemente miteinander verglichen und – wenn das linke Element größer ist als das rechte – werden diese vertauscht.
Diese Vergleichs- und Tauschoperationen führt man von links nach rechts über alle Elemente durch, so dass nach dem ersten Durchlauf das größte Element ganz rechts positioniert ist (besser gesagt: spätestens nach dem ersten Durchlauf – es kann auch schon vorher dort angekommen sein).
Diesen Prozess wiederholt man so lange, bis es in einem Durchlauf zu keinem weiteren Vertauschen mehr kommt.
Bubble Sort Beispiel
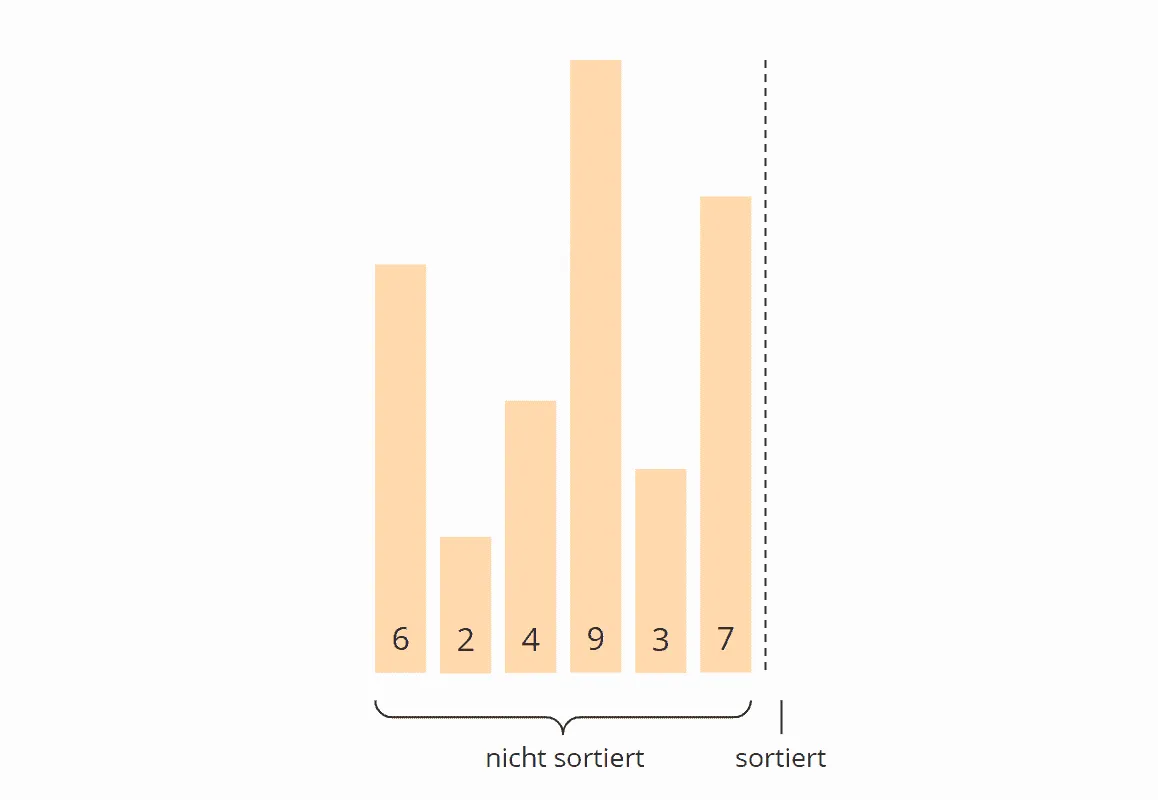
Im Folgenden zeige ich, wie man das Array [6, 2, 4, 9, 3, 7] mit Bubble Sort sortiert:
Vorbereitung
Wir teilen das Array gedanklich in einen linken, nicht sortierten, und einen rechten, sortierten Teil. Der rechte Teil ist zu Beginn leer:
Iteration 1
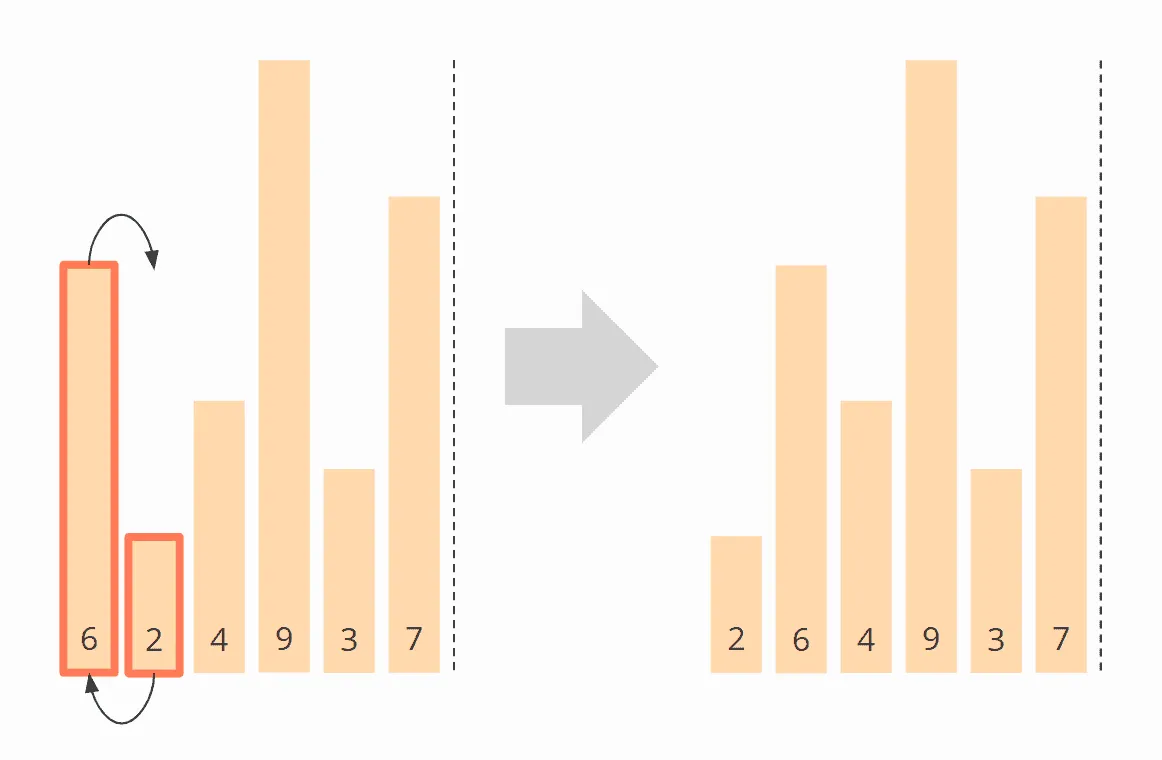
Wir vergleichen die ersten beiden Elemente, die 6 und die 2. Da die 6 größer ist, vertauschen wir die Elemente:
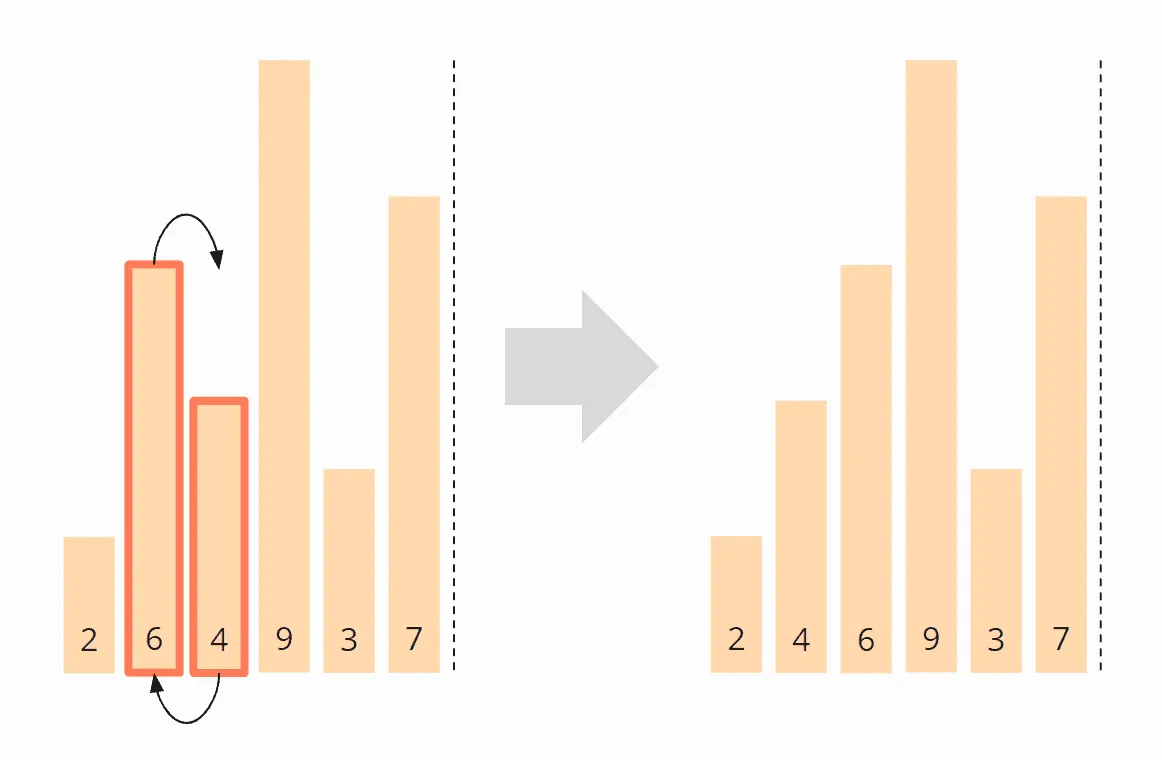
Nun vergleichen wir das zweite mit dem dritten Element, also die 6 mit der 4. Auch diese liegen in verkehrter Reihenfolge vor und werden vertauscht:
Wir vergleichen das dritte mit dem vierten Element, also die 6 mit der 9. Die 6 ist kleiner als die 9, also brauchen wir diese zwei Elemente nicht zu vertauschen.
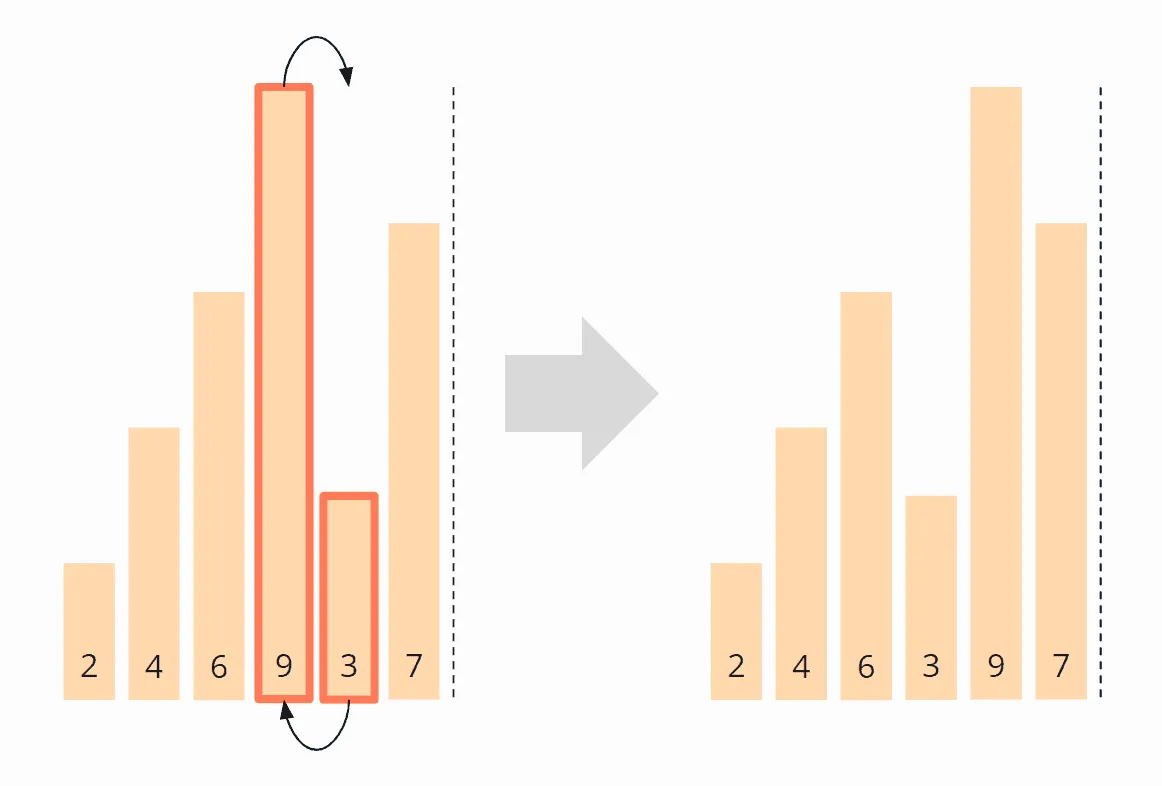
Das vierte und fünfte Element, die 9 und die 3, müssen wiederum vertauscht werden:
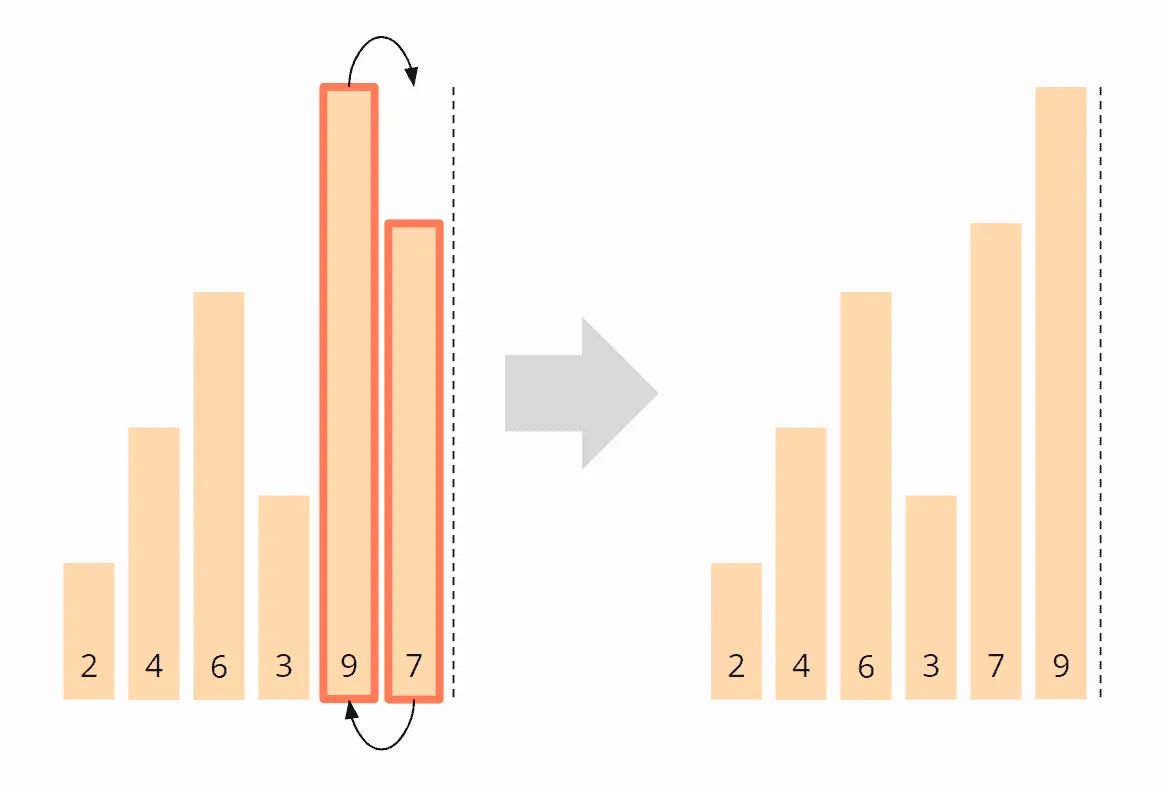
Und zuletzt müssen das fünfte und sechste Element, die 9 und die 7, miteinander vertauscht werden. Danach ist die erste Iteration abgeschlossen.
Die 9 hat ihre finale Position erreicht und wir verschieben die Grenze zwischen den Bereichen um eine Position nach links:
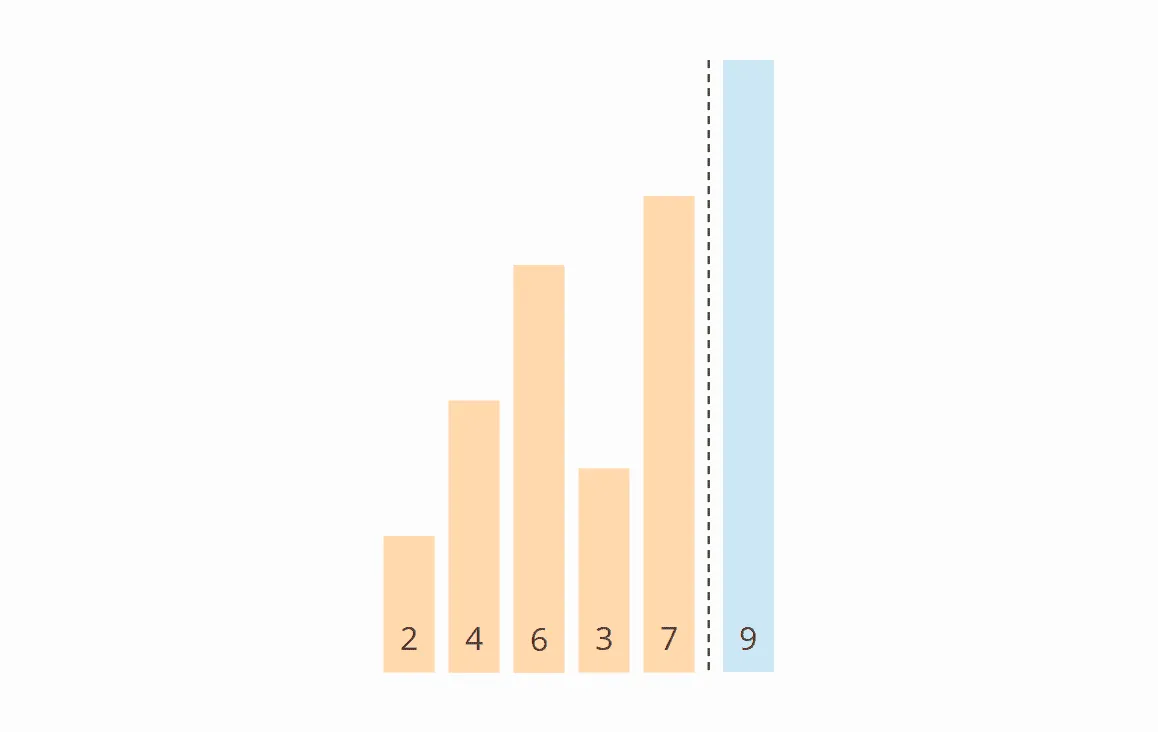
Diese Bereichsgrenze zeigt uns in der nächsten Iteration, bis zu welcher Position die Elemente verglichen werden müssen. Die Bereichsgrenze gibt es übrigens nur in der optimierten Variante von Bubble Sort. In der ursprünglichen Variante fehlt sie, so dass in jeder Iteration unnötigerweise bis zum Ende des Arrays verglichen wird.
Iteration 2
Wir starten erneut am Anfang des Arrays und vergleichen die 2 mit der 4. Diese liegen in korrekter Reihenfolge vor und müssen nicht vertauscht werden.
Das gleiche gilt für die 4 und die 6.
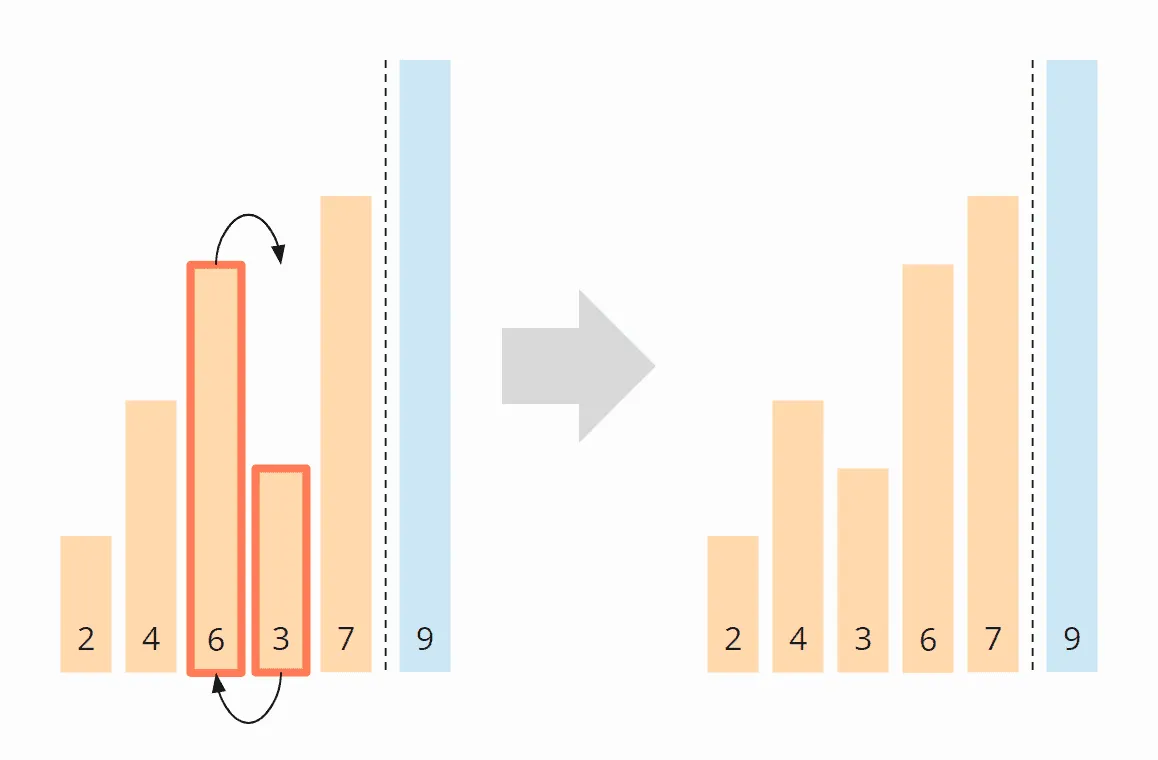
Die 6 und die 3 hingegen müssen vertauscht werden, um in richtiger Reihenfolge vorzuliegen:
Die 6 und die 7 liegen in korrekter Reihenfolge vor und müssen nicht vertauscht werden. Weiter brauchen wir nicht zu vergleichen, denn die 9 liegt bereits im sortierten Bereich.
Zuletzt schieben wir die Bereichsgrenze wieder um eine Position nach links, damit wir die letzten zwei Elemente, die 7 und die 9, nicht weiter betrachten müssen.
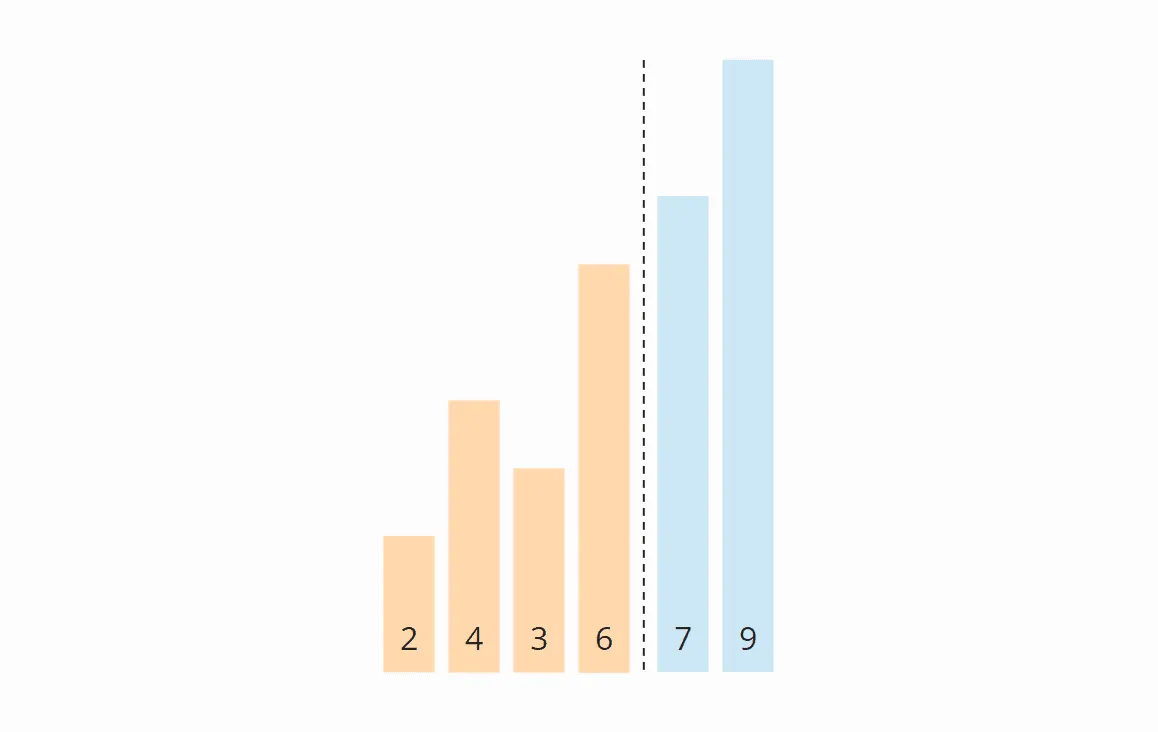
Iteration 3
Wieder starten wir am Anfang des Arrays. Die 2 und die 4 stehen korrekt zueinander. Die 4 und die 3 müssen vertauscht werden:
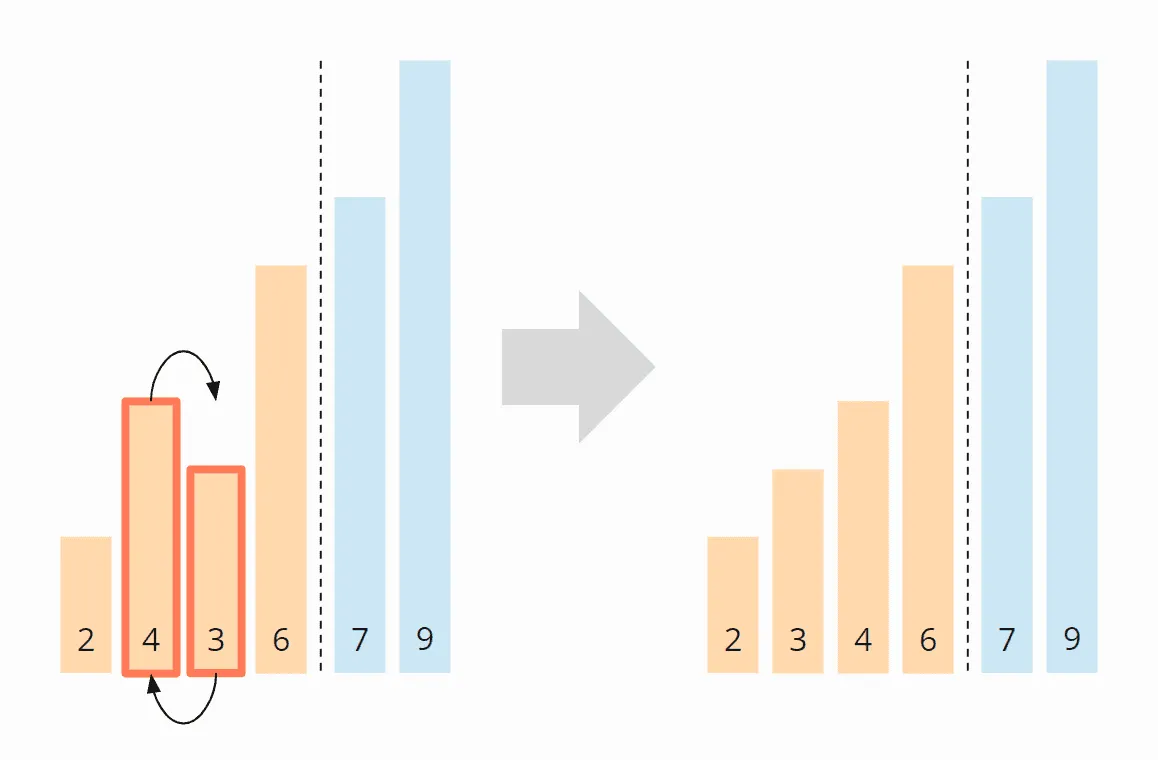
Die 4 und die 6 müssen nicht vertauscht werden. Die 7 und die 9 sind bereits sortiert. Damit ist diese Iteration auch schon beendet und wir schieben die Bereichsgrenze nach links:
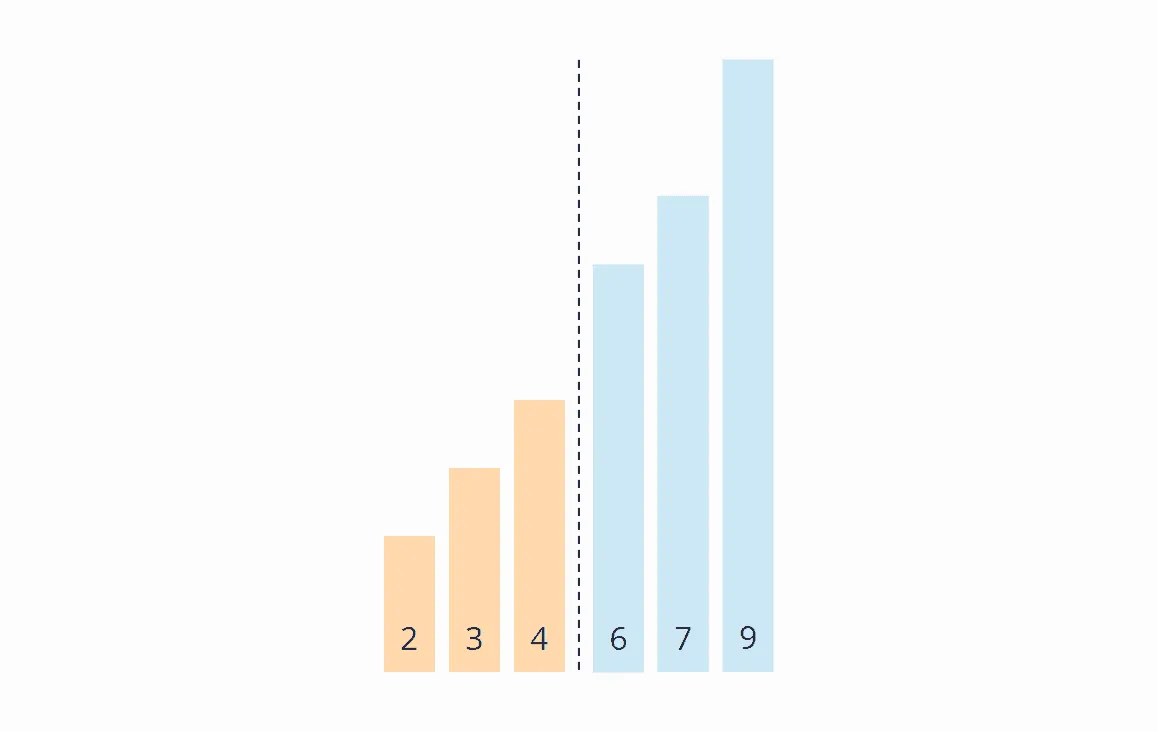
Iteration 4
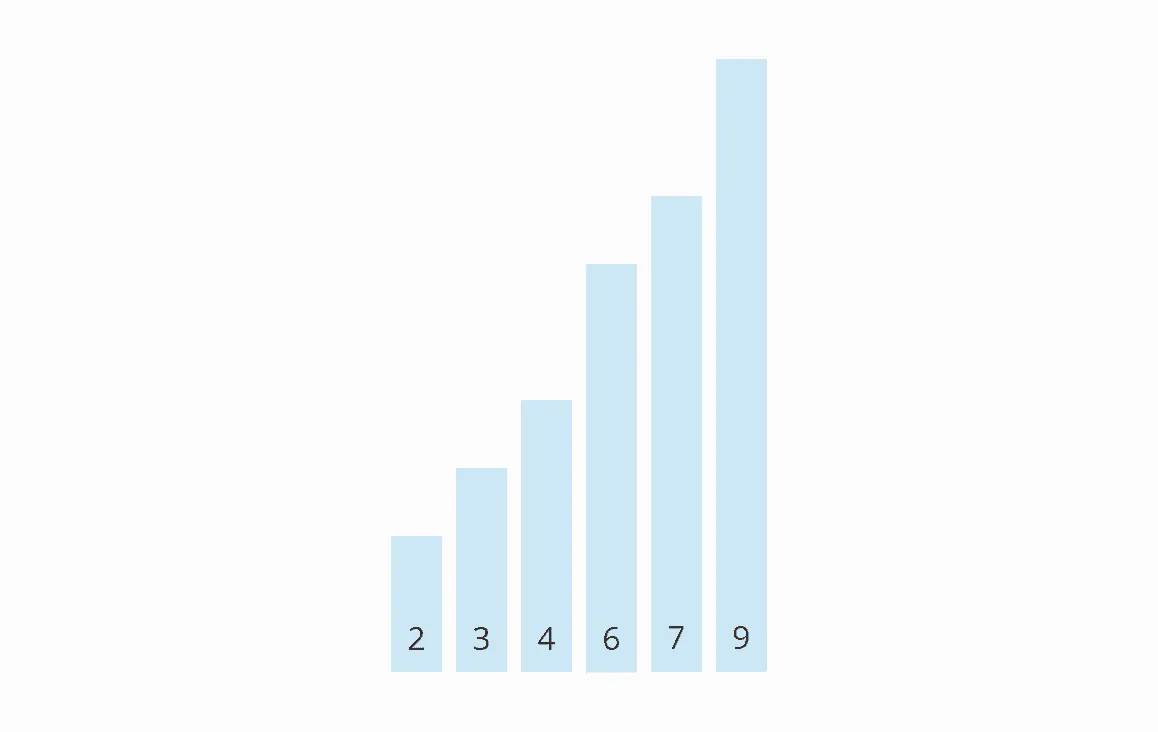
Wir beginnen wieder am Anfang des Arrays. Im unsortierten Bereich müssen weder die 2 und 3 noch die 3 und 4 vertauscht werden. Damit sind alle Elemente sortiert und wir können den Algorithmus beenden.
Herkunft des Namens
Wenn wir die Vertauschoperationen des vorherigen Beispiels animieren, steigen die Elemente nach und nach bis zu ihren Zielpositionen auf – ähnlich wie Luftblasen (englisch: „bubbles“), daher der Name „Bubble Sort“:
Bubble Sort Java Quellcode
Im Folgenden findest du die oben beschriebene, optimierte Implementierung von Bubble Sort.
Da in der ersten Iteration das größte Element bis ganz nach rechts wandert, in der zweiten Iteration das zweitgrößte bis zur zweitletzten Position, usw., müssen wir in jeder Iteration ein Element weniger vergleichen als in der vorherigen.
Im Beispiel im vorangegangenen Abschnitt hatte ich das durch die Bereichsgrenze dargestellt, die nach jeder Iteration um eine Position nach links wandert.
Dazu dekrementieren wir in der äußeren Schleife den Wert max, beginnend bei elements.length - 1, in jeder Iteration um eins.
Die innere Schleife vergleicht dann jeweils zwei Elemente bis zur Position max miteinander und vertauscht diese, wenn das linke Element größer ist als das rechte.
Wurden in einer Iteration keine Elemente vertauscht (d. h. swapped ist false), endet der Algorithmus vorzeitig.
public class BubbleSortOpt1 {
  public static void sort(int[] elements) {
    for (int max = elements.length - 1; max > 0; max--) {
      boolean swapped = false;
      for (int i = 0; i < max; i++) {
        int left = elements[i];
        int right = elements[i + 1];
        if (left > right) {
          elements[i + 1] = left;
          elements[i] = right;
          swapped = true;
        }
      }
      if (!swapped) break;
    }
  }
}
Der abgebildete Code unterscheidet sich leicht von der Klasse BubbleSortOpt1 im GitHub-Repository: Diese implementiert das Interface SortAlgorithm, um innerhalb des Testframeworks austauschbar zu sein.
Die nicht-optimierte Variante – in der der Algorithmus in jeder Iteration alle Elemente bis zum Ende vergleicht – findest du in der Klasse BubbleSort.
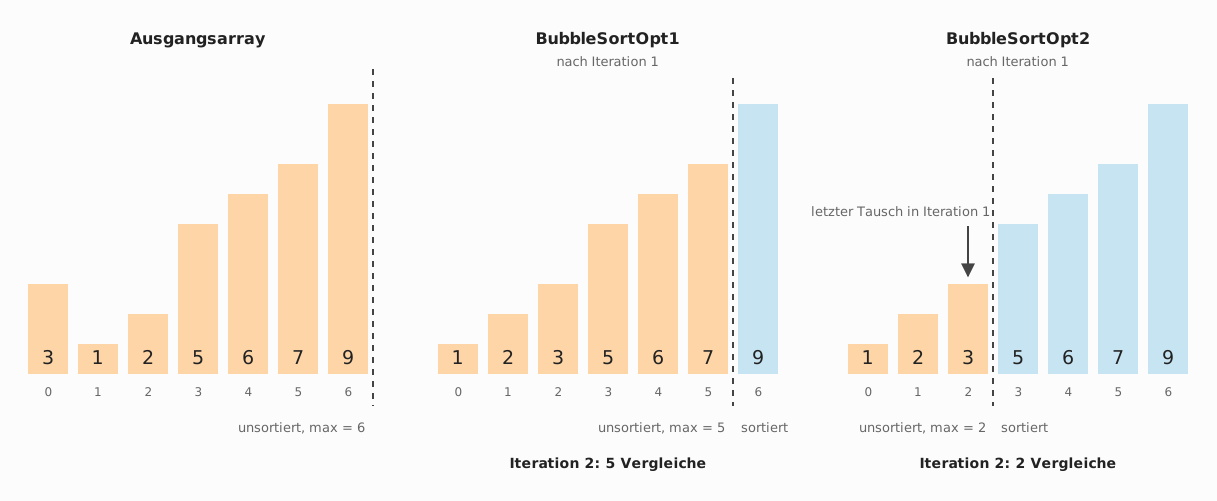
In der Klasse BubbleSortOpt2 findest du einen theoretisch noch stärker optimierten Algorithmus. Es kann nämlich auch sein, dass nach der n-ten Iteration nicht nur die letzten n Elemente sortiert sind, sondern mehr – je nachdem, wie die Elemente ursprünglich angeordnet waren.
Diese Variante zählt daher max nicht um jeweils 1 herunter, sondern setzt max nach jeder Iteration auf die Position desjenigen Elements, das zuletzt vertauscht wurde.
Die folgende Grafik zeigt beide Varianten nach der ersten Iteration beim Sortieren des Arrays [3, 1, 2, 5, 6, 7, 9]. Links ist max um eins vermindert; rechts steht max auf 2, da es nach Position 2 keinen weiteren Tausch mehr gab. BubbleSortOpt1 führt in der nächsten Iteration also noch einmal fünf Vergleiche durch, BubbleSortOpt2 nur zwei.
Der Test CompareBubbleSorts zeigt allerdings, dass diese Variante in der Praxis kaum etwas bringt. Der Test sortiert 40.000 unsortierte Elemente mit jeder Variante, 100-mal nach 15 Warm-up-Runden. Auf einem Intel Core i7-12700H ist das Ergebnis:
----- Results after 100 iterations-----
BubbleSort     -> fastest: 1,964.758 ms, median: 1,996.803 ms
BubbleSortOpt1 -> fastest: 1,620.518 ms, median: 1,655.024 ms
BubbleSortOpt2 -> fastest: 1,567.071 ms, median: 1,590.026 ms
Und auf einem Apple M5 Pro:
----- Results after 100 iterations-----
BubbleSort     -> fastest:   937.231 ms, median:   950.006 ms
BubbleSortOpt1 -> fastest:   591.295 ms, median:   650.216 ms
BubbleSortOpt2 -> fastest:   650.353 ms, median:   672.370 ms
Auf dem i7-12700H ist BubbleSortOpt2 um 4 % schneller als BubbleSortOpt1, auf dem M5 Pro um 3 % langsamer. In der ersten Fassung dieses Artikels von 2020 war sie auf einem Intel Core i7-8750H um 13 % langsamer.
Die Vergleiche, die die zweite optimierte Variante einspart, zahlen sich also kaum aus. Meine Vermutung ist, dass das Speichern und das (innerhalb einer Iteration) mehrfache Aktualisieren der Position des zuletzt vertauschten Elements teurer ist als das (pro Iteration) maximal einmalige Ändern des swapped-Werts – und welcher der beiden Effekte überwiegt, hängt von der CPU ab.
Die vollständige Ausgabe des Testprogramms liegt im GitHub-Repository, für den i7-12700H, den M5 Pro und den Lauf von 2020.
Bubble Sort Zeitkomplexität
Wir bezeichnen die Anzahl der zu sortierenden Elemente mit n, im Beispiel oben wäre n = 6.
Die zwei ineinander verschachtelten Schleifen lassen vermuten, dass wir es bei Bubble Sort mit quadratischem Aufwand zu tun haben, also einer Zeitkomplexität von O(n²). Dies wäre dann der Fall, wenn beide Schleifen bis zu einem Wert iterieren, der linear mit n steigt.
Dies ist bei Bubble Sort nicht ganz so einfach nachzuweisen, wie z. B. bei Insertion Sort oder Selection Sort.
Bei Bubble Sort müssen wir best, worst und average case separat betrachten. Dies geschieht in den folgenden Unterabschnitten.
Zeitkomplexität im best case
Fangen wir mit dem einfachsten Fall an: Falls die Zahlen bereits aufsteigend sortiert sind, wird der Algorithmus in der ersten Iteration feststellen, dass keine Zahlenpaare vertauscht werden müssen und daraufhin umgehend terminieren.
Dabei muss der Algorithmus n-1 Vergleiche durchführen; also gilt:
Die Zeitkomplexität von Bubble Sort beträgt im best case: O(n)
Das gilt nur für die optimierte Variante mit dem swapped-Flag. Die ursprüngliche Variante ohne vorzeitigen Abbruch führt auch bei sortierter Eingabe alle n – 1 Iterationen aus und liegt damit auch im best case bei O(n²).
Zeitkomplexität im worst case
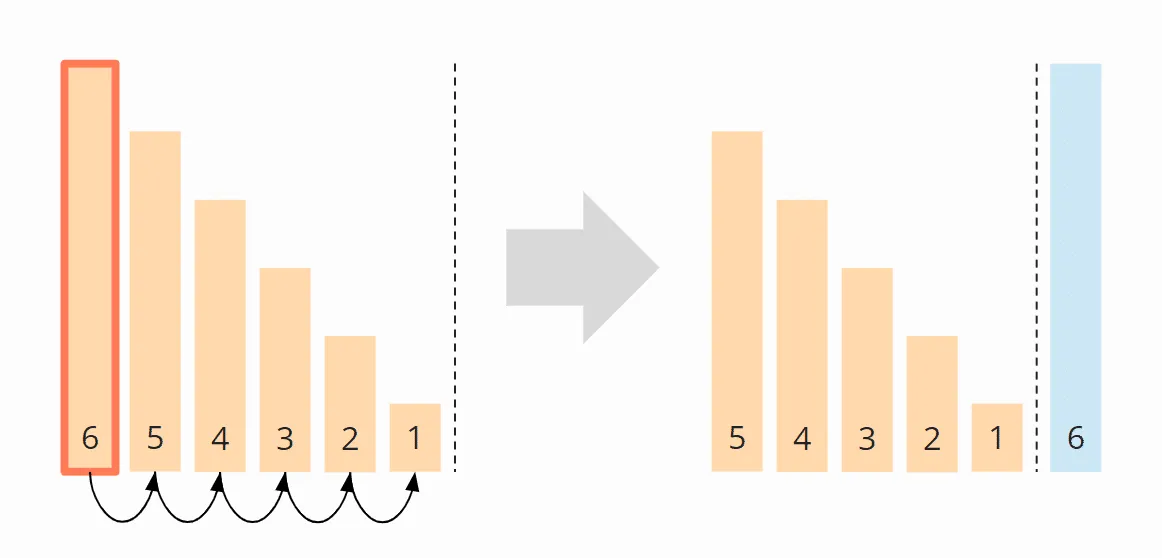
Den worst case demonstriere ich an einem Beispiel. Nehmen wir an, wir wollen das absteigend sortierte Array [6, 5, 4, 3, 2, 1] mit Bubble Sort sortieren.
In der ersten Iteration wandert das größte Element, die 6, von ganz links nach ganz rechts. Die fünf Einzelschritte (Vertauschen der Paare 6/5, 6/4, 6/3, 6/2, 6/1) habe ich in der Abbildung weggelassen:
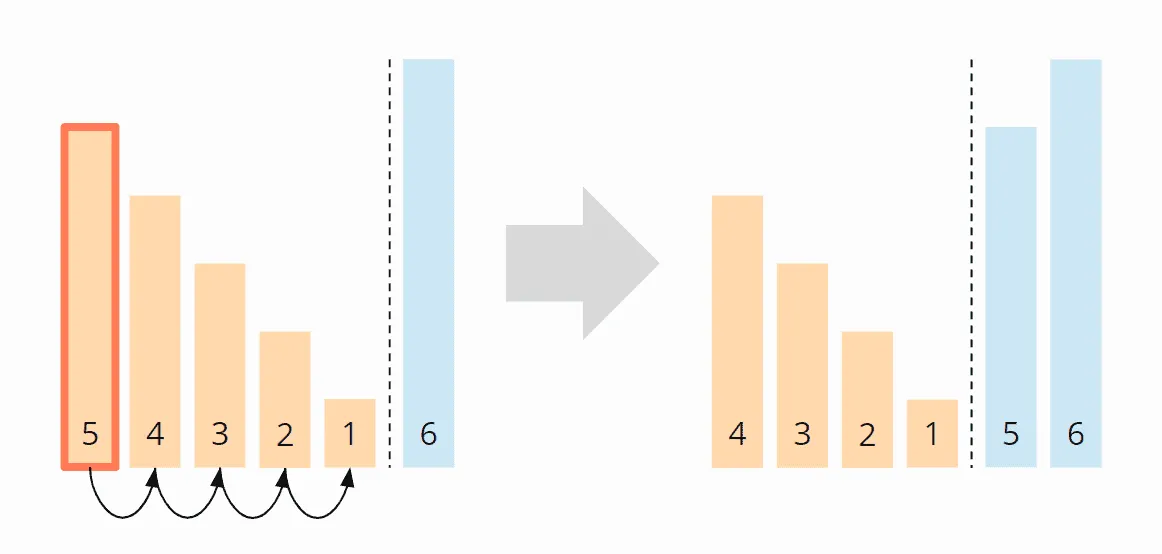
In der zweiten Iteration wird das zweitgrößte Element, die 5, von ganz links – über vier Zwischenschritte – an die vorletzte Position verschoben:
In der dritten Iteration wird die 4 – über drei Zwischenschritte – an die drittletzte Stelle geschoben:
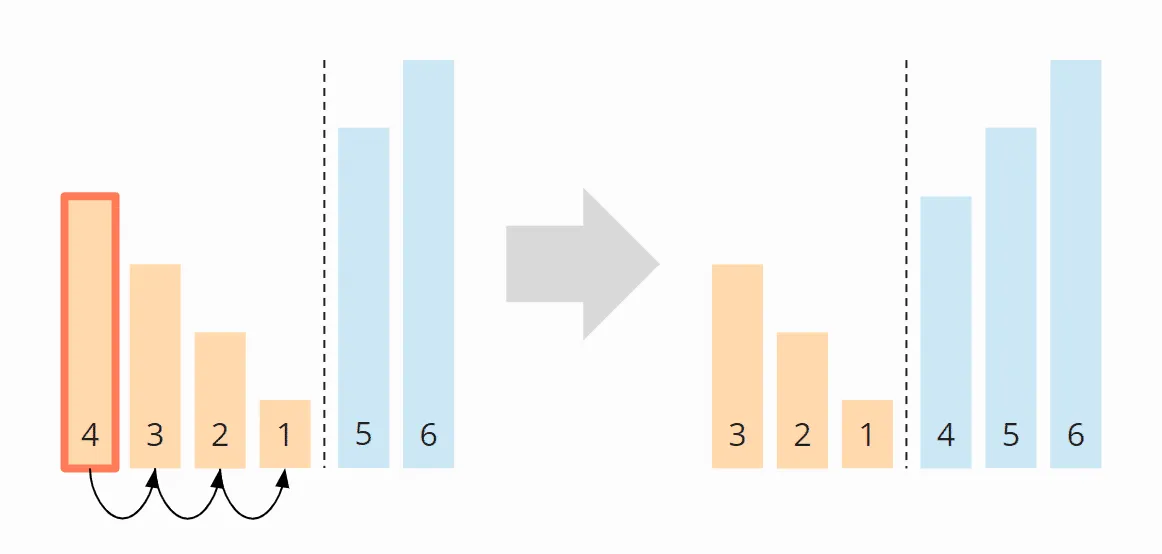
In der vierten Iteration wird die 3 – über zwei Einzelschritte – an ihre finale Position verschoben:
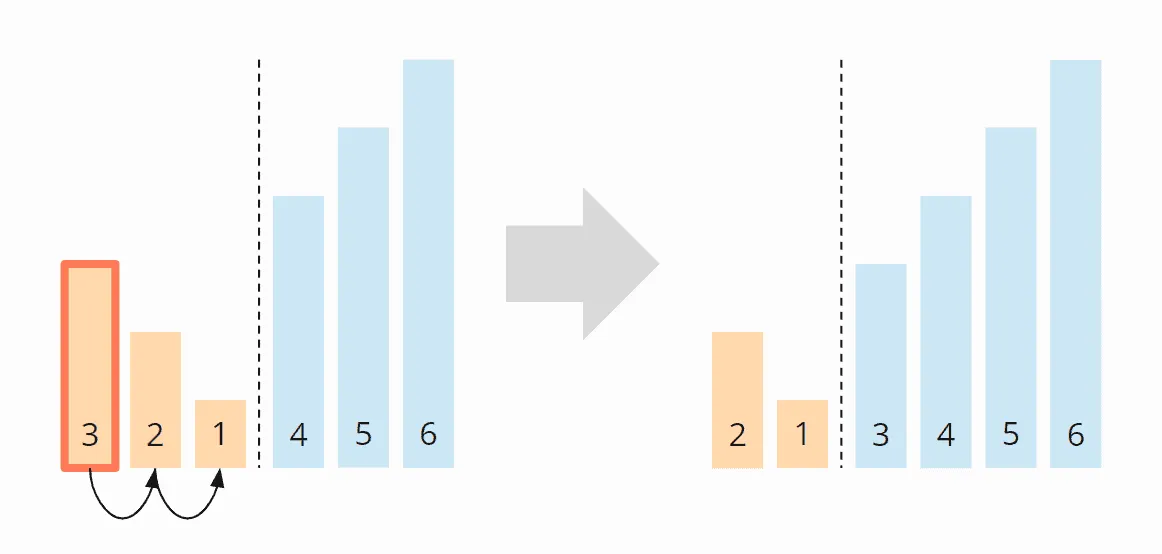
Und zuletzt werden die 2 und die 1 vertauscht:
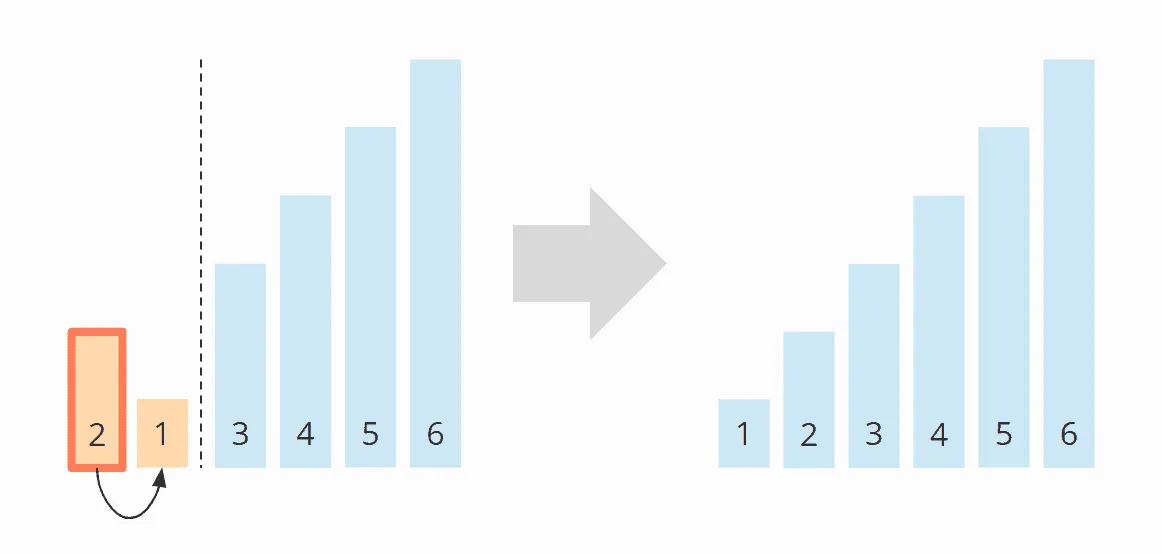
In Summe haben wir also 5 + 4 + 3 + 2 + 1 = 15 Vergleichs- und Tauschoperationen.
Das können wir auch wie folgt ausrechnen:
Sechs Elemente mal fünf Vergleichs- und Tauschoperationen; geteilt durch zwei, da im Mittel über alle Iterationen die Hälfte der Elemente verglichen und verschoben wird:
6 × 5 × ½ = 30 × ½ = 15
Ersetzen wir 6 durch n, erhalten wir:
n × (n – 1) × ½
Ausmultipliziert ergibt das:
½ (n² – n)
Die höchste Potenz von n in diesem Term ist n²; es gilt also:
Die Zeitkomplexität von Bubble Sort beträgt im worst case: O(n²)
Zeitkomplexität im average case
Die durchschnittliche Zeitkomplexität lässt sich bei Bubble Sort – im Gegensatz zu den meisten anderen Sortieralgorithmen – leider nicht auf anschauliche Art und Weise erklären.
Ohne dies mathematisch zu beweisen (das würde den Rahmen dieses Artikels sprengen), kann man grob sagen, dass man im average case etwa halb so viele Tauschoperationen hat wie im worst case, da sich etwa die Hälfte der Elemente im Vergleich zum Nachbarelement an der richtigen Position befindet. Die Anzahl der Tauschoperationen ist also:
¼ (n² – n)
Bei der Anzahl der Vergleichsoperationen wird es noch komplizierter, diese beträgt (Quelle: Wikipedia):
½ (n² – n × ln(n) – (γ + ln(2) – 1) × n) + O(√n)
γ ist dabei die Euler-Mascheroni-Konstante, etwa 0,5772.
In beiden Termen ist die höchste Potenz von n wieder n², so dass gilt:
Die Zeitkomplexität von Bubble Sort beträgt im average case: O(n²)
Laufzeit des Java Bubble Sort-Beispiels
Überprüfen wir die Theorie mit einem Test! Im GitHub-Repository findest du das Programm UltimateTest, das Bubble Sort und alle anderen Sortierverfahren dieser Artikelserie misst:
- für Array-Größen ab 1.024 Elementen, jeweils verdoppelt, bis ein Sortiervorgang länger als 20 Sekunden dauert (höchstens bis 536.870.912 Elemente);
- mit unsortierten, aufsteigend und absteigend sortierten Elementen;
- mit zwei Warm-up-Runden, damit der HotSpot-Compiler den Code optimieren kann.
Für Bubble Sort zeige ich die Ergebnisse von zwei Rechnern, weil sie sich in zwei Punkten unterschiedlich verhalten, die dieser Artikel erklärt: einem Intel Core i7-12700H (x86) und einem Apple M5 Pro (arm64). Hier die Zeiten für unsortierte und absteigend sortierte Elemente (der Übersichtlichkeit halber nur ein Auszug):
| n | i7: unsortiert | i7: absteigend | M5: unsortiert | M5: absteigend |
|---|---|---|---|---|
| ... | ... | ... | ... | ... |
| 8.192 | 44,14 ms | 37,11 ms | 17,59 ms | 43,93 ms |
| 16.384 | 237,29 ms | 150,37 ms | 69,27 ms | 176,46 ms |
| 32.768 | 1.070,42 ms | 601,36 ms | 349,71 ms | 705,84 ms |
| 65.536 | 4.507,21 ms | 2.410,48 ms | 2.381,79 ms | 2.835,76 ms |
| 131.072 | 18.509,36 ms | 9.625,46 ms | 12.009,12 ms | 11.337,42 ms |
Und für aufsteigend sortierte Elemente:
| n | i7-12700H | M5 Pro |
|---|---|---|
| ... | ... | ... |
| 8.192 | 0,007 ms | 0,004 ms |
| 131.072 | 0,059 ms | 0,038 ms |
| 262.144 | 0,102 ms | 0,068 ms |
| ... | ... | ... |
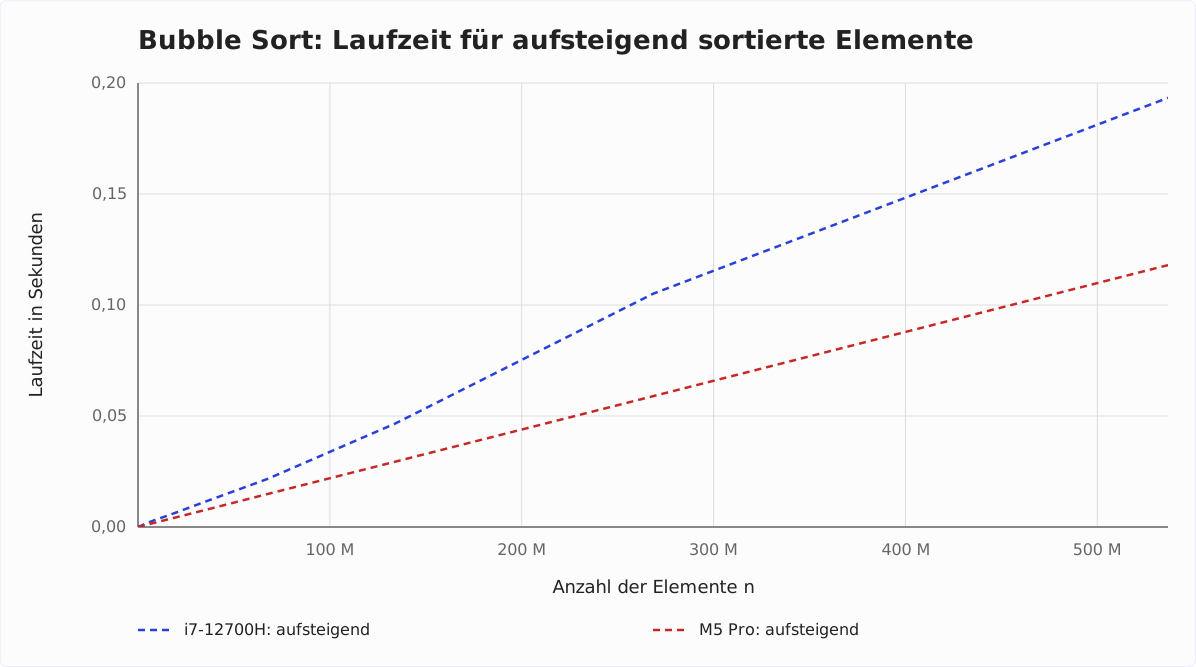
| 536.870.912 | 193,332 ms | 117,977 ms |
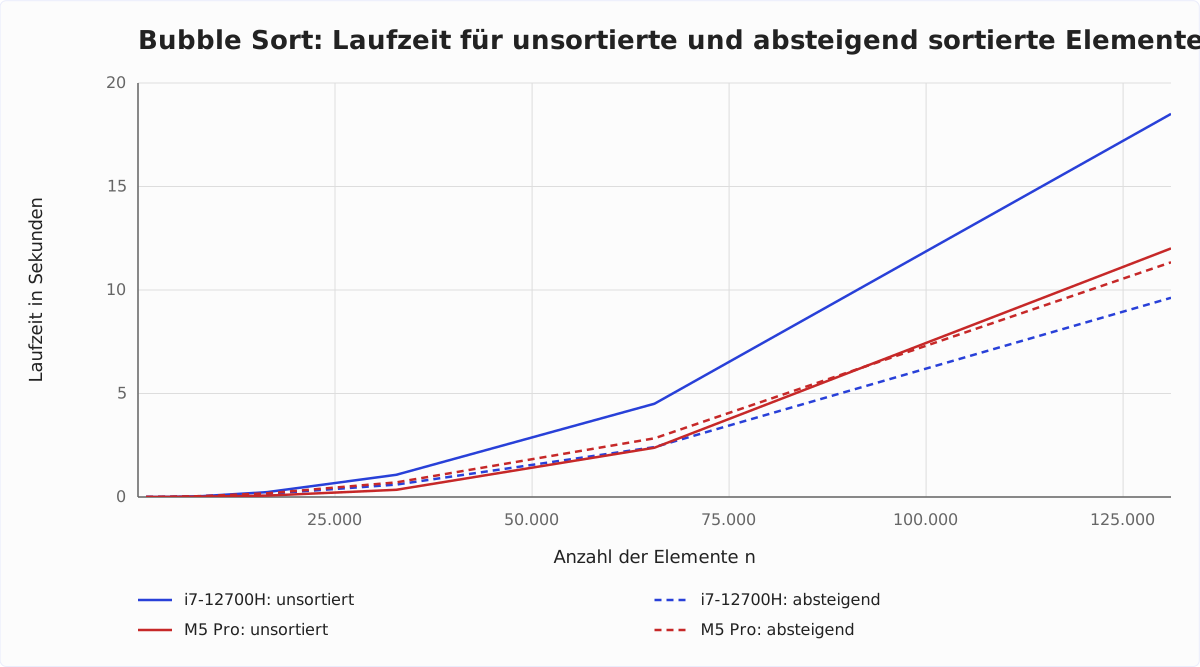
Hier die Messwerte als Diagramm, in Blau für den i7-12700H, in Rot für den M5 Pro:
Bei aufsteigend sortierten Elementen ist Bubble Sort so schnell, dass sich die Linien in diesem Diagramm nicht von der x-Achse abheben würden. Deshalb hier der best case einzeln, bis 536.870.912 Elemente:
Man kann erkennen, ...
- dass sich die Laufzeit bei Verdopplung der Eingabemenge bei absteigend sortierten Elementen vervierfacht – auf beiden Rechnern (Faktor 3,99 bis 4,05);
- dass sie bei unsortierten Elementen schneller wächst: auf dem i7-12700H von 8.192 auf 16.384 Elemente um den Faktor 5,38, danach abnehmend bis 4,11; auf dem M5 Pro zunächst um 3,94 und dann um 5,05, 6,81 und 5,04;
- dass die Laufzeit bei aufsteigend sortierten Elementen linear wächst und um Größenordnungen kleiner ist als bei unsortierten Elementen: etwa 0,22 ns pro Element auf dem M5 Pro ab 1.048.576 Elementen, 0,32 bis 0,39 ns auf dem i7-12700H ab 262.144 Elementen;
- dass unsortierte Elemente auf dem i7-12700H 1,19- bis 1,92-mal so lange brauchen wie absteigend sortierte (2020 waren es 1,75- bis 2,31-mal). Auf dem M5 Pro ist es umgekehrt: Bis 65.536 Elemente brauchen absteigend sortierte Elemente 1,19- bis 2,55-mal so lange wie unsortierte; erst bei 131.072 Elementen sind sie etwas schneller.
Die erste und die dritte Beobachtung entsprechen den Erwartungen.
Doch warum wächst die Laufzeit bei unsortierten Elementen stärker als quadratisch? Und warum ist die Laufzeit auf dem i7-12700H im average case so viel höher als im worst case? Müssten wir dort nicht nur etwa halb so viele Tauschoperationen haben und zumindest minimal weniger Vergleiche – und dementsprechend eher die halbe Zeit als die doppelte?
Tausch- und Vergleichsoperationen im average und worst case
Um das zu prüfen, nutze ich das Programm CountOperations, um die Anzahl der verschiedenen Operationen anzeigen zu lassen. Hier sind die Ergebnisse für unsortierte und absteigend sortierte Elemente in einer Tabelle zusammengefasst:
| n | Tauschen unsortiert | Tauschen absteigend | Vergleiche unsortiert | Vergleiche absteigend |
|---|---|---|---|---|
| ... | ... | ... | ... | ... |
| 128 | 8.050 | 16.256 | 8.136 | 8.255 |
| 256 | 31.854 | 65.280 | 32.893 | 32.895 |
| 512 | 128.340 | 261.632 | 130.767 | 131.327 |
| 1.024 | 528.004 | 1.047.552 | 524.475 | 524.799 |
| 2.048 | 2.111.760 | 4.192.256 | 2.097.546 | 2.098.175 |
| ... | ... | ... | ... | ... |
Die Ergebnisse bestätigen die Annahme: Bei unsortierten Elementen haben wir etwa halb so viele Tauschoperationen und minimal weniger Vergleiche als bei absteigend sortierten Elementen.
Warum ist Bubble Sort auf x86 für absteigend sortierte Elemente schneller als für zufällig verteilte Elemente?
Wie kann es sein, dass Bubble Sort auf dem i7-12700H bei absteigend sortierten Elementen trotz doppelt so vieler Tauschoperationen so viel schneller ist als bei zufällig angeordneten Elementen?
Die Ursache für diese Diskrepanz ist in der Sprungvorhersage (englisch „branch prediction“) zu finden:
Wenn die Elemente absteigend sortiert sind, liefert der Vergleich if (left > right) innerhalb einer Iteration bei jedem Paar true.
Wenn die Sprungvorhersage davon ausgeht, dass das Ergebnis eines Vergleichs dasselbe ist wie das des vorangegangenen, liegt sie damit – mit einer einzigen Ausnahme pro Iteration: am Ende der inneren Schleife – immer richtig. Somit kann die Befehls-Pipeline der CPU die meiste Zeit voll ausgenutzt werden.
Bei unsortierten Daten hingegen können keine verlässlichen Vorhersagen über das Ergebnis des Vergleichs getroffen werden, so dass die Pipeline häufig gelöscht und neu gefüllt werden muss.
Belegen lässt sich das mit einer Variante von BubbleSortOpt1, die überhaupt keinen datenabhängigen Sprung enthält. Sie schreibt immer beide Elemente zurück und berechnet, statt zu entscheiden, welches davon nach links kommt:
int left = elements[i];
int right = elements[i + 1];
int mask = (right - left) >> 31; // -1 if right < left, else 0
int delta = (right - left) & mask;
elements[i] = left + delta;
elements[i + 1] = right - delta;
swapped |= mask;
Auf beiden Rechnern wächst die Laufzeit dieser Variante von 8.192 bis 131.072 Elementen pro Verdopplung um den Faktor 3,97 bis 4,03 – also exakt quadratisch –, und unsortierte Elemente brauchen genauso lange wie absteigend sortierte: 9,03 s gegenüber 9,07 s bei 131.072 Elementen auf dem i7-12700H und 10,60 s gegenüber 10,59 s auf dem M5 Pro. Ohne den Sprung verschwindet das Wachstum über n² hinaus, und mit ihm der Unterschied zwischen den beiden Eingabereihenfolgen. Die Rohdaten dieser Messung – je 10 Messdurchläufe nach zwei Warm-up-Durchläufen, JDK 27 – liegen im GitHub-Repository für den i7-12700H und den M5 Pro.
Auf dem i7-12700H ist die sprungfreie Variante bei unsortierten Elementen außerdem schneller als BubbleSortOpt1, bei 8.192 Elementen 1,28-mal so schnell und bei 131.072 Elementen 2,05-mal.
Und warum nicht auf dem Apple M5 Pro?
Auf dem M5 Pro sortiert BubbleSortOpt1 8.192 unsortierte Elemente in 18 ms – die sprungfreie Variante, die nie eine falsche Vorhersage bezahlen muss, braucht 41 ms. Würde der M5 Pro den Vergleich bei zufälligen Daten oft falsch vorhersagen, wäre BubbleSortOpt1 langsamer als sie, nicht mehr als doppelt so schnell. Er sagt ihn also meistens richtig voraus.
Bei kleinen Arrays dominieren auf dem M5 Pro daher die Tauschoperationen, und von denen gibt es bei absteigend sortierten Elementen doppelt so viele – deshalb brauchen diese bei 8.192 Elementen 2,50-mal so lange. Der i7-12700H zeigt denselben Effekt bei noch kleineren Arrays: Bei 2.048 und 4.096 Elementen brauchen absteigend sortierte Elemente dort 1,28- und 1,39-mal so lange wie unsortierte.
Je größer das Array, desto häufiger liegt die Vorhersage bei unsortierten Elementen daneben. Deshalb wächst ihre Laufzeit auch auf dem M5 Pro stärker als quadratisch – ab 16.384 Elementen sogar stärker als auf dem i7-12700H –, bis sie bei 131.072 Elementen etwas langsamer sind als absteigend sortierte. Bei dieser Größe ist die sprungfreie Variante auch auf dem M5 Pro 1,13-mal so schnell wie BubbleSortOpt1.
Die Messungen zeigen nicht, warum der M5 Pro die Vergleiche kleiner Arrays so gut vorhersagt.
Weitere Eigenschaften von Bubble Sort
In diesem Abschnitt geht es um die Platzkomplexität, Stabilität und Parallelisierbarkeit von Bubble Sort.
Platzkomplexität von Bubble Sort
Bubble Sort benötigt neben der Schleifenvariablen max und den Hilfsvariablen swapped, left und right keinen zusätzlichen Speicherplatz.
Die Platzkomplexität von Bubble Sort ist somit O(1).
Stabilität von Bubble Sort
Dadurch, dass immer zwei nebeneinander liegende Elemente miteinander verglichen werden – und diese nur dann vertauscht werden, wenn das linke Element größer ist als das rechte –, können Elemente mit gleichem Key niemals die Position relativ zueinander tauschen.
Dazu müssten, wie beispielsweise bei Selection Sort, zwei Elemente über mehr als eine Position hinweg ihre Plätze tauschen. Das kann hier nicht passieren.
Bubble Sort ist somit ein stabiler Sortieralgorithmus.
Parallelisierbarkeit von Bubble Sort
Es gibt zwei Ansätze, um Bubble Sort zu parallelisieren:
Ansatz 1 „Odd-even sort“
Man vergleicht parallel das erste mit dem zweiten Element, das dritte mit dem vierten, das fünfte mit dem sechsten, usw. und vertauscht die jeweiligen Elemente, wenn das linke größer ist als das rechte.
Danach vergleicht man das zweite Element mit dem dritten, das vierte mit dem fünften, das sechste mit dem siebten usw.
Diese zwei Schritte führt man abwechselnd durch, so lange, bis in beiden Schritten keine Elemente mehr vertauscht werden:
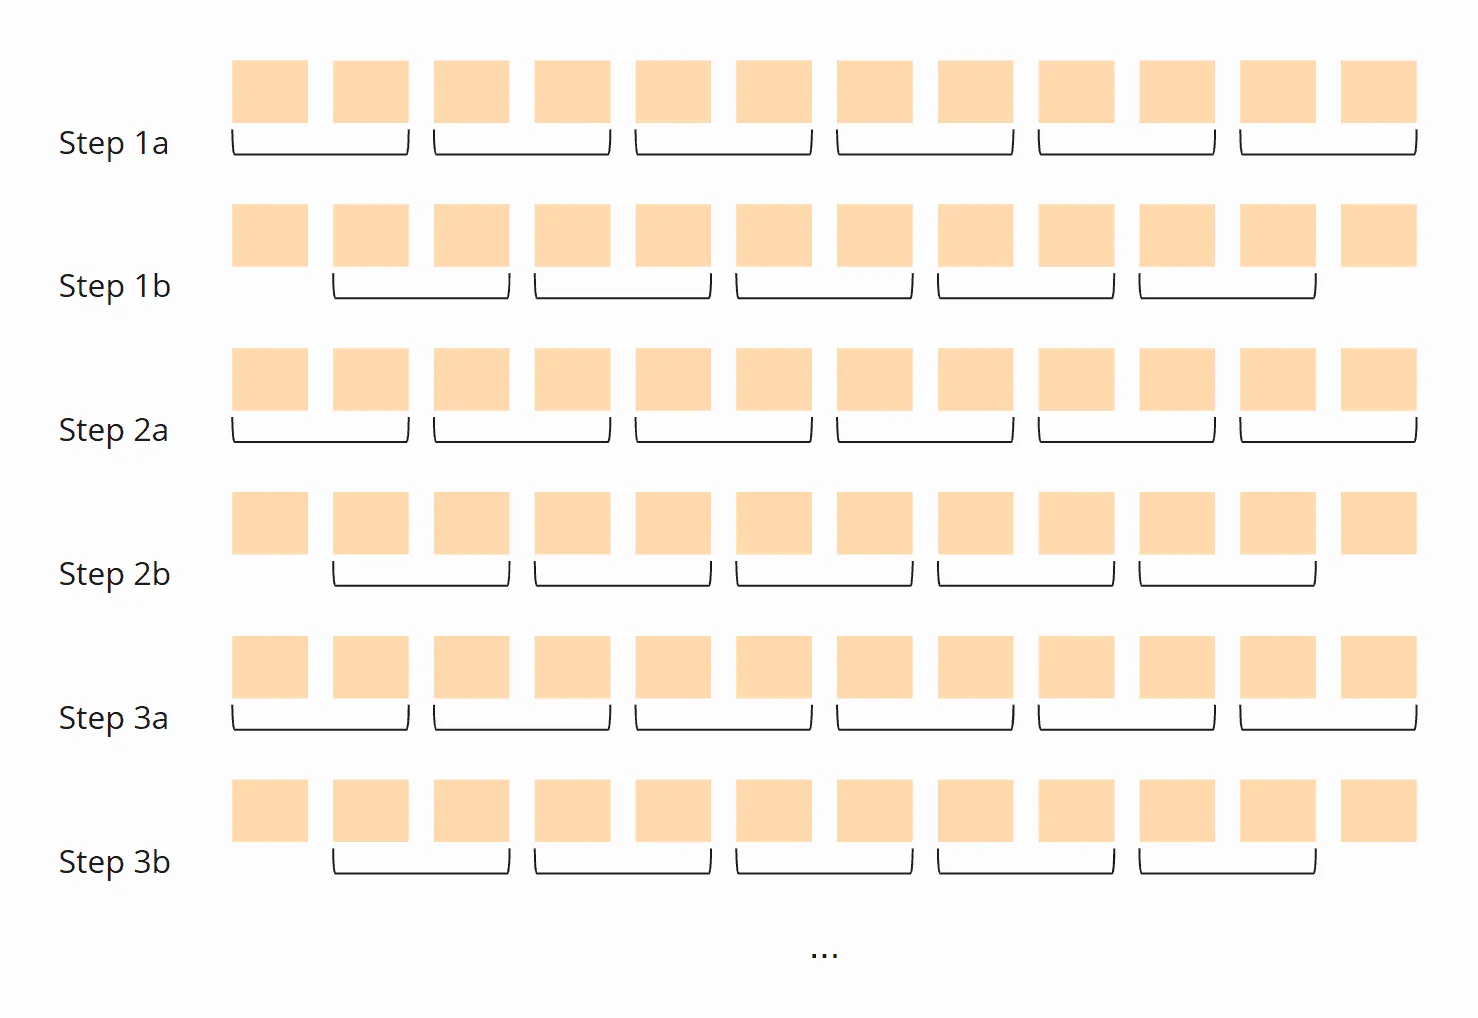
Diesen Algorithmus bezeichnet man auch als „Odd–even sort“.
Du findest den Quellcode in der Klasse BubbleSortParallelOddEven im GitHub-Repository.
Die Synchronisation zwischen den Schritten (die Threads dürfen mit einem Schritt erst dann beginnen, wenn alle Threads den vorherigen Schritt beendet haben) erfolgt dabei mit einem Phaser.
Ansatz 2 „Divide and Conquer“
Man teilt das zu sortierende Array in so viele Bereiche („Partitionen“), wie man Cores zur Verfügung hat.
Nun führt man eine Bubble-Sort-Iteration in allen Partitionen parallel durch. Man wartet, bis alle Threads fertig sind, und vergleicht dann jeweils das letzte Element einer Partition mit dem ersten der nächsten Partition. Wenn auch damit alle Threads fertig sind, beginnt der Vorgang von vorne.
Diese Schritte wiederholt man so lange, bis in allen Threads keine Elemente mehr vertauscht werden:
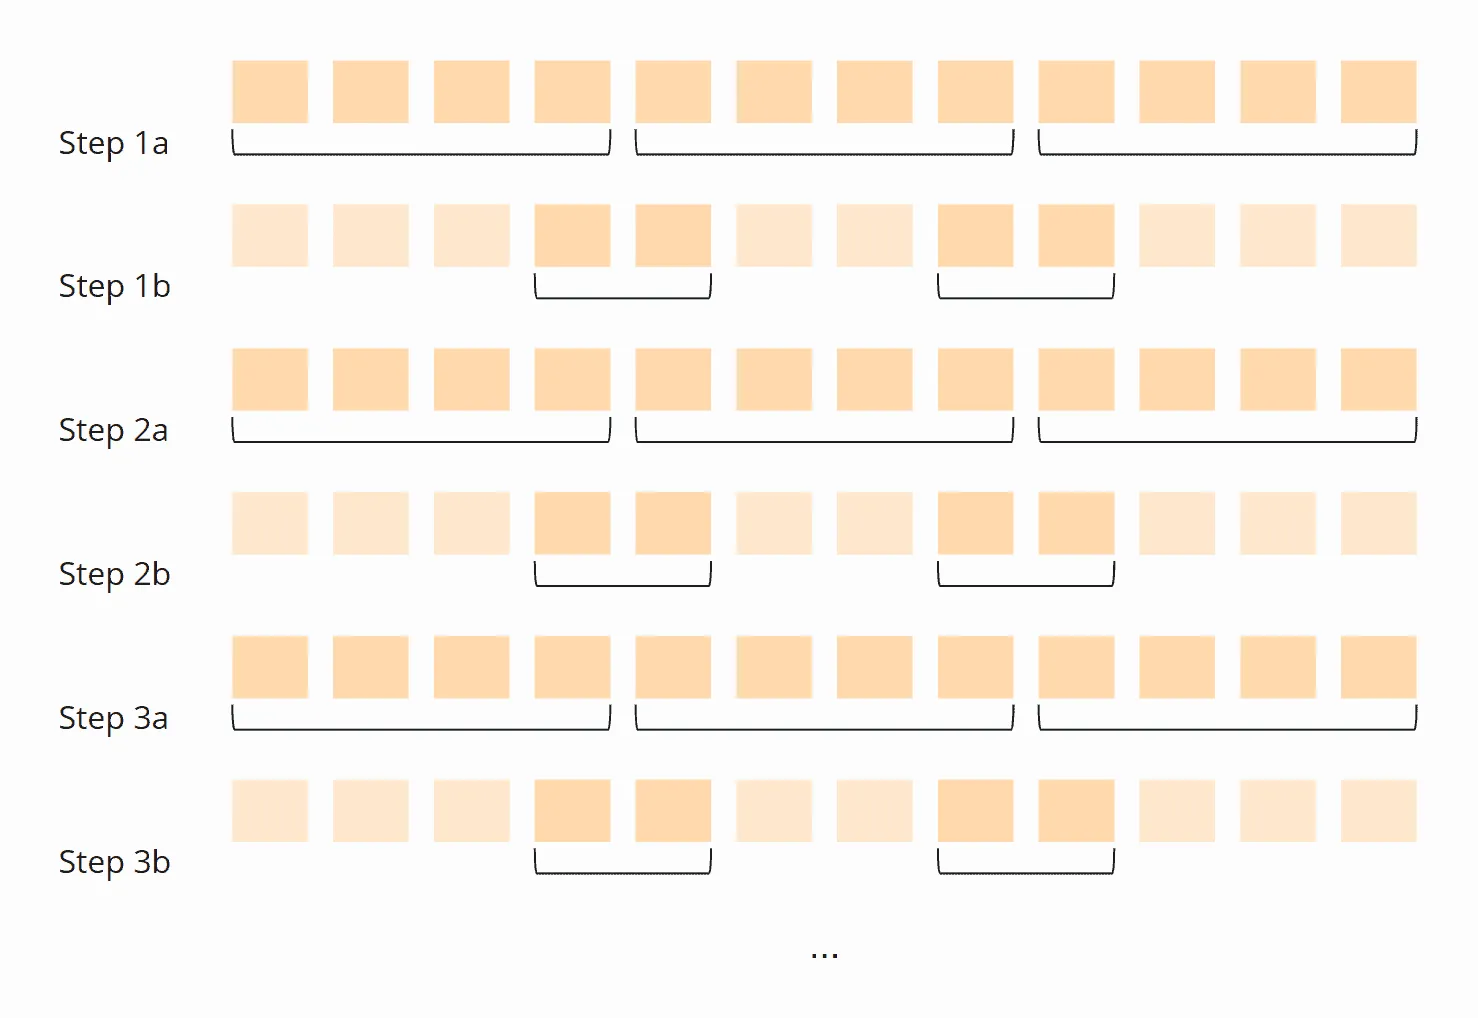
Du findest den Quellcode des Algorithmus in der Klasse BubbleSortParallelDivideAndConquer im GitHub-Repository.
Auch hier wird zur Synchronisation der Threads ein Phaser verwendet. Tatsächlich ist ein Großteil des Codes beider Algorithmen gleich, da auch für den Odd-Even-Ansatz das Array in Partitionen aufgeteilt wird. Den gemeinsamen Code habe ich in die abstrakte Basisklasse BubbleSortParallel verschoben.
Bubble Sort parallel: Performance
Die Performance der parallelen Varianten vergleiche ich mit dem oben bereits genannten Test CompareBubbleSorts, also mit 40.000 unsortierten Elementen. Hier das Ergebnis für die parallelen Algorithmen, verglichen mit BubbleSortOpt1, auf dem Intel Core i7-12700H:
----- Results after 100 iterations-----
BubbleSortOpt1                     -> fastest: 1,620.518 ms, median: 1,655.024 ms
BubbleSortParallelOddEven          -> fastest:   346.763 ms, median:   418.541 ms
BubbleSortParallelDivideAndConquer -> fastest:   705.699 ms, median:   812.285 ms
Und auf dem Apple M5 Pro:
----- Results after 100 iterations-----
BubbleSortOpt1                     -> fastest:   591.295 ms, median:   650.216 ms
BubbleSortParallelOddEven          -> fastest: 2,160.888 ms, median: 2,268.396 ms
BubbleSortParallelDivideAndConquer -> fastest: 4,289.005 ms, median: 4,486.726 ms
Die „odd-even“-Variante ist auf dem i7-12700H also 3,95-mal so schnell wie die sequenzielle Variante, der „divide-and-conquer“-Ansatz 2,04-mal. Drei Wiederholungen des Tests ergaben 3,99 bis 4,40 und 2,00 bis 2,17.
Auf dem M5 Pro sind beide parallelen Varianten langsamer als die sequenzielle: „odd-even“ braucht 3,49-mal so lange, „divide-and-conquer“ 6,90-mal.
Beide parallelen Varianten verwenden so viele Threads, wie die JVM Prozessoren meldet – 20 auf dem i7-12700H, 18 auf dem M5 Pro. Wie ihre Geschwindigkeit von dieser Zahl abhängt, zeigt eine zweite Messung, in der ich die Zahl der Prozessoren mit der JVM-Option -XX:ActiveProcessorCount begrenzt habe (Median aus 20 Messdurchläufen, Laufzeiten in Millisekunden):
| Prozessoren | Odd-even i7 | Odd-even M5 | D&C i7 | D&C M5 |
|---|---|---|---|---|
| 2 | 461 | 398 | 1.815 | 836 |
| 4 | 359 | 530 | 938 | 1.024 |
| 6 | 246 | 640 | 634 | 1.247 |
| 8 | 259 | 1.106 | 591 | 2.141 |
| 12 | 284 | 1.327 | 597 | 2.577 |
| 16 | 327 | 1.917 | 742 | 3.811 |
| 20 / 18 | 369 | 2.279 | 765 | 4.523 |
Das sequenzielle BubbleSortOpt1 braucht unabhängig von der Zahl der Prozessoren 1.644 bis 1.661 ms auf dem i7-12700H und 612 bis 643 ms auf dem M5 Pro.
Auf dem i7-12700H ist „odd-even“ mit 6 Prozessoren am schnellsten: 6,71-mal so schnell wie BubbleSortOpt1 – fast genau wie auf dem Laptop mit 6 Kernen aus der ersten Fassung dieses Artikels von 2020, wo es 6,6-mal so schnell war. Mit mehr Prozessoren wird es wieder langsamer.
Der „divide-and-conquer“-Ansatz ist bestenfalls 2,78-mal so schnell (mit 8 Prozessoren; 2020 war es 3,1-mal). Dies dürfte daran liegen, dass jeder Thread im zweiten Teilschritt der Iteration jeweils nur einen Vergleich durchführt. Demgegenüber steht ein relativ hoher Synchronisationsaufwand durch den Phaser.
Auf dem M5 Pro werden beide Varianten mit jedem zusätzlichen Thread langsamer. „Odd-even“ ist nur mit 2 und 4 Prozessoren schneller als BubbleSortOpt1, „divide-and-conquer“ nie. Jede Phase beider Algorithmen endet am Phaser, an dem alle Threads auf den langsamsten warten – und auf dem M5 Pro kostet dieses Warten umso mehr, je mehr Threads es aufhält.
Die Rohdaten dieser Messung liegen im GitHub-Repository für den i7-12700H und den M5 Pro.
Zusammenfassung
Bubble Sort ist ein einfach zu implementierender, stabiler Sortieralgorithmus mit einer Zeitkomplexität von O(n²) im average und worst case – und O(n) im best case.
In der Praxis spielt Bubble Sort keine Rolle: Für kleine Arrays ist Insertion Sort mit halb so vielen Vergleichen die bessere Wahl, für große sind es die effizienten Verfahren ab dem nächsten Teil.
Weitere Sortieralgorithmen findest du in dieser Übersicht aller Sortieralgorithmen und ihrer Eigenschaften im ersten Teil der Artikelserie.
Bubble Sort war das letzte einfache Sortierverfahren dieser Artikelserie; im nächsten Teil steigen wir mit Quicksort in die effizienten Sortierverfahren ein.
Wenn dir dieser Artikel gefallen hat, freue ich mich über eine Bewertung auf meinem ProvenExpert-Profil.